 AI Tracker
Artificial Analysis, iyileştirilmiş Humanity's Last Exam için HLE-Diamond liderlik tablosunu yayınladı
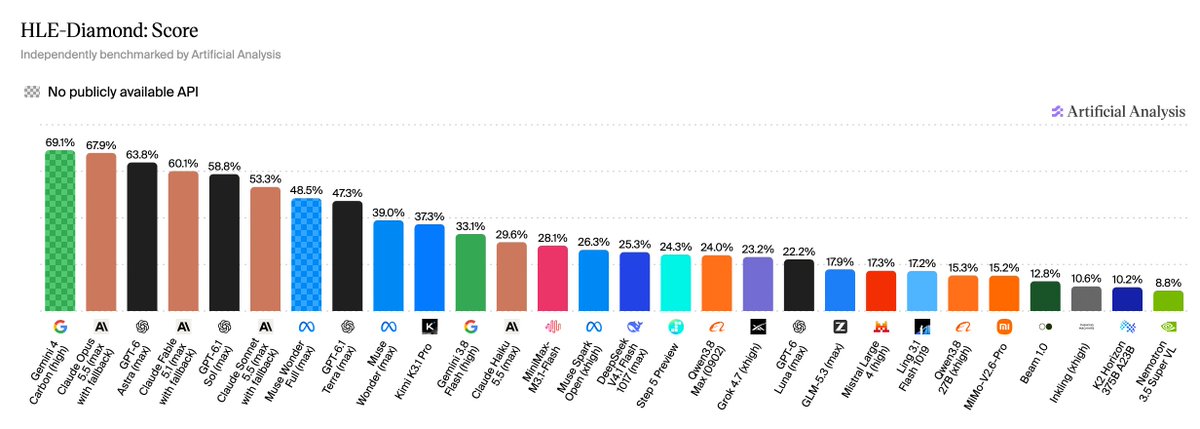
Artificial Analysis, Intelligence Index'in v5 sürümünün parçası olarak, Humanity's Last Exam'in iyileştirilmiş 1.000 soruluk sürümüne yönelik kendi değerlendirmesi olan HLE-Diamond liderlik tablosunu yayınladı. CAIS ve Scale AI, soruları bir yıl boyunca temizleyip iyileştirdikten sonra HLE-Diamond'ı yayımladı.
Bunlar Artificial Analysis'in kendi ölçümleri:
- HLE-Diamond, her soruyu akıl yürütme veya bilgi sorusu olarak etiketliyor. %50'nin üzerinde puan alan modeller, akıl yürütme sorularında bilgi sorularına kıyasla 16–35 puan daha yüksek sonuç alıyor. Liderler arasında iki kategori arasındaki farkın en geniş olduğu model GPT-6.1 Sol (max); akıl yürütmede %76, bilgide %41 puan alıyor.
- Daha yüksek efor ayarlarında puanlar da maliyet de artıyor. Claude Opus 5.5, düşük eforda %42'den maksimumda %68'e çıkarak görev başına maliyeti yaklaşık 35 katına yükseltiyor; GPT-6 Astra ise düşük eforda %45'ten maksimumda %64'e çıkarken görev başına maliyet 11 katına yükseliyor.
Her modelin puanları, token kullanımı ve görev başına maliyeti liderlik tablosunda yer alıyor.
Kaynaklar
Bu tür haberleri bildirim olarak alın.
Kullandığınız araçlarda bir şey değiştiğinde AI Tracker sizi uyarır.