AI Tracker
Multimodalność: wiadomości
dla twórców.
Najnowsze wiadomości z kategorii „Multimodalność” od każdego dostawcy AI: premiery, zmiany cen i wycofania, w skrócie i z tym, co oznaczają dla Ciebie.
Liquid AI wprowadza LFM3: sześć małych modeli do tekstu, obrazu, dźwięku i zastosowań omni
Liquid AI ogłosiło LFM3, nową generację modeli Liquid Foundation Models, opartą na — jak twierdzi firma — nowej architekturze tri-hybrydowej i wyposażoną w nowe enkodery multimodalne. Firma twierdzi, że architekturę zoptymalizowano pod kątem 14 klas procesorów obejmujących GPU, CPU i NPU, a modele można dostrajać na jednym GPU.Google DeepMind prezentuje Genie 4, interaktywny model świata działający w czasie rzeczywistym
Google DeepMind ogłosiło 27 października 2026 r. Genie 4, nazywając go swoim dotąd najbardziej realistycznym i interaktywnym modelem świata. W swoim wpisie DeepMind podaje, że użytkownicy mogą eksplorować dynamiczne środowiska w czasie rzeczywistym i obserwować, jak otoczenie reaguje i brzmi oraz jak poruszają się, reagują i mówią znajdujący się w nim ludzie. Firma opublikowała wpis na blogu „Genie 4: nowa generacja symulacji świata”.MAI-Image-2.7-Preview od Microsoftu zajmuje 2. miejsce w rankingu edycji obrazów Artificial Analysis
Według Artificial Analysis MAI-Image-2.7-Preview od Microsoft AI, najnowszy model do edycji obrazów i następca MAI-Image-2.6 (wydanego w sierpniu), zajmuje drugie miejsce w rankingu AA-Image-Editing v2.1, tuż za GPT Image 2.5 Sunburst (max) od OpenAI. Wyniki pochodzą z własnych testów Artificial Analysis.SenseTime reportedly open-sources SenseNova 6.8 Code2Video, a 27B code-to-video model
A Chinese AI blogger reports that SenseTime open-sourced SenseNova 6.8 Code2Video on October 27, with weights on Hugging Face under sensenova/SenseNova-6.8-Code2Video. The report is second-hand; SenseTime's own announcement is not cited.Maya-2, model głosowy dla języków Indii, został udostępniony z otwartymi wagami
Maya-2, model głosowy (syntezy mowy) przeznaczony dla Indii, został opublikowany z otwartymi wagami 27 października pod nazwą maya-research/maya2-native na Hugging Face. W ogłoszeniu na X podano, że model obsługuje ponad 1,5 miliarda ludzi ze wszystkich 28 stanów i 8 terytoriów związkowych.
Baidu udostępnia na licencji open source Unlimited OCR 2 — parser dokumentów o niemal stałym koszcie dekodowania
Baidu ogłosiło Unlimited OCR 2 na X 26 października; kod udostępniono na GitHubie, a wagi na Hugging Face. Model zaprojektowano do parsowania dokumentów praktycznie dowolnej długości w obrębie skończonego okna kontekstu.Artificial Analysis uruchamia Code2Video-AA, benchmark filmów marketingowych tworzonych za pomocą kodu
Artificial Analysis zaprezentowało Code2Video-AA, własną implementację Code2Video Bench firmy HeyGen, opracowaną we współpracy z HeyGen. Modele otrzymują 114 briefów marketingowych dotyczących produktów i marek i muszą odpowiedzieć na każdy z nich kompozycją HTML w HyperFrames w jednej odpowiedzi, bez użycia narzędzi; kompozycja jest renderowana do wideo bez dostępu do sieci. Model oceniający (Gemini 4 Argon, high) porównuje pary filmów pod kątem zaangażowania, zgodności z intencją promptu, kompozycji, spójności czasowej i jakości wykonania, a średnia ocen Elo z pięciu osi daje wynik główny. Ponad 35 000 werdyktów pozwoliło uszeregować 27 modeli. Wyniki pochodzą od Artificial Analysis.Dostrojona sieć CNN z 2015 r. lepiej rozpoznaje zmiany skórne niż GPT-6 Astra i Claude Fable 5.1 — informuje dermatolog
Dr Magnus Lynch, konsultant dermatologii w Guy's Hospital i King's College London, opublikował test GPT-6 Astra i Claude Fable 5.1 na 200 zmianach potwierdzonych biopsją i wylosowanych z publicznego zbioru danych MILK10k. Każdy model otrzymał zdjęcie kliniczne i obraz dermatoskopowy, ten sam prompt i ustawienia domyślne oraz wybierał spośród sześciu diagnoz. Modelem porównawczym był Inception v3 (opublikowany w 2015 r.), dostrojony na 68 011 obrazach z ISIC Archive na jednym GPU H100; zmiany użyte w teście wykluczono z danych treningowych.Moonshot wprowadza Kimi K3.1 Pro; otwarte wagi mają być dostępne do 4 listopada
Moonshot ogłosił Kimi K3.1 Pro, który określa jako swój najwydajniejszy model open-weight klasy 3T: multimodalny model typu mixture of experts z łączną liczbą 2,8T parametrów, 104B aktywnych parametrów i kontekstem o długości 1M tokenów. Według Moonshot K3.1 Pro i K3.1 Pro Highspeed (2–3× szybszy) są już dostępne w Kimi.ai, Kimi Work, Kimi Code i Kimi API (identyfikatory modeli: kimi-k3.1-pro i kimi-k3.1-pro-highspeed). Otwarte wagi mają zostać udostępnione do 4 listopada 2026 r.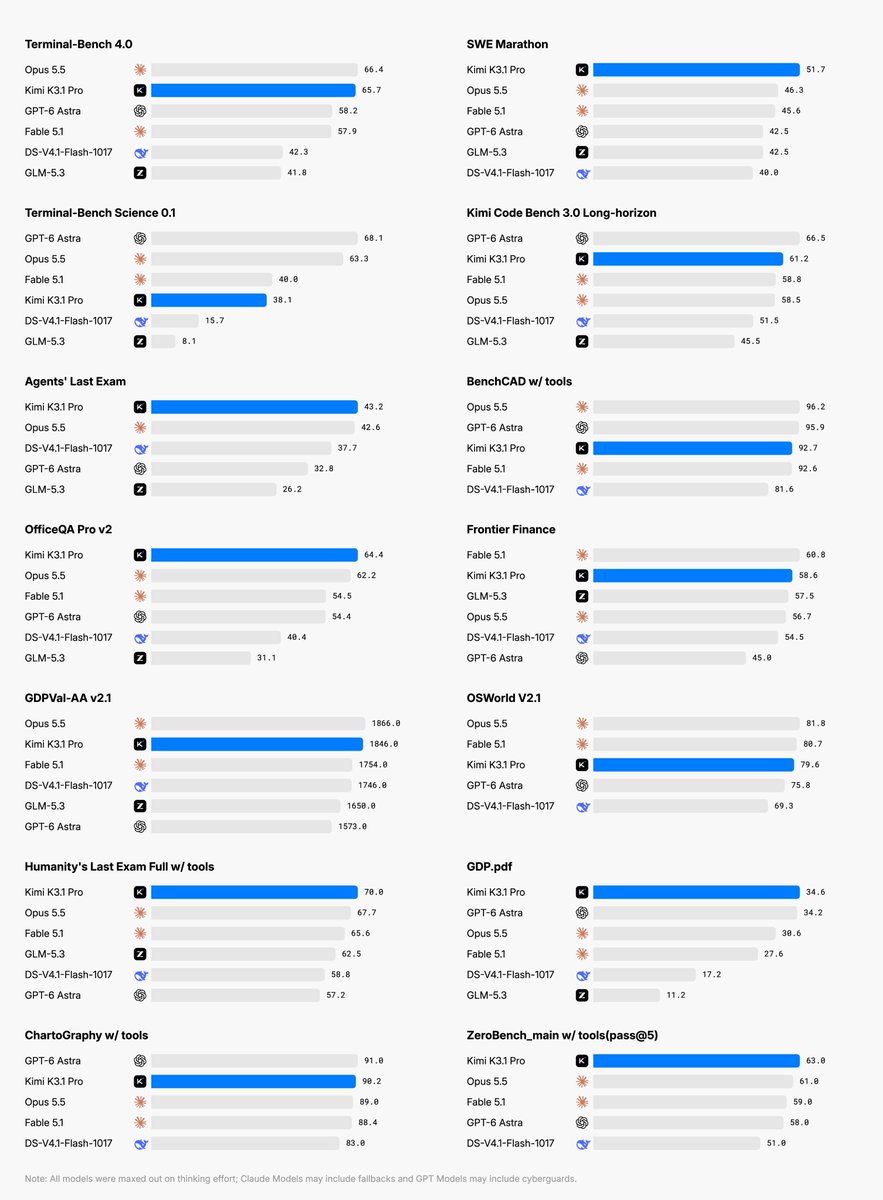
Block udostępnia wersję poglądową Dessa, modelu mowy typu speech-to-speech działającego w trybie full-duplex
Block, firma stojąca za Square i Cash App, udostępnił wersję badawczą Dessa, którą określa jako „najbardziej autentyczny model mowy full-duplex, jaki kiedykolwiek stworzono”. Z zapowiedzi Jacka Dorseya wynika, że rozmowa z modelem przypomina rozmowę z człowiekiem — z emocjami, niuansami, pauzami i naturalną intonacją.Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2 dodaje karty w czatach na komputerze i generowanie wideo
Grok Bot 0.75.2 jest już dostępny — wynika z wpisu na X opublikowanego przez członka zespołu Grok Bot, który zawiera link do listy zmian wydania na x.ai. Wpis wymienia trzy zmiany:Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.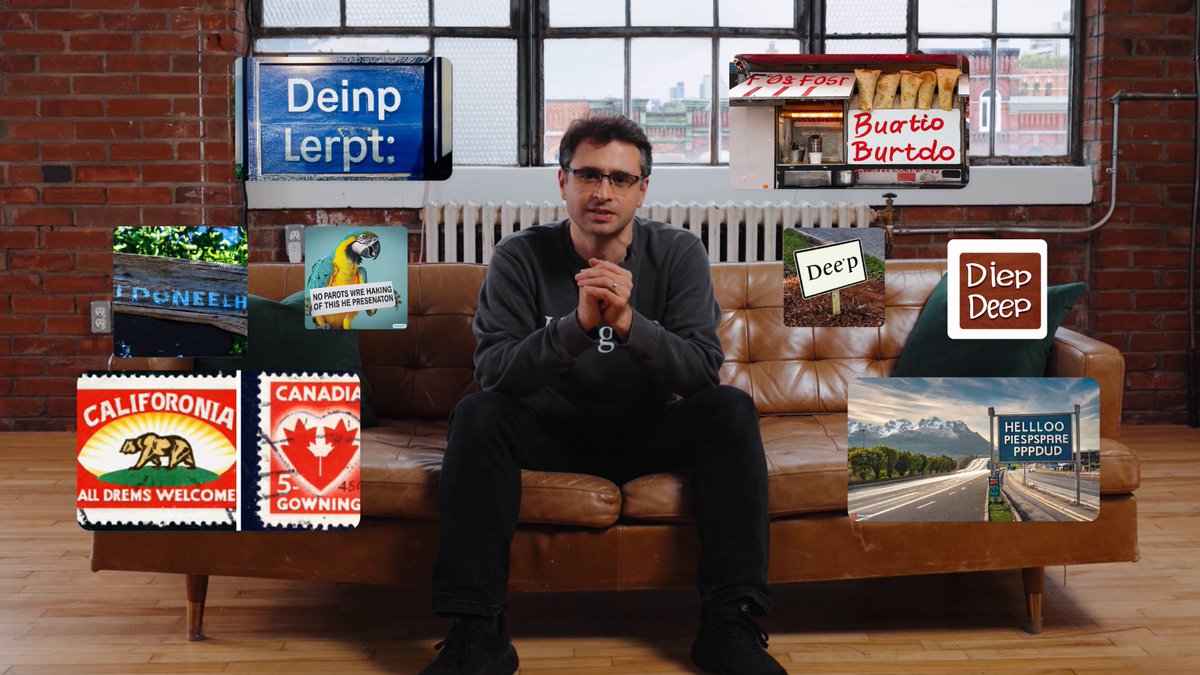
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.