 AI Tracker
Multimodalność: wiadomości
dla twórców.
Najnowsze wiadomości z kategorii „Multimodalność” od każdego dostawcy AI: premiery, zmiany cen i wycofania, w skrócie i z tym, co oznaczają dla Ciebie.
Hume uruchamia Audio Decision API, które odpowiada na pytania dotyczące dźwięku w jednym wywołaniu
Hume informuje, że Audio Decision API umożliwia programistom zadawanie pytań dotyczących dźwięku, na przykład o liczbę rozmówców, to, czy ktoś się śmieje, albo czy osoba dzwoniąca jest sfrustrowana. Według Hume API zastępuje pracę, do której wcześniej potrzeba było co najmniej 10 modeli.Meituan wypuszcza LongCat-2.5 — multimodalny model o 1,6 bln parametrów do zadań agentowych
Meituan wypuścił LongCat-2.5 — wynika z wpisu na X opublikowanego przez konto leo114119, które linkuje do bloga Meituan LongCat. Wpis podaje, że Meituan opisuje model jako natywnie multimodalny i przeznaczony do zadań agentowych, mający 1,6 bln parametrów oraz dobrze radzący sobie ze złożonymi projektami kodowania wizualnego i profesjonalną pracą biurową, taką jak projektowanie kreatywne, zadania 3D i analiza biznesowa.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex, lokalna aplikacja do wprowadzania tekstu głosem i rozmów z agentami kodującymi, doczekała się stabilnego wydania
Konto OpenCode poinformowało na X 31 października, że stabilne wydanie Hex jest już dostępne. Opisuje Hex jako szybki, działający lokalnie sposób na rozmowę głosową z dowolnym agentem, dostępny na Macu, Windowsie i Linuksie. W poście zamieszczono link do anoma.ly/hex.OpenCode 2.2.3 dodaje narzędzie do generowania obrazów
Konto OpenCode poinformowało 30 października na X, że OpenCode 2.2.3 zawiera narzędzie do generowania obrazów obsługujące modele graficzne OpenAI, Gemini, Grok i innych. Sugeruje używanie go do tworzenia koncepcji interfejsów użytkownika lub grafiki referencyjnej do gier wideo.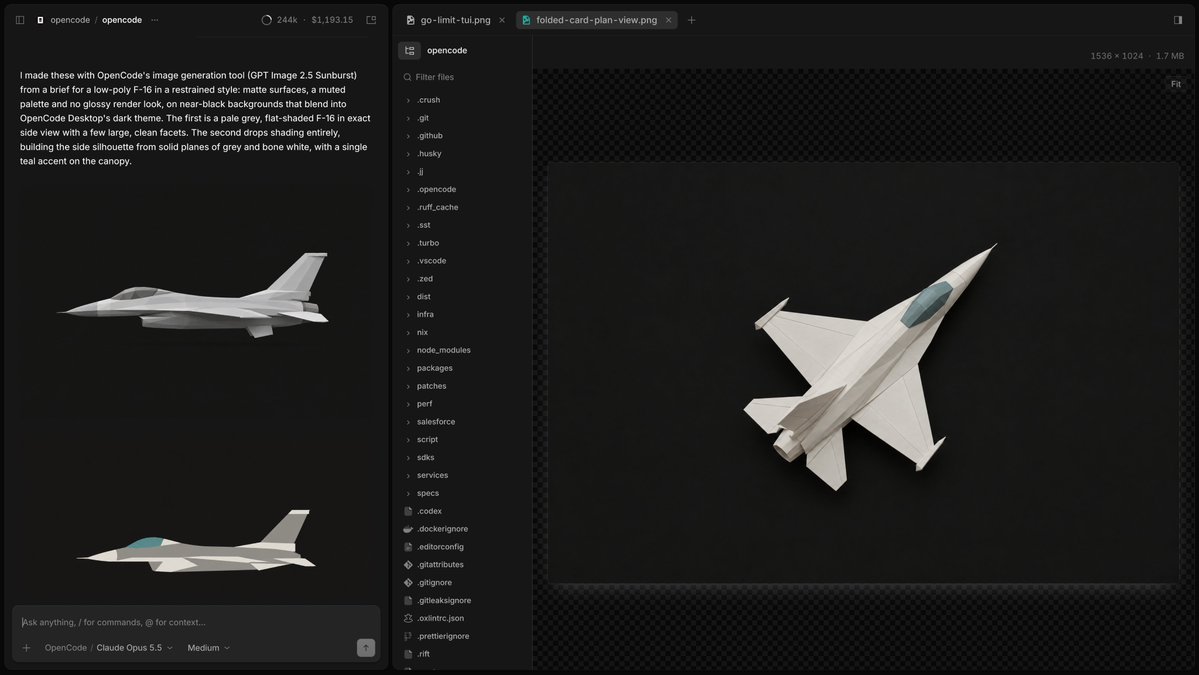
ElevenLabs udostępnia SFX v3 — model efektów dźwiękowych, który realizuje wieloczęściowe polecenia
ElevenLabs udostępniło SFX v3, swój najnowszy model efektów dźwiękowych. Firma twierdzi, że model tworzy bogatsze i precyzyjniejsze efekty dźwiękowe na podstawie pojedynczego polecenia tekstowego, bardziej niezawodnie realizuje kilka instrukcji zawartych w jednym poleceniu (przykład firmy: tłum wiwatuje, piłka spada, a potem tłum buczy) oraz lepiej radzi sobie z muzyką i wokalem.PokeBot uruchamia RoboAPI — API, które pozwala wydawać ramionom robotycznym polecenia w języku naturalnym
29 października PokeBot zaprezentował RoboAPI, oparte na Poke-Aurora, które firma określa mianem swojego modelu działań w świecie rzeczywistym. Według firmy zgodne roboty mogą przyjmować polecenia w języku naturalnym za pośrednictwem prostego API, bez trenowania pod kątem konkretnych zadań.Pika wprowadza H3 Flex — szybki model wideo, który według firmy jest najlepszym otwartym modelem text-to-video w DesignArena
Pika wprowadziła H3 Flex, który — jak twierdzi firma — debiutuje na 1. miejscu w rankingu modeli open-weight do generowania wideo z tekstu w DesignArena (twierdzenie Pika). Model ma być przeznaczony do profesjonalnej pracy iteracyjnej: oferuje możliwość eksportowania osobnych ścieżek audio, rozdzielczość do 4K i generowanie szybsze niż w czasie rzeczywistym; klip o długości 15 sekund wraz ze ścieżką dźwiękową może powstać zaledwie w 7 sekund.Phonic 1 debiutuje na 1. miejscu w Speech to Speech Index serwisu Artificial Analysis
Artificial Analysis (serwis benchmarkowy, własne pomiary) podaje, że Phonic 1 (High), model speech-to-speech firmy Phonic, zajmuje 1. miejsce na 22 modele w jego Speech to Speech Index z wynikiem 87,1, nieznacznie wyprzedzając Grok Voice 3.0 (86,9). Model jest dostępny przez Phonic API w cenie 0,07 USD za minutę.Fish Audio wypuszcza Drama 3, który Artificial Analysis plasuje na 1. miejscu wśród modeli mowy z otwartymi wagami
Fish Audio wypuściło Drama 3, którego wagi są dostępne na Hugging Face. Artificial Analysis (serwis benchmarkowy, bazujący na własnych pomiarach) podaje, że to model z otwartymi wagami zajmujący 1. miejsce na obu ich arenach modeli mowy oraz 1. miejsce wśród wszystkich modeli w benchmarku Pronunciation Robustness.Artificial Analysis prezentuje AA-Robotics v0.1 — benchmark modeli sterujących ramieniem robota
Artificial Analysis opublikowało AA-Robotics v0.1, benchmark, w którym modele sterują ramieniem robota, a zadanie pokazane jest z perspektywy modelu. W przykładzie, w którym ten sam robot pisze „hello world”, Artificial Analysis podaje, że Claude Opus 5.5 wypisał tekst, stawiając kropkę po kropce, wykonując 3 270 ruchów ramieniem w ciągu 34 minut, podczas gdy GPT-6 Astra napisał go ciągłymi pociągnięciami, wykonując 514 ruchów w 13 minut.ElevenLabs przedstawia Cue, model do wymuszonego wyrównywania
Zespół badawczy ElevenLabs przedstawił Cue, model do wymuszonego wyrównywania — etap, który przekształca transkrypcję w znaczniki czasu wykorzystywane w napisach, dubbingu i transkrypcjach z klikalnymi fragmentami. Przypisuje każdy znak do osi czasu nagrania.Rime wprowadza Prism, model speech-to-speech dla agentów głosowych
Rime wprowadziło Prism, model speech-to-speech dla głosowych agentów AI. Poniższe dane to deklaracje Rime, a nie wyniki niezależnych pomiarów.Artificial Analysis uruchamia AA-Video-I2V v2.1, benchmark modeli image-to-video
Artificial Analysis uruchomiła AA-Video-I2V v2.1 i AA-Video-I2V-Silent v2.1 — benchmark modeli image-to-video. Każdy prompt łączy obraz początkowy w rozdzielczości 1080p z przygotowanym dla niego promptem i jest oznaczony kategorią zastosowania, możliwości oraz stylu wizualnego; modele są oceniane w rozdzielczości do 1080p i klasyfikowane w 10 kategoriach zastosowań oraz 10 kategoriach możliwości. W rankingu ogólnym próbki są równomiernie dobierane z tych kategorii. Wyniki pochodzą od Artificial Analysis.
OpenBMB wydaje MiniCPM-OCR, parser dokumentów 1B, oraz model 2B oceniający wyniki OCR
28 października OpenBMB pokazało MiniCPM-OCR na X, działający lokalnie na iPhonie i iPadzie. Model udostępniono z otwartymi wagami; można go uruchamiać za pomocą llama.cpp, vLLM, SGLang lub Ollama. Kod do dostrajania jest open source, a OpenBMB udostępnia również demo i API.AssemblyAI wprowadza swój pierwszy model zamiany tekstu na mowę — AssemblyAI-TTS-1
AssemblyAI wprowadziło AssemblyAI-TTS-1, swój pierwszy model zamiany tekstu na mowę, stworzony z myślą o agentach głosowych. Firma podaje, że model strumieniuje dźwięk z opóźnieniem 90 ms i kosztuje 15 USD za milion znaków. AssemblyAI określa go jako najlepszy model TTS, który można uruchomić na dużą skalę, biorąc pod uwagę jednocześnie dokładność, naturalność i koszt. OpenRouter informuje, że model jest już dostępny na tej platformie, gdzie obsługuje ponad 4000 głosów z USA lub UE.