AI Tracker
Çok modlu:
geliştiriciler için haberler.
Tüm AI sağlayıcılarından "Çok modlu" konusundaki son haberler: lansmanlar, fiyat değişiklikleri ve kullanımdan kaldırmalar; sizin için ne anlama geldikleriyle özetlenmiş.
Liquid AI, metin, görsel, ses ve omni alanlarında altı küçük modelden oluşan LFM3’ü tanıttı
Liquid AI, yeni bir tri-hybrid mimari ve çok modlu kodlayıcılarla geliştirilen Liquid Foundation Models ailesinin yeni nesli LFM3’ü duyurdu. Şirket, mimarinin GPU, CPU ve NPU’ları kapsayan 14 işlemci sınıfı için optimize edildiğini ve modellerin tek bir GPU’da ince ayarının yapılabildiğini söylüyor.Google DeepMind, gerçek zamanlı etkileşimli dünya modeli Genie 4’ü tanıttı
Google DeepMind, 27 Ekim 2026’da Genie 4’ü duyurarak bunun şimdiye kadarki en gerçekçi ve etkileşimli dünya modeli olduğunu söyledi. DeepMind, paylaşımında kullanıcıların dinamik ortamları gerçek zamanlı keşfedebileceğini; sahnenin nasıl tepki verdiğini, nasıl ses çıkardığını ve içindeki kişilerin nasıl hareket edip tepki verdiğini ve konuştuğunu görebileceğini belirtiyor. “Genie 4: yeni bir dünya simülasyonu nesli” başlıklı bir blog yazısı yayımladı.Microsoft'un MAI-Image-2.7-Preview modeli, Artificial Analysis'ın görsel düzenleme sıralamasında 2. oldu
Artificial Analysis'a göre, Microsoft AI'ın en yeni görsel düzenleme modeli ve ağustosta yayımlanan MAI-Image-2.6'nın halefi MAI-Image-2.7-Preview, AA-Image-Editing v2.1 sıralamasında ikinci sıraya yerleşti ve OpenAI'ın GPT Image 2.5 Sunburst (max) modelinin hemen arkasında kaldı. Sonuçlar, Artificial Analysis'ın kendi değerlendirmesine dayanıyor.SenseTime reportedly open-sources SenseNova 6.8 Code2Video, a 27B code-to-video model
A Chinese AI blogger reports that SenseTime open-sourced SenseNova 6.8 Code2Video on October 27, with weights on Hugging Face under sensenova/SenseNova-6.8-Code2Video. The report is second-hand; SenseTime's own announcement is not cited.Hintçe dilleri için bir ses modeli olan Maya-2, açık ağırlıklarla yayımlandı
Hindistan'ı hedefleyen bir ses (konuşma sentezi) modeli olan Maya-2, 27 Ekim'de Hugging Face'te maya-research/maya2-native adıyla açık ağırlıklarla yayımlandı. X'teki duyuruda modelin, 28 eyaletin ve 8 birlik bölgesinin tamamında 1,5 milyardan fazla kişiye hitap ettiği belirtiliyor.
Baidu, kod çözme maliyeti neredeyse sabit olan bir belge ayrıştırıcısı Unlimited OCR 2'yi açık kaynak olarak yayımladı
Baidu, 26 Ekim'de X'te Unlimited OCR 2'yi duyurdu; kod GitHub'da, ağırlıklar ise Hugging Face'te. Model, sonlu bir bağlam penceresinde neredeyse her uzunluktaki belgeyi ayrıştırmak üzere tasarlandı.Artificial Analysis, kodla oluşturulan pazarlama videoları için bir benchmark olan Code2Video-AA'yı kullanıma sunuyor
Artificial Analysis, HeyGen ile ortaklaşa geliştirdiği ve HeyGen'in Code2Video Bench'inin kendi uygulaması olan Code2Video-AA'yı tanıttı. Modellere 114 ürün ve marka pazarlama brief'i veriliyor; her birine araç kullanmadan, tek bir yanıtta HyperFrames HTML kompozisyonuyla karşılık vermeleri gerekiyor. Kompozisyon, ağ erişimi olmadan videoya dönüştürülüyor. Bir değerlendirici model (Gemini 4 Argon, high), videoları etkileşim, istemin amacına uygunluk, kompozisyon, zamansal tutarlılık ve işçilik açısından ikili olarak karşılaştırıyor; beş eksendeki Elo puanlarının ortalaması da genel puanı oluşturuyor. 35.000'den fazla değerlendirme, 27 modeli sıralıyor. Sonuçlar Artificial Analysis'in kendi sonuçlarıdır.İnce ayar yapılmış 2015 tarihli bir CNN, cilt lezyonlarını adlandırmada GPT-6 Astra ve Claude Fable 5.1'i geride bıraktı; bir dermatolog bildirdi
Guy's Hospital ve King's College London'da danışman dermatolog olan Dr Magnus Lynch, kamuya açık MILK10k veri kümesinden rastgele seçilen ve biyopsiyle doğrulanmış 200 lezyon üzerinde GPT-6 Astra ve Claude Fable 5.1'i test etti. Her modele bir klinik fotoğraf ve bir dermoskopik görüntü verildi; aynı istem ve varsayılan ayarlar kullanıldı ve modeller altı tanı arasından seçim yaptı. Karşılaştırma modeli, bir H100 GPU'da ISIC Archive'dan alınan 68.011 görüntüyle ince ayar yapılmış Inception v3'tü (2015'te yayımlandı); test lezyonları eğitim verilerinden çıkarılmıştı.Moonshot, Kimi K3.1 Pro'yu tanıttı; açık ağırlıkların 4 Kasım'a kadar yayımlanması bekleniyor
Moonshot, kendi ifadesiyle şimdiye kadarki en yetenekli 3T sınıfı açık ağırlıklı modeli olan Kimi K3.1 Pro'yu duyurdu: toplam 2,8T, etkin 104B parametreye ve 1 milyon tokenlık bağlama sahip çok modlu bir uzman-karışımı modeli. Moonshot'a göre K3.1 Pro ve K3.1 Pro Highspeed (2–3× daha hızlı) Kimi.ai, Kimi Work, Kimi Code ve Kimi API'de kullanıma sunuldu (model kimlikleri: kimi-k3.1-pro ve kimi-k3.1-pro-highspeed). Açık ağırlıkların 4 Kasım 2026'ya kadar yayımlanması taahhüt ediliyor.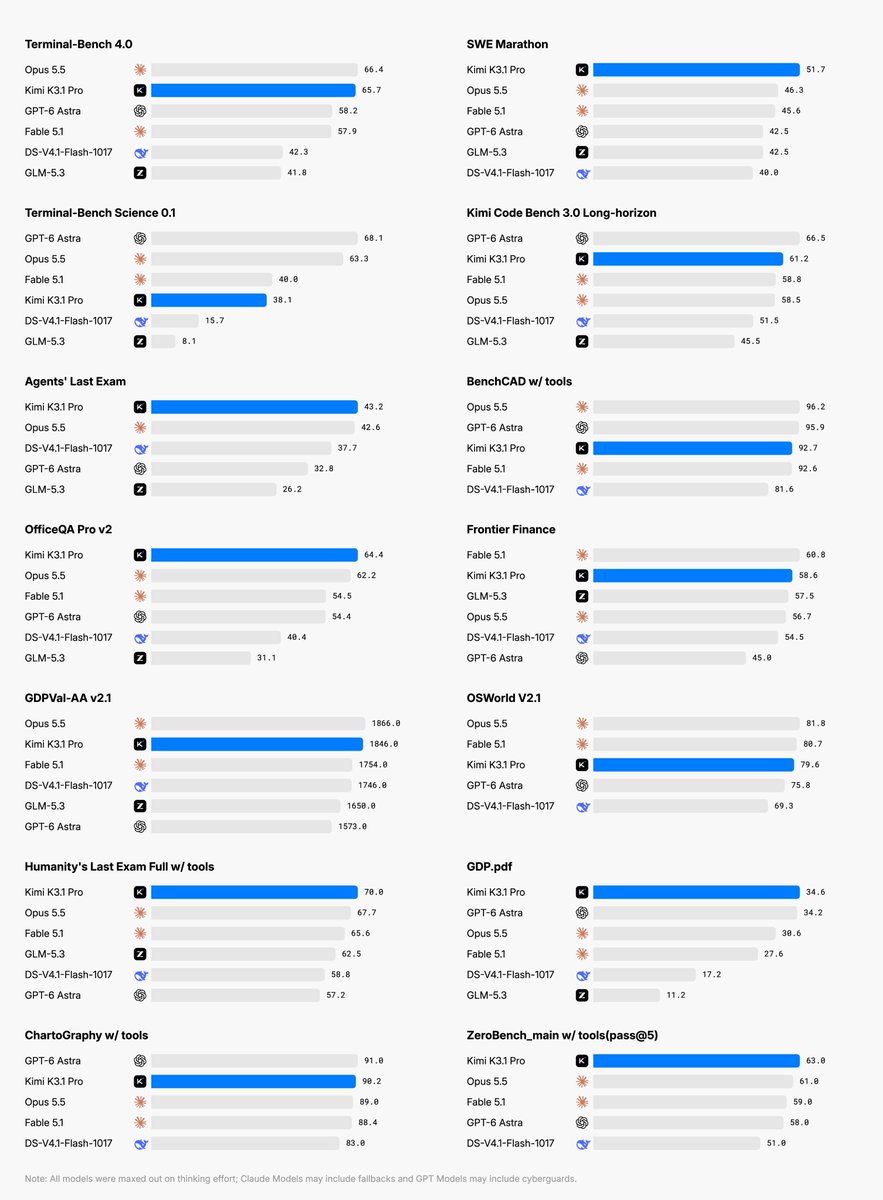
Block, tam çift yönlü konuşmadan konuşmaya modeli Dessa’nın önizlemesini duyurdu
Square ve Cash App’in arkasındaki şirket Block, kendi ifadesiyle “şimdiye kadar geliştirilmiş en gerçekçi tam çift yönlü konuşma modeli” olan Dessa’nın araştırma önizlemesini tanıttı. Jack Dorsey’in duyurusuna göre modelle konuşmak; duygu, incelik, duraksamalar ve doğal bir ritimle bir insanla konuşmaya benziyor.Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2, masaüstü sohbetlerine kartlar ve video oluşturma özelliği ekliyor
Grok Bot 0.75.2 yayımlandı. Grok Bot ekibinden bir üyenin X'teki paylaşımına göre, paylaşımda x.ai üzerindeki sürüm değişiklik günlüğüne bağlantı veriliyor. Paylaşımda üç değişiklik sıralanıyor:Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.