 AI Tracker
Çok modlu:
geliştiriciler için haberler.
Tüm AI sağlayıcılarından "Çok modlu" konusundaki son haberler: lansmanlar, fiyat değişiklikleri ve kullanımdan kaldırmalar; sizin için ne anlama geldikleriyle özetlenmiş.
Hume, ses hakkındaki soruları tek çağrıda yanıtlayan Audio Decision API’yi kullanıma sunuyor
Hume, Audio Decision API’nin geliştiricilerin ses hakkında konuşmacı sayısı, birinin gülüp gülmediği veya arayan kişinin hayal kırıklığına uğrayıp uğramadığı gibi sorular sormasına olanak tanıdığını söylüyor. Hume’a göre bu API, daha önce 10 veya daha fazla model gerektiren işlerin yerini alıyor.Meituan, agent görevleri için 1,6T parametreli çok modlu LongCat-2.5’i piyasaya sürüyor
Meituan, hesabı leo114119’un Meituan’ın LongCat bloguna bağlantı veren X paylaşımına göre LongCat-2.5’i piyasaya sürdü. Paylaşımda Meituan’ın modeli, agent görevleri için geliştirilmiş yerel çok modlu bir model olarak tanımladığı; 1,6 trilyon parametreye sahip olduğunu ve karmaşık görsel kodlama projeleri ile yaratıcı tasarım, 3D görevleri ve iş analizi gibi profesyonel ofis işlerinde güçlü olduğunu belirttiği aktarılıyor.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex, kodlama ajanlarıyla konuşmak için yerel bir sesli giriş uygulaması olarak kararlı sürüme ulaştı
OpenCode hesabı, 31 Ekim’de X’te Hex’in kararlı sürümünün kullanıma sunulduğunu duyurdu. Hex’i hızlı çalışan, yerel olarak çalıştırılan ve Mac, Windows ile Linux’ta kullanılabilen, herhangi bir ajanla sesli konuşma yolu olarak tanımlıyor. Gönderide anoma.ly/hex bağlantısı yer alıyor.OpenCode 2.2.3, görsel oluşturma aracı ekliyor
OpenCode hesabı, 30 Ekim'de X'te yaptığı açıklamada OpenCode 2.2.3'ün OpenAI, Gemini, Grok ve diğerlerinin görsel modellerini destekleyen bir görsel oluşturma aracına sahip olduğunu söyledi. Aracın konsept arayüzler veya video oyunları için referans görseller oluşturmakta kullanılmasını öneriyor.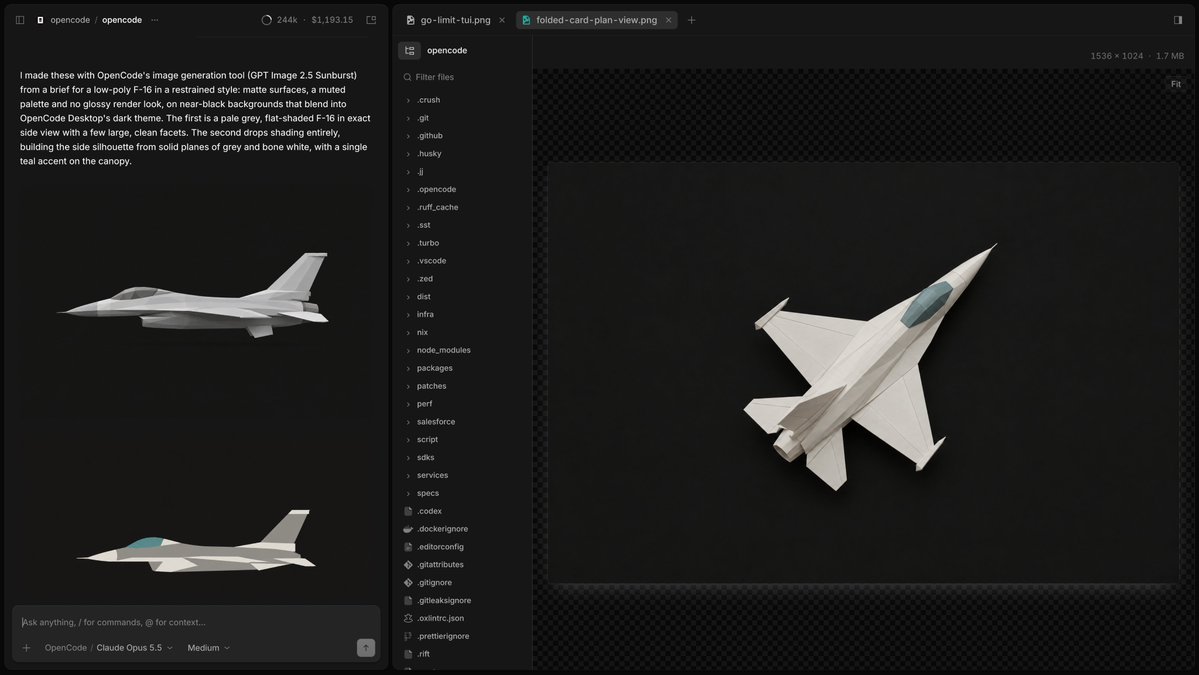
ElevenLabs, çok parçalı istemleri izleyebilen ses efektleri modeli SFX v3'ü yayınladı
ElevenLabs, en yeni ses efektleri modeli SFX v3'ü yayınladı. Şirket, modelin tek bir metin isteminden daha zengin ve daha hassas ses efektleri oluşturduğunu, tek bir istemdeki birden fazla talimatı daha güvenilir biçimde izlediğini (örneği: tezahürat yapan bir kalabalık, yere düşen bir top, ardından yuhalayan bir kalabalık) ve müzik ile vokal performansının iyileştirildiğini söylüyor.PokeBot, robot kollara doğal dilde talimatlar veren RoboAPI’yi kullanıma sundu
PokeBot, kendi dünya-eylem modeli olarak adlandırdığı Poke-Aurora ile güçlendirilen RoboAPI’yi 29 Ekim’de tanıttı. Şirket, uyumlu robotların göreve özel eğitim olmadan basit bir API üzerinden doğal dilde talimatlar alabildiğini söylüyor.Pika, DesignArena’da en iyi açık ağırlıklı metinden videoya model olduğunu söylediği hızlı video modeli H3 Flex’i kullanıma sundu
Pika, DesignArena’nın metinden videoya sıralamasında 1 numaralı açık ağırlıklı model olarak ilk kez görücüye çıktığını söylediği H3 Flex’i tanıttı (Pika’nın iddiası). Modeli profesyonel düzenleme süreçleri için tasarlanmış olarak tanımlıyor: dışa aktarılabilir ses kanalları, 4K’ya kadar çözünürlük ve gerçek zamandan hızlı üretim; 15 saniyelik bir klip ve müzik, yalnızca 7 saniyede oluşturulabiliyor.Phonic 1, Artificial Analysis'ın Speech to Speech Index'inde 1 numaradan giriş yaptı
Artificial Analysis (kendi ölçümlerini kullanan bir kıyaslama sitesi), Phonic'in konuşmadan konuşmaya modeli Phonic 1 (High)'ın Speech to Speech Index'inde 22 model arasında 87,1 puanla 1. sırada yer aldığını ve Grok Voice 3.0'ı (86,9) az farkla geride bıraktığını söylüyor. Model, Phonic API üzerinden dakika başına 0,07 $ karşılığında kullanılabiliyor.Fish Audio, Artificial Analysis'ın açık ağırlıklı konuşma modelleri arasında 1. sıraya koyduğu Drama 3'ü piyasaya sürdü
Fish Audio, ağırlıkları Hugging Face'te bulunan Drama 3'ü piyasaya sürdü. Bir kıyaslama sitesi olan Artificial Analysis, kendi ölçümlerine göre modelin her iki konuşma arenasında da açık ağırlıklı modeller arasında 1. sırada, Pronunciation Robustness kıyaslamasında ise tüm modeller arasında 1. sırada olduğunu söylüyor.Artificial Analysis, bir robot kolunu kontrol eden modelleri kıyaslayan AA-Robotics v0.1’i tanıttı
Artificial Analysis, modellere bir robot kolunu kontrol ettiren ve görevi modelin bakış açısından gösteren AA-Robotics v0.1’i yayımladı. Aynı robotun "hello world" yazdığı bir örnekte Artificial Analysis, Claude Opus 5.5’in yazıyı nokta nokta karalayarak oluşturduğunu; 34 dakikada 3.270 kol hareketi yaptığını söylüyor. GPT-6 Astra ise kesintisiz çizgilerle yazdı; 13 dakikada 514 hareket yaptı.ElevenLabs, zorunlu hizalama modeli Cue'yu tanıttı
ElevenLabs Research, transkripti zaman damgalarına dönüştüren adım olan Cue adlı zorunlu hizalama modelini tanıttı. Altyazılar, dublaj ve tıklanabilir transkriptler için kullanılan model, her karakteri ses zaman çizelgesine yerleştiriyor.Rime, sesli asistanlar için konuşmadan konuşmaya model Prism’i tanıttı
Rime, yapay zekâ destekli sesli asistanlar için konuşmadan konuşmaya bir model olan Prism’i kullanıma sundu. Aşağıdaki veriler bağımsız olarak ölçülmüş sonuçlar değil, Rime’ın kendi iddialarıdır.Artificial Analysis, görüntüden videoya modeller için AA-Video-I2V v2.1 benchmark’ını kullanıma sunuyor
Artificial Analysis, görüntüden videoya modeller için bir benchmark olan AA-Video-I2V v2.1 ve AA-Video-I2V-Silent v2.1’i kullanıma sundu. Her istem, ona özel yazılmış bir istemle eşleştirilmiş 1080p başlangıç görselinden oluşuyor ve kullanım senaryosu, yetenek ve görsel stile göre etiketleniyor; modeller 1080p’ye kadar değerlendiriliyor ve 10 kullanım senaryosu ile 10 yetenek genelinde sıralanıyor. Genel sıralamada bu kategorilere eşit ağırlık veriliyor. Sonuçlar Artificial Analysis’in kendi sonuçlarıdır.
OpenBMB, OCR sonuçlarını puanlayan 2B modelle birlikte 1B boyutunda bir belge ayrıştırıcısı olan MiniCPM-OCR'ı piyasaya sürüyor
OpenBMB, 28 Ekim'de X'te MiniCPM-OCR'ı iPhone ve iPad'de yerel olarak çalışırken gösterdi. Model açık ağırlıklarla sunuluyor ve llama.cpp, vLLM, SGLang veya Ollama ile çalıştırılabiliyor; ince ayar kodu açık kaynaklı ve OpenBMB ayrıca bir demo ve API sunuyor.AssemblyAI, ilk metinden konuşmaya modeli AssemblyAI-TTS-1'i piyasaya sürdü
AssemblyAI, sesli ajanlar için geliştirdiği ilk metinden konuşmaya modeli AssemblyAI-TTS-1'i piyasaya sürdü. Şirket, modelin 90 ms’de akış sağladığını ve milyon karakter başına $15 ücretlendirdiğini söylüyor; doğruluk, doğallık ve maliyeti birlikte değerlendirdiğinde ölçekli kullanıma uygun en iyi TTS modeli olduğunu belirtiyor. OpenRouter, modelin platformda kullanıma sunulduğunu ve ABD veya AB’den sunulan 4.000’den fazla ses seçeneği içerdiğini söylüyor.