 AI Tracker
Tin đa phương thức,
cho nhà phát triển.
Tin mới nhất về đa phương thức từ mọi nhà cung cấp AI: ra mắt, thay đổi giá và ngừng hỗ trợ, tóm tắt kèm ý nghĩa với bạn.
Hume ra mắt Audio Decision API, trả lời câu hỏi về âm thanh chỉ trong một lần gọi
Hume cho biết Audio Decision API cho phép nhà phát triển đặt câu hỏi về âm thanh, chẳng hạn có bao nhiêu người nói, có ai đang cười hay người gọi có đang bực bội hay không. Hume cho biết API này thay thế công việc trước đây cần đến 10 mô hình trở lên.Meituan ra mắt LongCat-2.5, mô hình đa phương thức 1,6T tham số dành cho các tác vụ agent
Meituan đã ra mắt LongCat-2.5, theo một bài đăng trên X của tài khoản leo114119 dẫn liên kết đến blog LongCat của Meituan. Bài đăng cho biết Meituan mô tả đây là mô hình đa phương thức nguyên bản được xây dựng cho các tác vụ agent, có 1,6 nghìn tỷ tham số và hoạt động tốt trong các dự án lập trình trực quan phức tạp cũng như công việc văn phòng chuyên nghiệp như thiết kế sáng tạo, tác vụ 3D và phân tích kinh doanh.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex, ứng dụng nhập liệu bằng giọng nói chạy cục bộ để trò chuyện với các tác nhân lập trình, ra mắt bản ổn định
Tài khoản OpenCode đăng trên X vào ngày 31 tháng 10 rằng Hex đã có bản phát hành ổn định. Tài khoản mô tả Hex là cách trò chuyện bằng giọng nói với bất kỳ tác nhân nào, với tốc độ nhanh, chạy cục bộ và hoạt động trên Mac, Windows và Linux. Bài đăng dẫn đến anoma.ly/hex.OpenCode 2.2.3 bổ sung công cụ tạo ảnh
Tài khoản OpenCode cho biết trên X vào ngày 30 tháng 10 rằng OpenCode 2.2.3 có công cụ tạo ảnh hỗ trợ các mô hình hình ảnh của OpenAI, Gemini, Grok và những hãng khác. Tài khoản này gợi ý dùng công cụ để tạo giao diện ý tưởng hoặc hình tham khảo cho trò chơi điện tử.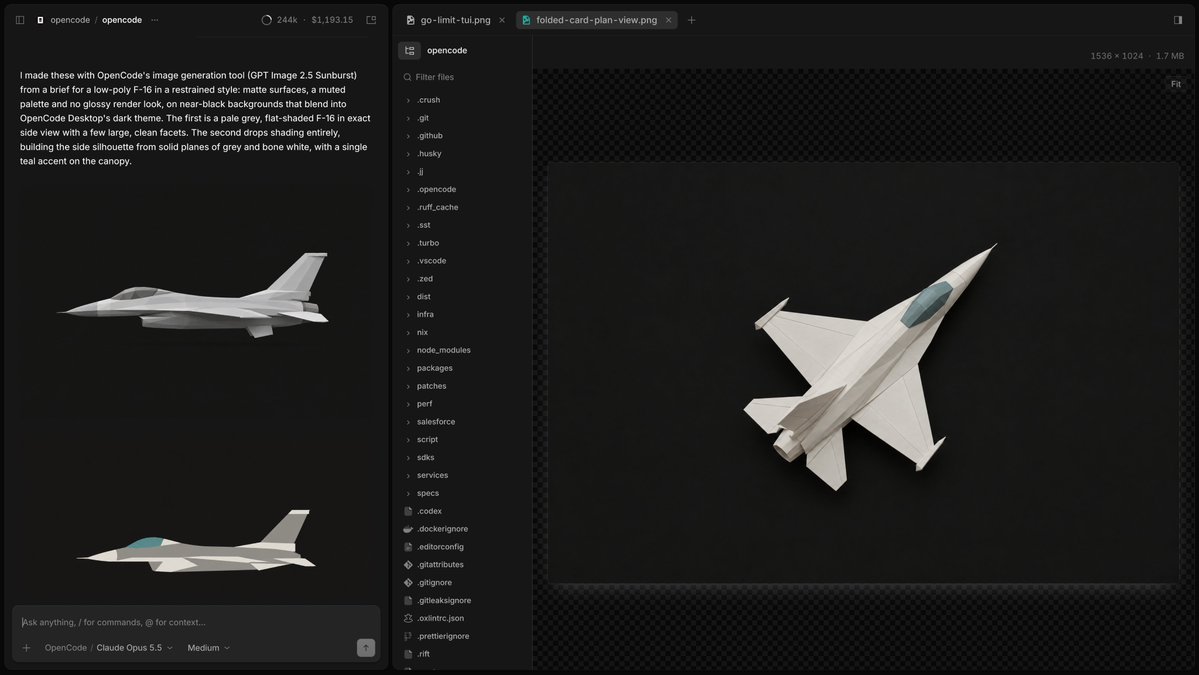
ElevenLabs ra mắt SFX v3, mô hình tạo hiệu ứng âm thanh có thể làm theo prompt nhiều phần
ElevenLabs đã ra mắt SFX v3, mô hình tạo hiệu ứng âm thanh mới nhất của hãng. Hãng cho biết mô hình tạo ra hiệu ứng âm thanh phong phú, chính xác hơn từ một prompt văn bản duy nhất, làm theo nhiều chỉ dẫn trong cùng một prompt đáng tin cậy hơn (ví dụ của hãng: đám đông reo hò, một quả bóng rơi xuống, rồi đám đông la ó) và cải thiện âm nhạc cùng giọng hát.PokeBot ra mắt RoboAPI, API cho phép điều khiển cánh tay robot bằng ngôn ngữ tự nhiên
PokeBot giới thiệu RoboAPI vào ngày 29 tháng 10, vận hành bằng Poke-Aurora, mô hình hành động trong thế giới mà công ty gọi là của mình. Theo PokeBot, các robot tương thích có thể nhận chỉ dẫn bằng ngôn ngữ tự nhiên thông qua một API đơn giản mà không cần huấn luyện riêng cho từng tác vụ.Pika ra mắt H3 Flex, mô hình video nhanh mà hãng gọi là mô hình chuyển văn bản thành video trọng số mở hàng đầu trên DesignArena
Pika giới thiệu H3 Flex, cho biết mô hình ra mắt ở vị trí số 1 trên bảng xếp hạng chuyển văn bản thành video của DesignArena dành cho các mô hình trọng số mở (theo tuyên bố của Pika). Hãng mô tả mô hình được thiết kế để phục vụ quy trình chỉnh sửa chuyên nghiệp: xuất riêng các track âm thanh, độ phân giải lên đến 4K và tạo video nhanh hơn thời gian thực, với một clip 15 giây kèm nhạc nền chỉ mất 7 giây.Phonic 1 ra mắt ở vị trí #1 trên Speech to Speech Index của Artificial Analysis
Artificial Analysis (trang web đánh giá chuẩn, dựa trên số liệu đo của chính họ) cho biết Phonic 1 (High), mô hình chuyển giọng nói thành giọng nói của Phonic, đứng #1 trong số 22 mô hình trên Speech to Speech Index với 87.1 điểm, nhỉnh hơn Grok Voice 3.0 (86.9). Mô hình hiện có qua Phonic API với giá $0.07 mỗi phút.Fish Audio ra mắt Drama 3, được Artificial Analysis xếp hạng #1 trong số các mô hình giọng nói có trọng số mở
Fish Audio đã phát hành Drama 3, với bộ trọng số trên Hugging Face. Artificial Analysis (một trang web đo điểm chuẩn, dựa trên các phép đo riêng) cho biết đây là mô hình có trọng số mở đứng #1 trong cả hai đấu trường giọng nói của họ, đồng thời đứng #1 trong số tất cả mô hình ở bài kiểm tra Pronunciation Robustness.Artificial Analysis giới thiệu AA-Robotics v0.1, bộ benchmark cho các mô hình điều khiển cánh tay robot
Artificial Analysis công bố AA-Robotics v0.1, trong đó các mô hình điều khiển cánh tay robot và quan sát nhiệm vụ từ góc nhìn của mô hình. Trong một ví dụ, cùng một robot viết "hello world": Artificial Analysis cho biết Claude Opus 5.5 chấm từng nét một, với 3.270 chuyển động của cánh tay trong 34 phút, còn GPT-6 Astra viết bằng các nét liền mạch, với 514 chuyển động trong 13 phút.ElevenLabs ra mắt Cue, mô hình căn chỉnh cưỡng bức
ElevenLabs research giới thiệu Cue, một mô hình căn chỉnh cưỡng bức: công đoạn chuyển bản chép lời thành dấu thời gian, dùng cho phụ đề, lồng tiếng và bản chép lời có thể nhấp. Mô hình này định vị từng ký tự trên dòng thời gian của âm thanh.Rime ra mắt Prism, mô hình chuyển giọng nói thành giọng nói dành cho các tác nhân giọng nói
Rime đã ra mắt Prism, mô hình chuyển giọng nói thành giọng nói dành cho các tác nhân giọng nói AI. Các số liệu dưới đây là tuyên bố của riêng Rime, chưa được đo lường độc lập.Artificial Analysis ra mắt AA-Video-I2V v2.1, một benchmark dành cho các mô hình chuyển ảnh thành video
Artificial Analysis đã ra mắt AA-Video-I2V v2.1 và AA-Video-I2V-Silent v2.1, một benchmark dành cho các mô hình chuyển ảnh thành video. Mỗi prompt ghép một ảnh mở đầu 1080p với prompt được viết riêng cho ảnh đó, đồng thời được gắn thẻ theo trường hợp sử dụng, năng lực và phong cách hình ảnh; các mô hình được đánh giá ở độ phân giải tối đa 1080p và xếp hạng trên 10 trường hợp sử dụng cùng 10 năng lực. Bảng xếp hạng tổng thể lấy mẫu đồng đều từ các nhóm này. Kết quả do chính Artificial Analysis công bố.
OpenBMB ra mắt MiniCPM-OCR, trình phân tích tài liệu 1B, cùng mô hình 2B chấm điểm kết quả OCR
OpenBMB giới thiệu MiniCPM-OCR trên X vào ngày 28 tháng 10, chạy cục bộ trên iPhone và iPad. Mô hình được phát hành với trọng số mở và có thể chạy bằng llama.cpp, vLLM, SGLang hoặc Ollama; mã tinh chỉnh được công khai dưới dạng mã nguồn mở, đồng thời OpenBMB cũng cung cấp bản demo và API.AssemblyAI ra mắt mô hình chuyển văn bản thành giọng nói đầu tiên, AssemblyAI-TTS-1
AssemblyAI đã ra mắt AssemblyAI-TTS-1, mô hình chuyển văn bản thành giọng nói đầu tiên của hãng, được xây dựng cho các tác nhân thoại. AssemblyAI cho biết mô hình truyền phát trong 90 ms với giá $15 cho mỗi triệu ký tự và gọi đây là mô hình TTS tốt nhất có thể vận hành ở quy mô lớn khi xét tổng thể độ chính xác, độ tự nhiên và chi phí. OpenRouter cho biết mô hình đã có mặt trên nền tảng, với hơn 4.000 giọng nói được cung cấp từ Mỹ hoặc EU.