 AI Tracker
Hume 推出 Audio Decision API,一次调用即可回答有关音频的问题
Hume 表示,开发者可以通过其 Audio Decision API 询问有关音频的问题,例如有几位说话者、是否有人在笑,或来电者是否感到沮丧。Hume 称,该 API 取代了过去需要 10 个或更多模型才能完成的工作。美团发布 LongCat-2.5:面向智能体任务的 1.6T 参数多模态模型
据账号 leo114119 在 X 上发布的帖子(附有美团 LongCat 博客链接),美团已发布 LongCat-2.5。帖子称,美团将其描述为一款面向智能体任务打造的原生多模态模型,拥有 1.6 万亿参数,在复杂视觉编程项目以及创意设计、3D 任务和商业分析等专业办公工作方面表现出色。
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex:一款用于语音对话编程代理的本地输入应用,发布稳定版
OpenCode 账号于 10 月 31 日在 X 上表示,Hex 稳定版现已推出。该账号将 Hex 描述为一种通过语音与任意代理对话的方式,速度快、在本地运行,并支持 Mac、Windows 和 Linux。帖子附有 anoma.ly/hex 链接。OpenCode 2.2.3 新增图像生成工具
OpenCode 账号于 10 月 30 日在 X 上表示,OpenCode 2.2.3 已加入图像生成工具,支持 OpenAI、Gemini、Grok 等厂商的图像模型。该账号建议将其用于生成概念 UI 或电子游戏参考图。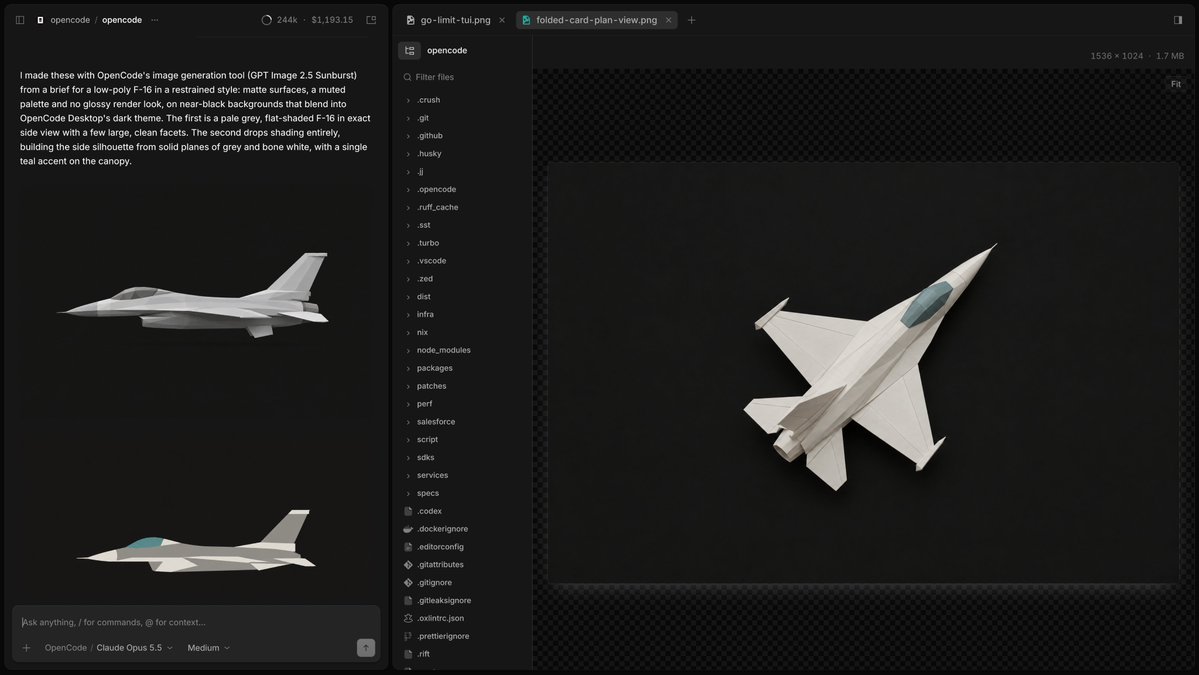
ElevenLabs 发布 SFX v3:可遵循多段式提示词的音效模型
ElevenLabs 发布了最新音效模型 SFX v3。该公司称,只需一个文本提示词,该模型就能生成更丰富、更精确的音效;它也能更可靠地遵循同一提示词中的多项指令(例如:人群欢呼、球落地,然后人群发出嘘声),并改进了音乐和人声效果。PokeBot 推出 RoboAPI:一款可让机械臂听懂自然语言指令的 API
PokeBot 于 10 月 29 日推出 RoboAPI,该产品由 PokeBot 称为其世界动作模型的 Poke-Aurora 驱动。该公司表示,兼容的机器人可通过简单的 API 接收自然语言指令,无需针对特定任务进行训练。Pika 推出 H3 Flex,这款快速视频模型被其称为 DesignArena 上排名第一的开放权重文本生成视频模型
Pika 推出了 H3 Flex,并称其首次亮相便在 DesignArena 的文本生成视频榜单上位列开放权重模型第 #1(这是 Pika 的说法)。Pika 表示,这款模型专为专业迭代打造:支持导出音轨、最高 4K 分辨率,以及快于实时的生成速度;生成一段 15 秒的视频片段及配乐最快只需 7 秒。Phonic 1 首次登顶 Artificial Analysis 的 Speech to Speech Index
Artificial Analysis(一家基准测试网站,以下数据来自其自测)称,Phonic 的语音到语音模型 Phonic 1 (High) 在其 Speech to Speech Index 的 22 个模型中排名第 1,得分为 87.1,略高于 Grok Voice 3.0(86.9)。该模型可通过 Phonic API 使用,价格为每分钟 $0.07。Fish Audio 发布 Drama 3,Artificial Analysis 将其评为开源权重语音模型第 1 名
Fish Audio 发布了 Drama 3,权重已托管在 Hugging Face 上。Artificial Analysis(一个基准测试网站,依据其自身测量结果)称,Drama 3 在其两个语音竞技场中都是排名第 1 的开源权重模型,在其 Pronunciation Robustness 基准测试中则是所有模型中的第 1 名。Artificial Analysis 展示 AA-Robotics v0.1:一项测试模型操控机械臂的基准
Artificial Analysis 发布了 AA-Robotics v0.1,让模型操控机械臂,并从模型的视角展示任务过程。在一个让同一台机械臂写出“hello world”的示例中,Artificial Analysis 称,Claude Opus 5.5 以点描的方式逐点写完,34 分钟内移动机械臂 3,270 次;而 GPT-6 Astra 则连续书写,13 分钟内移动了 514 次。ElevenLabs 推出强制对齐模型 Cue
ElevenLabs 研究团队推出了强制对齐模型 Cue:它将转录文本转换为时间戳,可用于字幕、配音和可点击的转录文本。它会在音频时间轴上为每个字符定位。Rime 推出 Prism,一款面向语音智能体的语音到语音模型
Rime 推出了 Prism,这是一款面向 AI 语音智能体的语音到语音模型。以下数据均为 Rime 自行宣称,未经独立测量。Artificial Analysis 推出 AA-Video-I2V v2.1,这是图像转视频模型基准测试
Artificial Analysis 推出了 AA-Video-I2V v2.1 和 AA-Video-I2V-Silent v2.1,这是一套用于评估图像转视频模型的基准测试。每条提示词都配有一张 1080p 起始图像,以及为其编写的提示词,并按使用场景、能力和视觉风格分类;模型最高按 1080p 评估,并在 10 个使用场景和 10 项能力中排名。总排名在这些类别中均匀抽样。结果由 Artificial Analysis 自行提供。
OpenBMB 发布 MiniCPM-OCR:一款 1B 文档解析器,并推出为 OCR 结果打分的 2B 模型
OpenBMB 于 10 月 28 日在 X 上展示了 MiniCPM-OCR,演示其在 iPhone 和 iPad 上本地运行。该模型以开放权重发布,可通过 llama.cpp、vLLM、SGLang 或 Ollama 运行;微调代码也已开源,OpenBMB 还提供演示版和 API。AssemblyAI 推出首款文本转语音模型 AssemblyAI-TTS-1
AssemblyAI 推出了首款面向语音代理打造的文本转语音模型 AssemblyAI-TTS-1。AssemblyAI 表示,该模型可在 90 毫秒内开始流式输出,价格为每百万字符 15 美元;公司称,综合准确度、自然度和成本来看,这是最适合大规模运行的 TTS 模型。OpenRouter 表示,该模型已上线,提供 4,000 多种语音,服务部署在美国或欧盟。