 AI Tracker
Noticias de multimodal,
para desarrolladores.
Lo último en multimodal de todos los proveedores de IA: lanzamientos, cambios de precio y retiradas, resumidos con lo que significan para ti.
Hume lanza Audio Decision API, que responde preguntas sobre audio en una sola llamada
Hume afirma que su Audio Decision API permite a los desarrolladores hacer preguntas sobre audio, como cuántas personas hablan, si alguien se está riendo o si quien llama está frustrado. Según Hume, sustituye un trabajo que antes requería 10 modelos o más.Meituan lanza LongCat-2.5, un modelo multimodal de 1,6 T de parámetros para tareas de agentes
Meituan ha lanzado LongCat-2.5, según una publicación en X de la cuenta leo114119 que enlaza al blog de LongCat de Meituan. La publicación dice que Meituan lo describe como un modelo multimodal nativo diseñado para tareas de agentes, con 1,6 billones de parámetros, y destaca su rendimiento en proyectos complejos de programación visual y tareas profesionales de oficina, como diseño creativo, tareas 3D y análisis empresarial.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex, una app local de dictado por voz para hablar con agentes de programación, llega a su versión estable
La cuenta de OpenCode anunció en X el 31 de octubre que ya está disponible una versión estable de Hex. La describe como una forma rápida y local de hablar por voz con cualquier agente, compatible con Mac, Windows y Linux. La publicación incluye un enlace a anoma.ly/hex.OpenCode 2.2.3 añade una herramienta de generación de imágenes
La cuenta de OpenCode dijo en X el 30 de octubre que OpenCode 2.2.3 incluye una herramienta de generación de imágenes compatible con modelos de imagen de OpenAI, Gemini, Grok y otros. Sugiere usarla para crear conceptos de interfaz de usuario o arte de referencia para videojuegos.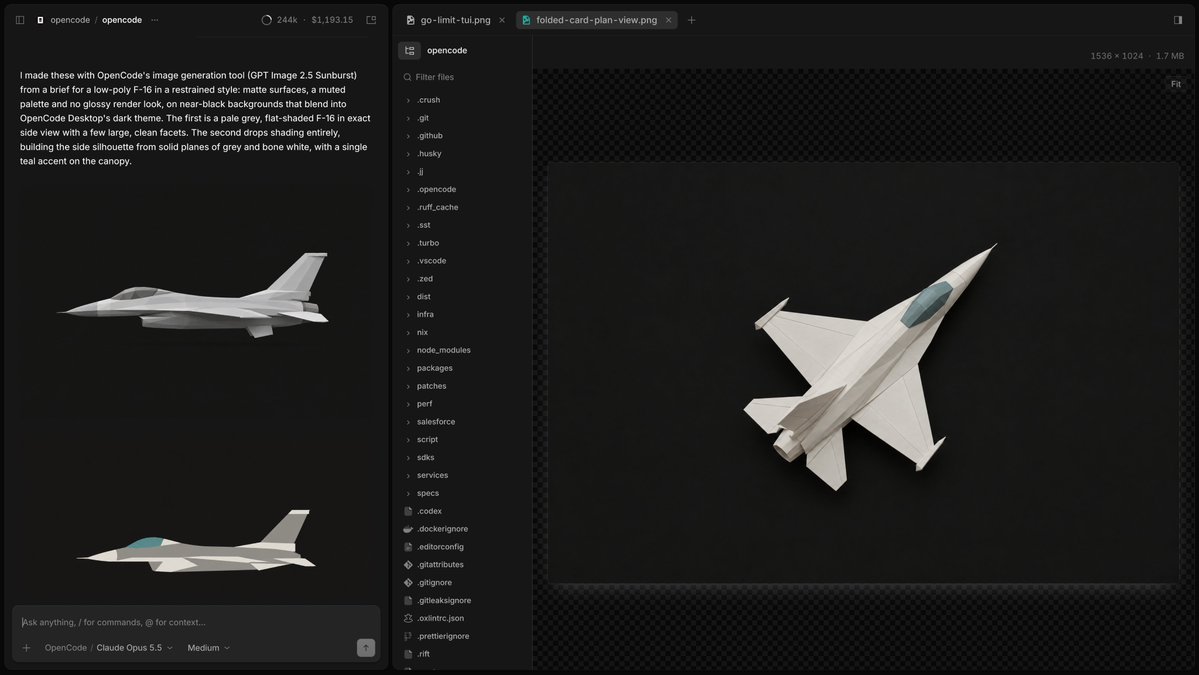
ElevenLabs lanza SFX v3, un modelo de efectos de sonido que sigue instrucciones con varias partes
ElevenLabs lanzó SFX v3, su modelo de efectos de sonido más reciente. La empresa afirma que el modelo genera efectos de sonido más ricos y precisos a partir de una sola instrucción de texto, sigue varias instrucciones en una misma solicitud con mayor fiabilidad (su ejemplo: una multitud vitoreando, una pelota cayendo y, después, una multitud abucheando) y ofrece música y voces mejoradas.PokeBot lanza RoboAPI, una API que permite dar instrucciones en lenguaje natural a brazos robóticos
PokeBot presentó RoboAPI el 29 de octubre, impulsada por Poke-Aurora, su modelo de acciones en el mundo. Afirma que los robots compatibles pueden recibir instrucciones en lenguaje natural a través de una API sencilla, sin entrenamiento específico para cada tarea.Pika lanza H3 Flex, un modelo de video rápido que, según afirma, es el mejor modelo de texto a video de pesos abiertos en DesignArena
Pika presentó H3 Flex, que, según afirma, debuta como el modelo de pesos abiertos n.º 1 en la clasificación de texto a video de DesignArena (afirmación de Pika). Describe el modelo como diseñado para la iteración profesional: pistas de audio exportables, resoluciones de hasta 4K y generación más rápida que en tiempo real, con un clip de 15 segundos y su banda sonora en tan solo 7 segundos.Phonic 1 debuta en el puesto n.º 1 del Speech to Speech Index de Artificial Analysis
Artificial Analysis (un sitio de evaluación comparativa que realiza sus propias mediciones) afirma que Phonic 1 (High), el modelo de conversión de voz a voz de Phonic, ocupa el puesto n.º 1 de 22 en su Speech to Speech Index, con una puntuación de 87,1, apenas por delante de Grok Voice 3.0 (86,9). El modelo está disponible a través de la API de Phonic por $0.07 por minuto.Fish Audio lanza Drama 3, que Artificial Analysis sitúa en el puesto n.º 1 entre los modelos de voz con pesos abiertos
Fish Audio lanzó Drama 3, con los pesos disponibles en Hugging Face. Artificial Analysis (un sitio de evaluación comparativa, según sus propias mediciones) afirma que es el modelo n.º 1 con pesos abiertos en sus dos arenas de voz y el n.º 1 entre todos los modelos en su prueba de Robustez de pronunciación.Artificial Analysis muestra AA-Robotics v0.1, un benchmark de modelos que controlan un brazo robótico
Artificial Analysis publicó AA-Robotics v0.1, donde los modelos controlan un brazo robótico y se muestra la tarea desde el punto de vista del modelo. En un ejemplo en el que el mismo robot escribe «hello world», Artificial Analysis dice que Claude Opus 5.5 lo escribió a toquecitos, punto por punto, con 3,270 movimientos del brazo en 34 minutos, mientras que GPT-6 Astra escribió con trazos continuos, con 514 movimientos en 13 minutos.ElevenLabs presenta Cue, un modelo de alineación forzada
El equipo de investigación de ElevenLabs presentó Cue, un modelo de alineación forzada: el paso que convierte una transcripción en marcas de tiempo, utilizado para subtítulos, doblaje y transcripciones interactivas. Sitúa cada carácter en la línea de tiempo del audio.Rime lanza Prism, un modelo de voz a voz para agentes de voz
Rime lanzó Prism, un modelo de voz a voz para agentes de voz con IA. Las cifras que aparecen a continuación son afirmaciones de Rime, no mediciones independientes.Artificial Analysis lanza AA-Video-I2V v2.1, un benchmark para modelos de imagen a video
Artificial Analysis lanzó AA-Video-I2V v2.1 y AA-Video-I2V-Silent v2.1, un benchmark para modelos de imagen a video. Cada prompt combina una imagen inicial en 1080p con un prompt escrito para ella, y está etiquetado por caso de uso, capacidad y estilo visual; los modelos se evalúan hasta 1080p y se clasifican en 10 casos de uso y 10 capacidades. La clasificación general toma muestras equitativas de todas estas categorías. Los resultados son de Artificial Analysis.
OpenBMB lanza MiniCPM-OCR, un parser de documentos de 1B, junto con un modelo de 2B que puntúa los resultados de OCR
OpenBMB mostró MiniCPM-OCR en X el 28 de octubre, ejecutándose localmente en un iPhone y un iPad. Se lanza con pesos abiertos y puede ejecutarse con llama.cpp, vLLM, SGLang u Ollama; el código de ajuste fino es de código abierto, y OpenBMB también ofrece una demo y una API.AssemblyAI lanza su primer modelo de texto a voz, AssemblyAI-TTS-1
AssemblyAI lanzó AssemblyAI-TTS-1, su primer modelo de texto a voz, diseñado para agentes de voz. AssemblyAI afirma que transmite en 90 ms por $15 por millón de caracteres y lo considera el mejor modelo de TTS que se puede ejecutar a escala si se tienen en cuenta conjuntamente la precisión, la naturalidad y el coste. OpenRouter dice que el modelo ya está disponible allí, con más de 4.000 voces ofrecidas desde EE. UU. o la UE.