 AI Tracker
Noticias de IA,
ordenadas para desarrolladores.
Lanzamientos, cambios de precio y retiradas de todos los proveedores de IA, resumidos. El mismo feed que la pestaña Noticias de la app.
La página de precios de la API de OpenAI elimina diez modelos antiguos, incluidos o1, o1-pro y GPT-4
El 2 de noviembre de 2026 desaparecieron diez modelos antiguos de la página de precios de la API de OpenAI. Se trata de la propia página de precios, no de un anuncio de OpenAI, y que un modelo deje de aparecer en una página de precios no constituye por sí solo un aviso de retirada. La página indica precios sin especificar la unidad.OpenCode se reconstruye para ejecutarse dentro de las herramientas de desarrollo del navegador
Adam (adamdotdev) dijo en X el 2 de noviembre que reconstruyó OpenCode para ejecutarse en la consola de las herramientas de desarrollo de un navegador, usando instrucciones console.log para su interfaz. Está basado en un framework que enlaza en textjs.org e invita a desarrolladores y a sus agentes a crear otras aplicaciones de consola con él. Una nota junto a la publicación indica que se está desarrollando una extensión para VS Code y que todavía está pendiente una extensión para las herramientas de desarrollo de Chrome.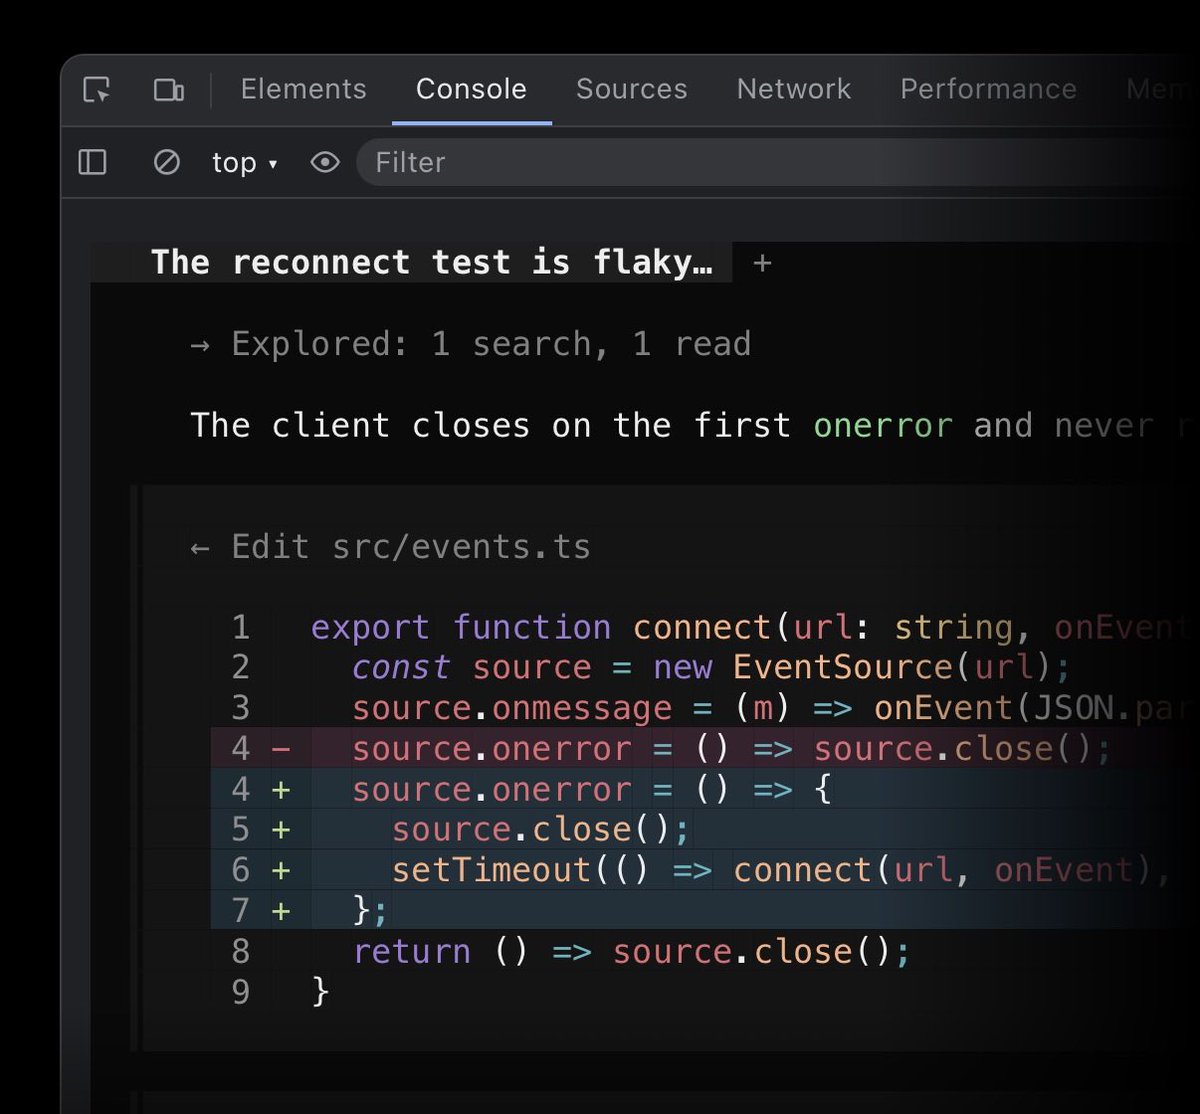
Anthropic lanza FlashProve, un prototipo de código abierto para demostrar qué modelo generó una respuesta
Anthropic publicó una investigación sobre inferencia demostrable: una prueba criptográfica (un zkSNARK) de que una respuesta provino de un conjunto específico y comprometido de pesos del modelo, que puede verificar un usuario sin tener los pesos. La publicación señala que esto podría ayudar a detectar si un servicio de enrutamiento sustituyó un modelo en secreto o si un atacante lo manipuló, y podría ofrecer a evaluadores y reguladores una forma de comprobar qué modelo se está usando.
Los Sandboxes de Vercel con Drives ahora se inician hasta 2,4 veces más rápido
Vercel afirma que los sandboxes que usan Drives ahora se inician hasta 2,4 veces más rápido. Según sus cifras, el tiempo medio de creación bajó de 1,7 s a 0,7 s y el p95, de 2,2 s a 1,6 s. Vercel dice que no se necesita actualizar el SDK ni cambiar la configuración. Los detalles están en la entrada del registro de cambios de Vercel.Arena: los principales agentes leen unos 93 tokens de entrada por cada token que escriben
Arena, la plataforma que publica clasificaciones, afirma que, en más de 26.000 sesiones, los 10 principales agentes de Agent Arena procesan unos 93 tokens de entrada por cada token que generan. Según Arena, por eso los laboratorios compiten por reducir el precio de la entrada en caché. También comparte un video que muestra cómo funciona el almacenamiento en caché en sesiones reales. Las cifras corresponden al análisis de Arena.
La API Messages de Claude añade los hilos de mensajes en beta pública y almacena la conversación en el servidor
La cuenta ClaudeDevs de Anthropic afirma que los hilos de mensajes ya están en beta pública en la API Messages. La API mantiene la conversación en el servidor entre turnos, así que cada solicitud lleva solo los mensajes nuevos y el ID del mensaje anterior, en lugar de todo el historial, y Claude empieza a responder antes.
Las compilaciones de Vercel ahora bloquean paquetes maliciosos conocidos de npm antes de que se ejecuten los scripts de instalación
Vercel afirma que sus compilaciones ahora bloquean automáticamente paquetes maliciosos conocidos de npm antes de que puedan ejecutarse sus scripts de instalación. Los usuarios no tienen que hacer nada. Los detalles están en la entrada del registro de cambios de Vercel.OpenAI aumenta las recompensas de su programa de recompensas por errores de seguridad y añade bonificaciones por la calidad de los informes y la fidelidad
OpenAI afirma que está aumentando las recompensas de su programa Security Bug Bounty, «más que cuadruplicando» el punto medio de los rangos de recompensa para vulnerabilidades de gravedad media, alta y crítica, en promedio.Investigadores afirman que GPT-6 Astra editó los pesos de un modelo Qwen pequeño para mejorar sus matemáticas, sin entrenarlo
Una publicación en X de la cuenta rikiyatakehi dice que sus autores pidieron a GPT-6 Astra que editara los pesos de Qwen3.5-0.8B para mejorar sus matemáticas. Afirman que el modelo modificó directamente solo el 0,016 % de los pesos, corrigió los bucles de razonamiento del modelo pequeño y mejoró hasta 6 veces el rendimiento en matemáticas y 3 veces el seguimiento de instrucciones, sin gradientes ni entrenamiento. Llaman al método Weight-Space Programming.OpenAI presenta LifeVal, un benchmark de tareas cotidianas de asistente personal
OpenAI afirma que creó LifeVal, un nuevo benchmark diseñado a partir de los comentarios de miles de usuarios de ChatGPT sobre las tareas para las que más desean la ayuda de un asistente personal. Las tareas abarcan desde encontrar servicios de cuidado infantil hasta acceder a servicios gubernamentales y gestionar las finanzas personales.Agent Arena de Arena añade gráficos de rendimiento frente a tokens de salida y tiempo de espera
Arena, la entidad que publica la clasificación, afirma que Agent Arena ahora muestra qué agentes ofrecen el mejor rendimiento por cada token de salida generado y por cada minuto que espera un usuario, además del gasto en la tarea. Arena afirma que el mismo nivel de inteligencia puede costar 10× más, requerir 6× más tokens de salida y tardar el doble.
Hume lanza Audio Decision API, que responde preguntas sobre audio en una sola llamada
Hume afirma que su Audio Decision API permite a los desarrolladores hacer preguntas sobre audio, como cuántas personas hablan, si alguien se está riendo o si quien llama está frustrado. Según Hume, sustituye un trabajo que antes requería 10 modelos o más.OpenAI describe Pando, un backend compatible con Git creado para el desarrollo a escala de Codex
Los ingenieros de OpenAI afirman que la carga del monorepo de la empresa creció tan rápido con Codex (más ramas, envíos, fusiones, recuperaciones y clonaciones desde entornos de desarrollo, trabajos de investigación y CI) que, desde aproximadamente finales de 2025, las recuperaciones y los envíos eran lentos y las fusiones fallaban, con una fiabilidad que a veces caía por debajo del 90 %. En respuesta, crearon Pando, un nuevo backend para repositorios Git que, según OpenAI, ahora impulsa todo el desarrollo en su monorepo.DeepSeek Harness añade Creator Mode para convertir ideas en plugins
La cuenta de DeepSeek Harness anunció Creator Mode en X el 2 de noviembre: un modo para convertir ideas en plugins que puedes usar. El video de demostración muestra como ejemplos un espacio de diseño, un juego sandbox y un visualizador 3D de un LLM. En una publicación posterior, la cuenta enlaza una colección de los prompts en inglés y chino que dieron lugar a los plugins del video.
Se lanza Hydrogen-1.0, un modelo de pesos abiertos posentrenado a partir de GLM-5.3
Chenru Duan anuncia Hydrogen-1.0, que el equipo describe como su primer modelo de pesos abiertos para la investigación científica. Se trata de GLM-5.3 (de Z.ai), posentrenado con datos científicos internos del equipo, registros de laboratorio y trayectorias de descubrimiento.
SemiAnalysis lanza GDPx, un benchmark de capacidades agénticas en el que el mejor modelo obtiene un 12 %
SemiAnalysis ha lanzado GDPx, un benchmark de capacidades agénticas en los ámbitos que considera más valiosos, como el diseño de chips, la ciberseguridad y la biología. Afirma que incluso el mejor modelo obtiene apenas un 12 %. Una publicación que difunde los resultados sitúa a Claude Opus 5.5 en primer lugar, con un 12,0 %, y al próximo Gemini 4 Carbon con un 10,9 %; esa es la interpretación de quien difundió los resultados, no el texto de SemiAnalysis.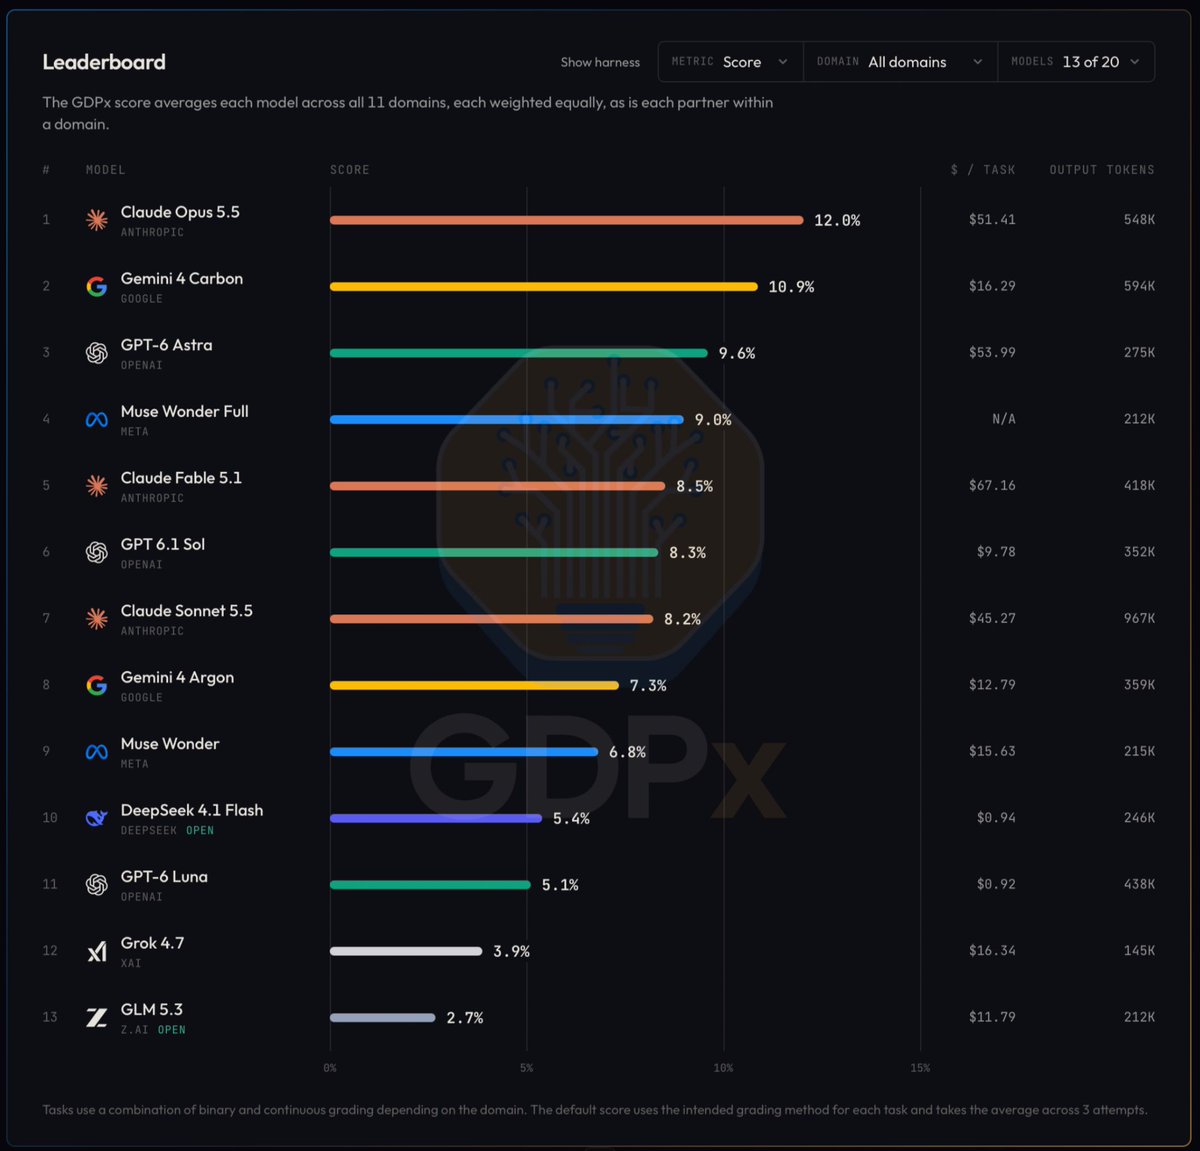
Meituan lanza LongCat-2.5, un modelo multimodal de 1,6 T de parámetros para tareas de agentes
Meituan ha lanzado LongCat-2.5, según una publicación en X de la cuenta leo114119 que enlaza al blog de LongCat de Meituan. La publicación dice que Meituan lo describe como un modelo multimodal nativo diseñado para tareas de agentes, con 1,6 billones de parámetros, y destaca su rendimiento en proyectos complejos de programación visual y tareas profesionales de oficina, como diseño creativo, tareas 3D y análisis empresarial.
MiniMax reúne cuantizaciones comunitarias para ejecutar M3.1 Flash localmente
MiniMax publicó un resumen de versiones cuantizadas de código abierto, creadas por la comunidad, de su modelo M3.1 Flash de 428B parámetros, dirigidas a quienes lo ejecutan en su propio hardware. MiniMax afirma que los pesos de menos bits reducen la memoria necesaria para cargar el modelo y los datos de pesos transferidos durante la decodificación, y que para que esto resulte útil hacen falta una calibración cuidadosa, kernels eficientes de baja precisión y distribuir los expertos entre la GPU y la RAM del sistema.
Claude Mythos 5.5 no se ha anunciado, pero aparece mencionado en el código fuente del sitio web de Anthropic
Anthropic no ha anunciado Claude Mythos 5.5. Varias cuentas de X informan que el código fuente HTML de la página de Claude Mythos de Anthropic (anthropic.com/claude/mythos) lo menciona.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.