 AI Tracker
Actus multimodal,
pour les devs.
Les dernières actus « multimodal » de tous les fournisseurs d'IA : lancements, changements de prix et retraits, résumés avec ce qu'ils changent pour vous.
Hume lance l’Audio Decision API, qui répond aux questions sur les fichiers audio en un seul appel
Hume indique que son Audio Decision API permet aux développeurs de poser des questions sur des fichiers audio, par exemple sur le nombre de personnes qui parlent, si quelqu’un rit ou si un appelant est frustré. Selon Hume, cette API remplace un travail qui nécessitait auparavant 10 modèles ou plus.Meituan lance LongCat-2.5, un modèle multimodal de 1,6 T de paramètres conçu pour les tâches agentiques
Meituan a lancé LongCat-2.5, selon une publication sur X du compte leo114119 qui renvoie au blog LongCat de Meituan. La publication indique que Meituan le présente comme un modèle multimodal natif conçu pour les tâches agentiques, doté de 1,6 billion de paramètres et performant dans les projets complexes de programmation visuelle et les tâches professionnelles de bureau, comme la conception créative, les tâches 3D et l’analyse commerciale.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex, une application locale de saisie vocale pour parler aux agents de programmation, passe en version stable
Le compte OpenCode a annoncé sur X, le 31 octobre, qu’une version stable de Hex était disponible. Il présente Hex comme un moyen rapide de parler par la voix à n’importe quel agent, qui fonctionne localement sur Mac, Windows et Linux. La publication renvoie vers anoma.ly/hex.OpenCode 2.2.3 ajoute un outil de génération d’images
Le compte OpenCode a annoncé sur X le 30 octobre qu’OpenCode 2.2.3 intègre un outil de génération d’images compatible avec les modèles d’image d’OpenAI, Gemini, Grok et d’autres. Il suggère de l’utiliser pour créer des interfaces conceptuelles ou des illustrations de référence pour des jeux vidéo.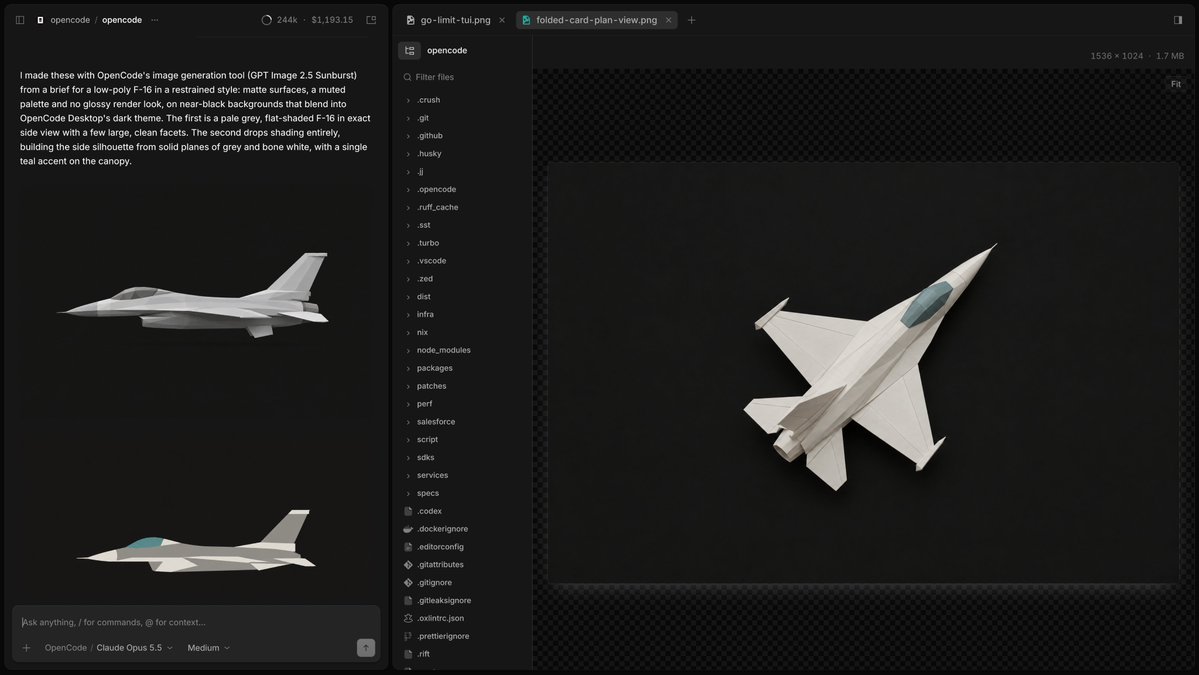
ElevenLabs lance SFX v3, un modèle d’effets sonores qui suit des consignes en plusieurs parties
ElevenLabs a lancé SFX v3, son dernier modèle d’effets sonores. L’entreprise indique que le modèle génère des effets sonores plus riches et plus précis à partir d’une seule consigne textuelle, suit plus fiablement plusieurs instructions dans une même consigne (par exemple : une foule qui acclame, un ballon qui tombe, puis une foule qui hue) et offre une musique et des voix améliorées.PokeBot lance RoboAPI, une API qui permet de donner des instructions en langage naturel à des bras robotisés
PokeBot a présenté RoboAPI le 29 octobre. La solution repose sur Poke-Aurora, que l’entreprise décrit comme son modèle d’action dans le monde réel. Selon elle, les robots compatibles peuvent recevoir des instructions en langage naturel via une API simple, sans entraînement propre à chaque tâche.Pika lance H3 Flex, un modèle vidéo rapide qu’elle présente comme le meilleur modèle open-weight de génération vidéo à partir de texte sur DesignArena
Pika a présenté H3 Flex, qui, selon elle, fait ses débuts à la première place du classement texte-vidéo de DesignArena parmi les modèles open-weight (affirmation de Pika). L’entreprise décrit ce modèle comme conçu pour l’itération professionnelle : pistes audio exportables, résolutions jusqu’à la 4K et génération plus rapide que le temps réel, avec un clip de 15 secondes et sa bande-son produits en seulement 7 secondes.Phonic 1 fait ses débuts à la 1re place de l’indice Speech to Speech d’Artificial Analysis
Artificial Analysis (un site de benchmarks, selon ses propres mesures) indique que Phonic 1 (High), le modèle speech-to-speech de Phonic, se classe 1er sur 22 dans son indice Speech to Speech, avec un score de 87,1, juste devant Grok Voice 3.0 (86,9). Le modèle est disponible via l’API Phonic au prix de 0,07 $ par minute.Fish Audio lance Drama 3, qu’Artificial Analysis classe n° 1 des modèles vocaux à poids ouverts
Fish Audio a lancé Drama 3, dont les poids sont disponibles sur Hugging Face. Artificial Analysis (un site de benchmark, selon ses propres mesures) affirme qu’il s’agit du modèle à poids ouverts n° 1 dans ses deux arènes vocales et du modèle n° 1, toutes catégories confondues, à son benchmark de robustesse de prononciation.Artificial Analysis présente AA-Robotics v0.1, un benchmark de modèles qui contrôlent un bras robotisé
Artificial Analysis a publié AA-Robotics v0.1, qui montre des modèles contrôler un bras robotisé et présente la tâche du point de vue du modèle. Dans un exemple où le même robot écrit « hello world », Artificial Analysis indique que Claude Opus 5.5 l’a écrit point par point, en 3 270 mouvements du bras sur 34 minutes, tandis que GPT-6 Astra l’a écrit d’un trait, en 514 mouvements sur 13 minutes.ElevenLabs présente Cue, un modèle d’alignement forcé
ElevenLabs Research a présenté Cue, un modèle d’alignement forcé : l’étape qui transforme une transcription en horodatages, utilisés pour les sous-titres, le doublage et les transcriptions interactives. Il positionne chaque caractère sur la chronologie audio.Rime lance Prism, un modèle de la parole à la parole pour les agents vocaux
Rime a lancé Prism, un modèle de la parole à la parole pour les agents vocaux IA. Les chiffres ci-dessous sont des affirmations de Rime, et non des mesures indépendantes.Artificial Analysis lance AA-Video-I2V v2.1, un benchmark pour les modèles de génération vidéo à partir d’images
Artificial Analysis a lancé AA-Video-I2V v2.1 et AA-Video-I2V-Silent v2.1, un benchmark pour les modèles de génération vidéo à partir d’images. Chaque prompt associe une image de départ en 1080p à un prompt rédigé pour celle-ci, et est étiqueté selon son cas d’usage, ses capacités et son style visuel ; les modèles sont évalués jusqu’en 1080p et classés selon 10 cas d’usage et 10 capacités. Le classement général attribue le même poids à chacun d’eux.
OpenBMB lance MiniCPM-OCR, un parseur de documents de 1B, accompagné d’un modèle de 2B qui évalue les résultats OCR
OpenBMB a présenté MiniCPM-OCR sur X le 28 octobre, en le faisant fonctionner localement sur un iPhone et un iPad. Le modèle est publié avec ses poids ouverts et peut fonctionner avec llama.cpp, vLLM, SGLang ou Ollama ; le code de fine-tuning est open source, et OpenBMB propose également une démo et une API.AssemblyAI lance son premier modèle de synthèse vocale, AssemblyAI-TTS-1
AssemblyAI a lancé AssemblyAI-TTS-1, son premier modèle de synthèse vocale, conçu pour les agents vocaux. Selon AssemblyAI, il génère de l’audio en continu en 90 ms, au prix de 15 $ par million de caractères, et affirme qu’il s’agit du meilleur modèle TTS à grande échelle si l’on considère conjointement la précision, le naturel et le coût. OpenRouter indique que le modèle y est disponible, avec plus de 4 000 voix proposées depuis les États-Unis ou l’UE.