AI Tracker
Actus multimodal,
pour les devs.
Les dernières actus « multimodal » de tous les fournisseurs d'IA : lancements, changements de prix et retraits, résumés avec ce qu'ils changent pour vous.
Liquid AI présente LFM3, six petits modèles couvrant le texte, la vision, l’audio et l’omni
Liquid AI a annoncé LFM3, une nouvelle génération de ses Liquid Foundation Models reposant sur ce qu’elle décrit comme une nouvelle architecture tri-hybride, avec de nouveaux encodeurs multimodaux. Selon l’entreprise, l’architecture est optimisée pour 14 classes de processeurs, entre GPU, CPU et NPU, et les modèles peuvent être affinés sur un seul GPU.Google DeepMind présente Genie 4, un modèle du monde interactif en temps réel
Google DeepMind a annoncé Genie 4 le 27 octobre 2026, le présentant comme son modèle du monde le plus réaliste et interactif à ce jour. Dans son billet, DeepMind indique que les utilisateurs peuvent explorer des environnements dynamiques en temps réel et voir comment la scène réagit, quels sons elle produit et comment les personnages qui s’y trouvent se déplacent, réagissent et parlent. L’entreprise a publié un billet de blog intitulé « Genie 4: a new generation of world simulation ».Le MAI-Image-2.7-Preview de Microsoft se classe 2e en édition d’images chez Artificial Analysis
Selon Artificial Analysis, MAI-Image-2.7-Preview de Microsoft AI, son tout dernier modèle d’édition d’images et le successeur de MAI-Image-2.6 (sorti en août), se classe deuxième de son classement AA-Image-Editing v2.1, juste derrière GPT Image 2.5 Sunburst (max) d’OpenAI. Ces résultats sont ceux d’Artificial Analysis.SenseTime aurait publié en open source SenseNova 6.8 Code2Video, un modèle de code vers vidéo de 27B
Un blogueur chinois spécialisé en IA rapporte que SenseTime a publié en open source SenseNova 6.8 Code2Video le 27 octobre, avec les poids sur Hugging Face sous le nom sensenova/SenseNova-6.8-Code2Video. L'information est rapportée par une source secondaire ; aucune annonce de SenseTime n'est citée.Maya-2, un modèle vocal pour les langues indiennes, est publié avec ses poids ouverts
Maya-2, un modèle de synthèse vocale destiné à l’Inde, a été publié avec ses poids ouverts le 27 octobre sous le nom maya-research/maya2-native sur Hugging Face. L’annonce sur X indique qu’il couvre plus de 1,5 milliard de personnes dans les 28 États et les 8 territoires de l’Union.
Baidu rend open source Unlimited OCR 2, un parseur de documents au coût de décodage quasi constant
Baidu a annoncé Unlimited OCR 2 sur X le 26 octobre, avec le code sur GitHub et les poids sur Hugging Face. Le modèle est conçu pour analyser des documents de longueur pratiquement illimitée dans une fenêtre de contexte finie.Artificial Analysis lance Code2Video-AA, un benchmark de vidéos marketing créées en code
Artificial Analysis a présenté Code2Video-AA, sa propre implémentation de Code2Video Bench de HeyGen, développée en partenariat avec HeyGen. Les modèles reçoivent 114 briefs de marketing produit et de marque et doivent répondre à chacun avec une composition HTML HyperFrames en une seule réponse, sans outils ; la composition est ensuite rendue en vidéo sans accès au réseau. Un modèle évaluateur (Gemini 4 Argon, high) compare les vidéos deux à deux selon leur capacité à susciter l’engagement, le respect de l’intention du prompt, la composition, la cohérence temporelle et la qualité d’exécution. Les notes Elo des cinq axes sont moyennées pour produire le score principal. Plus de 35 000 évaluations classent 27 modèles. Les résultats sont ceux d’Artificial Analysis.Un CNN de 2015 ajusté bat GPT-6 Astra et Claude Fable 5.1 pour identifier des lésions cutanées, rapporte un dermatologue
Le Dr Magnus Lynch, dermatologue consultant au Guy's Hospital et au King's College London, a publié un test de GPT-6 Astra et Claude Fable 5.1 sur 200 lésions confirmées par biopsie, tirées au hasard du jeu de données public MILK10k. Chaque modèle a reçu une photo clinique et une image dermoscopique, le même prompt et les paramètres par défaut, puis a choisi parmi six diagnostics. Le modèle de comparaison était Inception v3 (publié en 2015), ajusté sur 68,011 images des archives ISIC sur un seul GPU H100, les lésions du test ayant été retirées de ses données d'entraînement.Moonshot lance Kimi K3.1 Pro, avec des poids ouverts promis d’ici le 4 novembre
Moonshot a annoncé Kimi K3.1 Pro, qu’elle présente comme son modèle à poids ouverts de classe 3T le plus performant : un modèle multimodal à mélange d’experts avec 2,8T de paramètres au total, dont 104B actifs, et un contexte de 1M de tokens. Moonshot indique que K3.1 Pro et K3.1 Pro Highspeed (2 à 3 fois plus rapide) sont disponibles sur Kimi.ai, Kimi Work, Kimi Code et l’API Kimi (identifiants de modèle kimi-k3.1-pro et kimi-k3.1-pro-highspeed). Les poids ouverts sont promis pour le 4 novembre 2026.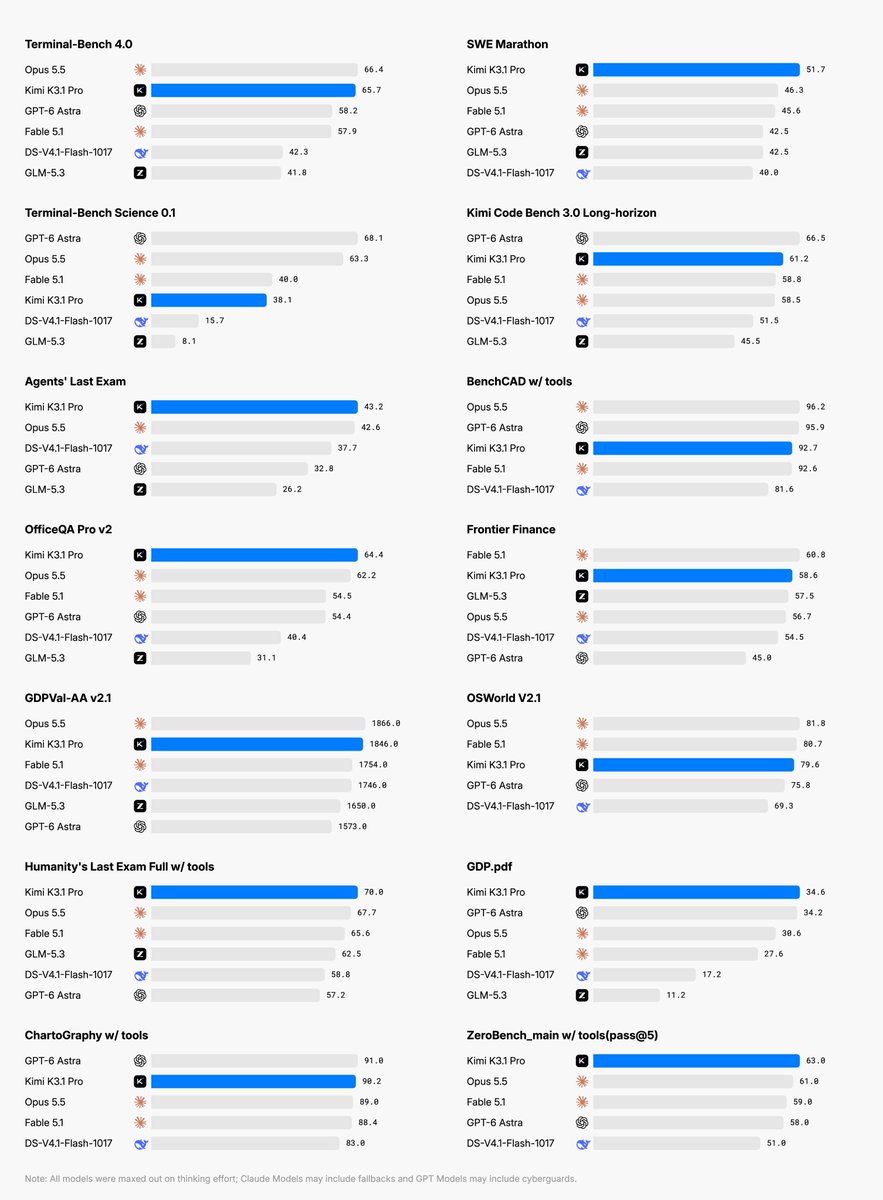
Block présente Dessa en avant-première, un modèle vocal speech-to-speech full duplex
Block, l’entreprise derrière Square et Cash App, a présenté une avant-première de recherche de Dessa, qu’elle décrit comme « le modèle vocal full duplex le plus authentique jamais conçu ». Dans son annonce, Jack Dorsey affirme que lui parler donne l’impression de parler à une personne, avec des émotions, des nuances, des pauses et une cadence naturelle.Google releases Gemini 4 Argon, its latest frontier model
Google released Gemini 4 Argon on October 13, 2026, and says it is available globally. Google's blog post was shared on Hacker News on October 20. The Gemini API changelog lists gemini-4-argon as generally available from October 13, describing it as Google's most capable model, built for complex coding, agentic, math and science tasks.Grok Bot 0.75.2 ajoute des cartes dans les discussions sur ordinateur et la génération de vidéos
Grok Bot 0.75.2 est disponible, selon une publication sur X d’un membre de l’équipe Grok Bot, qui renvoie vers le journal des modifications de la version sur x.ai. La publication énumère trois changements :Ideogram introduces its first vector model
Ideogram announced its first vector model on X. According to Ideogram, it generates clean, editable SVGs with smooth gradients and sharp typography from a text prompt, or turns any image into a detailed, scalable vector.
Mistral releases Voxtral 3, speech models and a voice agent SDK
Mistral announced Voxtral 3 on October 20, 2026 (shared on Hacker News, where it had 735 points and 182 comments by October 20). Details and benchmarks below are Mistral's own claims from its announcement page.
ElevenLabs opens a limited alpha of Eleven Realtime Translation
ElevenLabs announced on X on October 21, 2026 a limited alpha of Eleven Realtime Translation, which builds live voice translation into calls. It followed the launch earlier that week of Eleven Realtime, its product for voice agents that talk to people.