 AI Tracker
मल्टीमोडल समाचार,
डेवलपर्स के लिए।
हर AI provider से मल्टीमोडल से जुड़ी ताज़ा ख़बरें: लॉन्च, कीमत में बदलाव और बंद होने वाली सेवाएँ, संक्षेप में और आपके लिए उनका मतलब।
Hume ने Audio Decision API लॉन्च किया, जो एक ही कॉल में ऑडियो के बारे में सवालों के जवाब देता है
Hume का कहना है कि उसका Audio Decision API डेवलपर्स को ऑडियो के बारे में सवाल पूछने देता है—जैसे उसमें कितने वक्ता हैं, क्या कोई हँस रहा है या कोई कॉलर झुंझलाया हुआ है। Hume के मुताबिक, इससे उस काम की जगह एक ही मॉडल ले लेता है जिसके लिए पहले 10 या उससे अधिक मॉडल इस्तेमाल करने पड़ते थे।Meituan ने LongCat-2.5 जारी किया, जो एजेंट कार्यों के लिए 1.6T-पैरामीटर वाला मल्टीमॉडल मॉडल है
X पर leo114119 नाम के अकाउंट की एक पोस्ट के मुताबिक, Meituan ने LongCat-2.5 जारी किया है। पोस्ट में Meituan के LongCat ब्लॉग का लिंक दिया गया है। पोस्ट कहती है कि Meituan इसे एजेंट कार्यों के लिए बनाया गया एक नेटिव मल्टीमॉडल मॉडल बताता है, जिसमें 1.6 ट्रिलियन पैरामीटर हैं। जटिल विज़ुअल कोडिंग परियोजनाओं और पेशेवर कार्यालयी काम—जैसे रचनात्मक डिज़ाइन, 3D कार्य और व्यावसायिक विश्लेषण—में भी इसे मजबूत बताया गया है।
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex, कोडिंग एजेंट से बात करने के लिए बनाया गया लोकल वॉइस-इनपुट ऐप, स्थिर रिलीज़ तक पहुँचा
OpenCode अकाउंट ने 31 अक्टूबर को X पर कहा कि Hex की स्थिर रिलीज़ उपलब्ध है। इसमें Hex को आवाज़ के ज़रिए किसी भी एजेंट से बात करने का तेज़ तरीका बताया गया है, जो लोकल रूप से चलता है और Mac, Windows और Linux पर काम करता है। पोस्ट में anoma.ly/hex का लिंक है।OpenCode 2.2.3 में इमेज जनरेशन टूल शामिल
OpenCode अकाउंट ने 30 अक्टूबर को X पर कहा कि OpenCode 2.2.3 में एक इमेज जनरेशन टूल है, जो OpenAI, Gemini, Grok और अन्य के इमेज मॉडल को सपोर्ट करता है। इसमें वीडियो गेम के लिए कॉन्सेप्ट UI या रेफरेंस आर्ट बनाने के लिए इसका इस्तेमाल करने का सुझाव दिया गया है।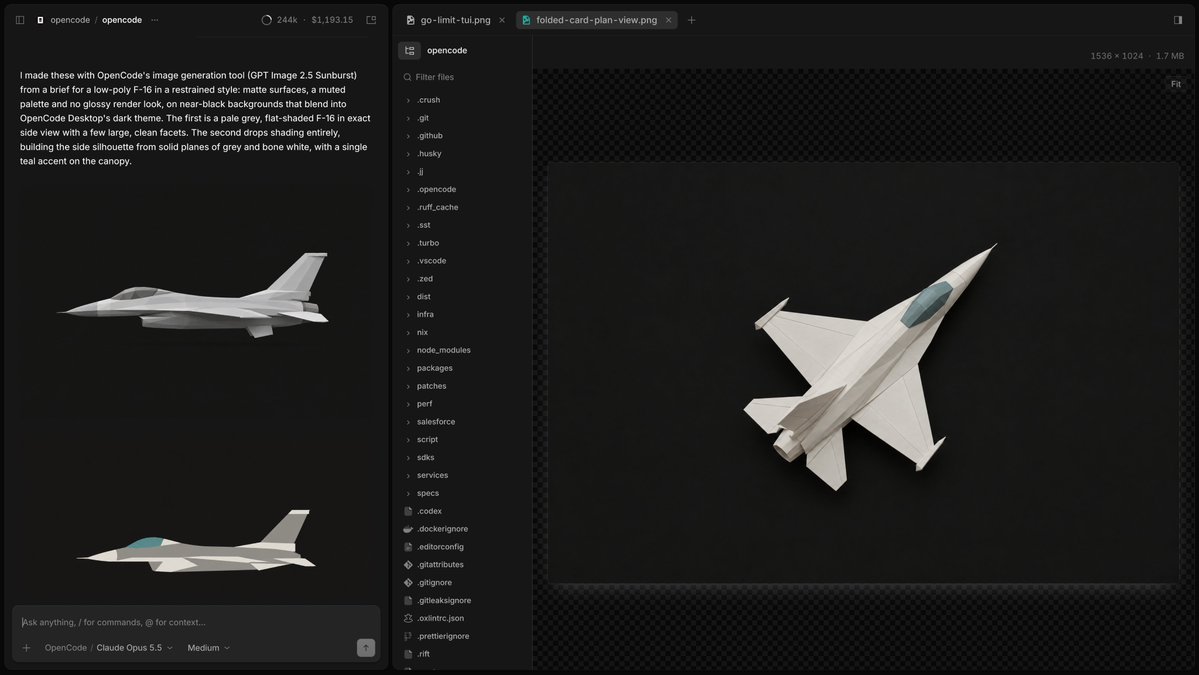
ElevenLabs ने SFX v3 लॉन्च किया, यह साउंड इफेक्ट्स मॉडल कई हिस्सों वाले प्रॉम्प्ट का पालन करता है
ElevenLabs ने SFX v3 लॉन्च किया, जो उसका नवीनतम साउंड इफेक्ट्स मॉडल है। कंपनी का कहना है कि यह मॉडल एक ही टेक्स्ट प्रॉम्प्ट से अधिक समृद्ध और सटीक साउंड इफेक्ट्स बनाता है, एक प्रॉम्प्ट में दिए गए कई निर्देशों का अधिक भरोसेमंद तरीके से पालन करता है (उसका उदाहरण: भीड़ का जयकारा लगाना, गेंद का गिरना, फिर भीड़ का हूटिंग करना), और इसमें संगीत व वोकल्स बेहतर हुए हैं।PokeBot ने RoboAPI लॉन्च किया, एक API जो रोबोटिक भुजाओं को प्राकृतिक भाषा में निर्देश देती है
PokeBot ने 29 अक्टूबर को RoboAPI पेश किया, जो Poke-Aurora पर आधारित है—कंपनी इसे अपना world-action model कहती है। उसका कहना है कि संगत रोबोट बिना किसी कार्य-विशिष्ट प्रशिक्षण के, एक सरल API के ज़रिए प्राकृतिक भाषा में दिए गए निर्देश ले सकते हैं।Pika ने H3 Flex लॉन्च किया, एक तेज़ वीडियो मॉडल जिसे वह DesignArena पर शीर्ष ओपन-वेट टेक्स्ट-टू-वीडियो मॉडल बताती है
Pika ने H3 Flex पेश किया, जिसके बारे में उसका कहना है कि यह DesignArena के टेक्स्ट-टू-वीडियो बोर्ड पर #1 ओपन-वेट मॉडल के रूप में डेब्यू करता है (Pika का दावा)। कंपनी इसे पेशेवर स्तर पर बार-बार सुधार करने के लिए बना मॉडल बताती है: एक्सपोर्ट किए जा सकने वाले ऑडियो स्टेम, 4K तक के रिज़ॉल्यूशन और रियल-टाइम से तेज़ जनरेशन—जिसमें 15 सेकंड की क्लिप और साउंडट्रैक सिर्फ़ 7 सेकंड में बनाए जा सकते हैं।Artificial Analysis के Speech to Speech Index में Phonic 1 ने #1 स्थान पर शुरुआत की
Artificial Analysis (एक बेंचमार्क साइट, जिसके आंकड़े उसके अपने माप पर आधारित हैं) के अनुसार, Phonic का speech-to-speech मॉडल Phonic 1 (High), उसके Speech to Speech Index में 87.1 अंकों के साथ 22 मॉडलों में #1 पर है—Grok Voice 3.0 (86.9) से मामूली आगे। यह मॉडल Phonic API के ज़रिए $0.07 प्रति मिनट पर उपलब्ध है।Fish Audio ने Drama 3 जारी किया; Artificial Analysis की रैंकिंग में यह ओपन-वेट स्पीच मॉडल्स में #1 है
Fish Audio ने Drama 3 जारी किया, जिसके वेट्स Hugging Face पर उपलब्ध हैं। Artificial Analysis (एक बेंचमार्क साइट, जिसके अपने माप हैं) के अनुसार, यह उसके दोनों स्पीच एरीना में #1 ओपन-वेट मॉडल है और उसके Pronunciation Robustness बेंचमार्क पर सभी मॉडलों में #1 है।Artificial Analysis ने AA-Robotics v0.1 पेश किया, जो रोबोटिक आर्म को नियंत्रित करने वाले मॉडल्स का बेंचमार्क है
Artificial Analysis ने AA-Robotics v0.1 प्रकाशित किया, जिसमें मॉडल्स एक रोबोटिक आर्म को नियंत्रित करते हैं और काम को मॉडल के नज़रिए से दिखाया जाता है। एक उदाहरण में, जहां वही रोबोट "hello world" लिखता है, Artificial Analysis के मुताबिक Claude Opus 5.5 ने अक्षर को बिंदु-बिंदु करके लिखा—34 मिनट में आर्म की 3,270 चालों के साथ—जबकि GPT-6 Astra ने लगातार स्ट्रोक में लिखा—13 मिनट में 514 चालों के साथ।ElevenLabs ने Cue पेश किया, एक forced alignment मॉडल
ElevenLabs रिसर्च ने Cue पेश किया—एक forced alignment मॉडल, जो ट्रांसक्रिप्ट को टाइमस्टैम्प में बदलता है। इसका इस्तेमाल सबटाइटल, डबिंग और क्लिक किए जा सकने वाले ट्रांसक्रिप्ट के लिए होता है। यह हर अक्षर को ऑडियो की टाइमलाइन पर रखता है।Rime ने Prism लॉन्च किया, वॉइस एजेंट्स के लिए स्पीच-टू-स्पीच मॉडल
Rime ने AI वॉइस एजेंट्स के लिए स्पीच-टू-स्पीच मॉडल Prism लॉन्च किया। नीचे दिए गए आंकड़े Rime के अपने दावे हैं, स्वतंत्र रूप से मापे गए नतीजे नहीं।Artificial Analysis ने इमेज-टू-वीडियो मॉडल्स के लिए AA-Video-I2V v2.1 बेंचमार्क लॉन्च किया
Artificial Analysis ने इमेज-टू-वीडियो मॉडल्स के लिए AA-Video-I2V v2.1 और AA-Video-I2V-Silent v2.1 लॉन्च किए। हर प्रॉम्प्ट में 1080p की एक शुरुआती इमेज और उसके लिए लिखा गया प्रॉम्प्ट शामिल है, और उसे उपयोग के मामले, क्षमता तथा विज़ुअल शैली के आधार पर टैग किया गया है; मॉडल्स का मूल्यांकन 1080p तक के रिज़ॉल्यूशन पर किया जाता है और 10 उपयोग मामलों तथा 10 क्षमताओं में उनकी रैंकिंग होती है। कुल रैंकिंग में इन सभी को समान रूप से शामिल किया जाता है। ये नतीजे Artificial Analysis के अपने हैं।
OpenBMB ने MiniCPM-OCR जारी किया: 1B दस्तावेज़ पार्सर, साथ में OCR नतीजों को स्कोर करने वाला 2B मॉडल
OpenBMB ने 28 अक्टूबर को X पर MiniCPM-OCR दिखाया, जो iPhone और iPad पर स्थानीय रूप से चल रहा था। इसे खुले वज़न के साथ जारी किया गया है और यह llama.cpp, vLLM, SGLang या Ollama के साथ चल सकता है; fine-tuning कोड ओपन सोर्स है, और OpenBMB एक डेमो और API भी उपलब्ध कराता है।AssemblyAI ने अपना पहला टेक्स्ट-टू-स्पीच मॉडल, AssemblyAI-TTS-1 लॉन्च किया
AssemblyAI ने AssemblyAI-TTS-1 लॉन्च किया, जो उसका पहला टेक्स्ट-टू-स्पीच मॉडल है और वॉइस एजेंट्स के लिए बनाया गया है। AssemblyAI का कहना है कि यह $15 प्रति दस लाख अक्षरों की दर से 90 ms में स्ट्रीम करता है और सटीकता, स्वाभाविकता तथा लागत—तीनों को साथ में देखते हुए इसे बड़े पैमाने पर चलाया जा सकने वाला सबसे अच्छा TTS मॉडल बताता है। OpenRouter का कहना है कि यह मॉडल वहाँ उपलब्ध है और इसमें अमेरिका या EU से 4,000+ आवाज़ें दी जाती हैं।