 AI Tracker
マルチモーダルのニュースを、
開発者向けに。
各 AI プロバイダーのマルチモーダルに関する最新ニュース。リリース、価格改定、提供終了を、あなたへの影響とともに要約します。
Hume、音声に関する質問に1回の呼び出しで回答するAudio Decision APIを発表
Humeによると、Audio Decision APIでは、話者が何人いるか、誰かが笑っているか、通話相手が苛立っているかなど、音声について開発者が質問できます。Humeは、従来は10個以上のモデルが必要だった作業をこのAPIで置き換えられるとしています。美団、エージェントタスク向けの1.6兆パラメータのマルチモーダルモデル「LongCat-2.5」を公開
Xアカウントleo114119の投稿によると、美団がLongCat-2.5を公開しました。投稿には美団のLongCatブログへのリンクがあります。美団は、エージェントタスク向けに構築したネイティブマルチモーダルモデルで、パラメータ数は1.6兆、複雑なビジュアルコーディングプロジェクトや、クリエイティブデザイン、3Dタスク、ビジネス分析などの専門的なオフィス業務に強いと説明しているとのことです。
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
コーディングエージェントと音声でやり取りできるローカル音声入力アプリ「Hex」が正式リリース
OpenCodeのアカウントは10月31日、XでHexの正式版が利用可能になったと発表しました。Hexは、あらゆるエージェントに音声で話しかけるための手段で、高速に動作し、ローカルで実行でき、Mac、Windows、Linuxに対応すると説明しています。投稿ではanoma.ly/hexへのリンクも紹介されています。OpenCode 2.2.3、画像生成ツールを追加
OpenCodeの公式アカウントは10月30日、Xで、OpenCode 2.2.3にOpenAI、Gemini、Grokなどの画像モデルに対応した画像生成ツールが搭載されたと発表しました。ビデオゲームのコンセプトUIや参考アートの作成に使うことを提案しています。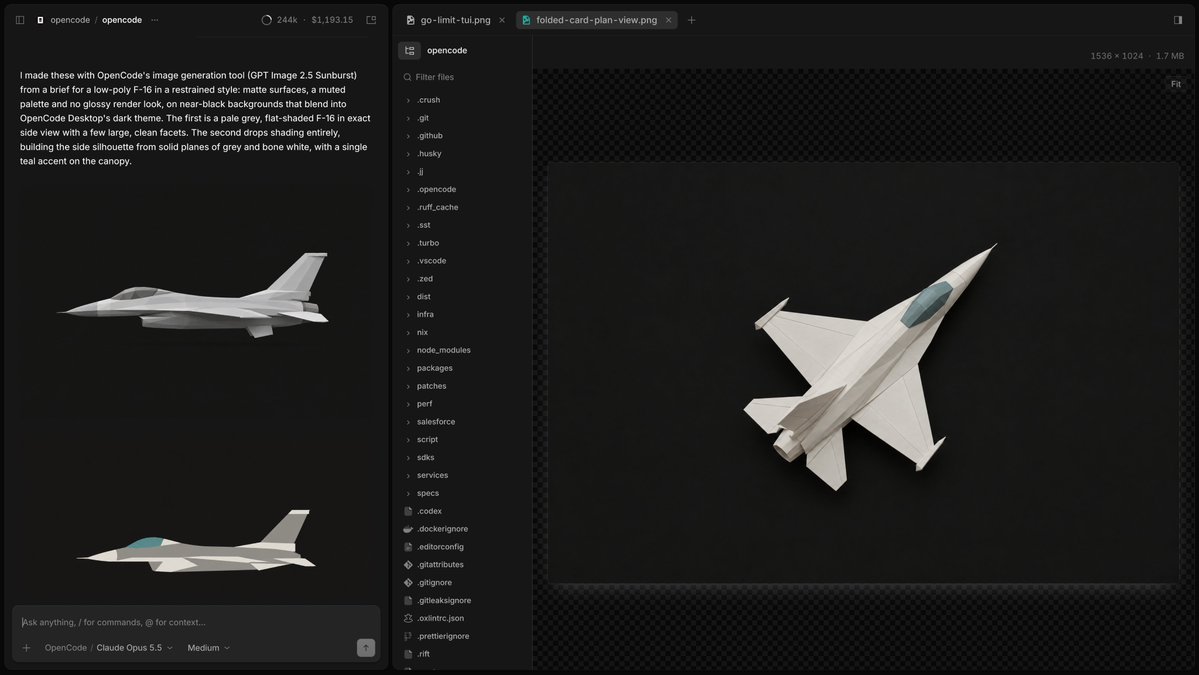
ElevenLabs、複数パートのプロンプトに対応する効果音モデル「SFX v3」をリリース
ElevenLabsは、最新の効果音モデル「SFX v3」をリリースしました。同社によると、このモデルは1つのテキストプロンプトから、より豊かで精度の高い効果音を生成します。また、1つのプロンプト内の複数の指示に、より確実に従います(同社の例:群衆の歓声、ボールが落ちる音、その後に群衆がブーイングする音)。音楽とボーカルも改善されました。PokeBot、ロボットアームに自然言語で指示できるAPI「RoboAPI」を発表
PokeBotは10月29日、同社が「world-action model」と呼ぶPoke-Auroraを搭載したRoboAPIを発表した。同社によると、対応ロボットはタスクごとの学習なしで、シンプルなAPIを通じて自然言語の指示を受け取れる。Pika、DesignArenaで「オープンウェイトのテキスト動画生成モデルとして首位」と称する高速動画モデル「H3 Flex」を発表
PikaはH3 Flexを発表し、DesignArenaのテキスト動画生成ランキングでオープンウェイトモデルとして初登場ながら1位になったとしています(Pikaの主張)。プロフェッショナルな反復制作向けに設計されたモデルとして、書き出し可能な音声ステム、最大4Kの解像度、リアルタイムを上回る生成速度を挙げ、15秒の動画クリップとサウンドトラックを最短7秒で生成できると説明しています。Phonic 1、Artificial AnalysisのSpeech to Speech Indexで初登場1位
Artificial Analysis(ベンチマークサイトによる独自測定)によると、Phonicの音声対音声モデルPhonic 1 (High)は、Speech to Speech Indexで22モデル中1位の87.1を記録し、Grok Voice 3.0(86.9)を僅差で上回りました。このモデルはPhonic API経由で1分あたり$0.07で利用できます。Fish AudioがDrama 3をリリース、Artificial Analysisのランキングでオープンウェイト音声モデル第1位に
Fish AudioはDrama 3をリリースし、重みをHugging Faceで公開しました。ベンチマークサイトのArtificial Analysisは、自社の測定結果として、同モデルが2つの音声アリーナでオープンウェイトモデル第1位、Pronunciation Robustnessベンチマークでは全モデル中第1位だとしています。Artificial Analysisが、ロボットアームを操作するモデルのベンチマーク「AA-Robotics v0.1」を公開
Artificial Analysisは、モデルにロボットアームを操作させ、モデル視点でタスクを見られる「AA-Robotics v0.1」を公開しました。同じロボットに「hello world」と書かせた例では、Artificial Analysisによると、Claude Opus 5.5は点を打って書き、アームを3,270回動かして34分かかった一方、GPT-6 Astraは連続したストロークで書き、514回の動きで13分でした。ElevenLabs、強制アライメントモデル「Cue」を発表
ElevenLabsの研究チームが、文字起こしをタイムスタンプに変換する工程を担う強制アライメントモデル「Cue」を発表しました。字幕、吹き替え、クリック可能な文字起こしなどに使われます。音声のタイムライン上に、すべての文字を配置します。Rime、音声エージェント向け音声間モデル「Prism」を発表
Rimeは、AI音声エージェント向けの音声間モデル「Prism」を発表しました。以下の数値はRime自身の主張であり、独立した測定によるものではありません。Artificial Analysis、画像から動画を生成するモデルのベンチマーク「AA-Video-I2V v2.1」を公開
Artificial Analysisは、画像から動画を生成するモデルのベンチマーク「AA-Video-I2V v2.1」と「AA-Video-I2V-Silent v2.1」を公開しました。各プロンプトは、1080pの開始画像とそれに合わせて作成されたプロンプトを組み合わせ、ユースケース、能力、ビジュアルスタイルのタグが付けられています。モデルは最大1080pで評価され、10のユースケースと10の能力にわたって順位付けされます。総合ランキングでは、それらを均等にサンプリングします。結果はArtificial Analysis独自のものです。
OpenBMB、1Bの文書解析モデルMiniCPM-OCRをリリース。OCR結果を評価する2Bモデルも公開
OpenBMBは10月28日、XでMiniCPM-OCRを披露。iPhoneとiPad上でローカル実行する様子を紹介した。オープンウェイトで公開され、llama.cpp、vLLM、SGLang、Ollamaで実行できる。ファインチューニング用コードもオープンソースで、OpenBMBはデモとAPIも提供している。AssemblyAI、初のテキスト読み上げモデル「AssemblyAI-TTS-1」を発表
AssemblyAIは、音声エージェント向けに開発した初のテキスト読み上げモデル、AssemblyAI-TTS-1を発表しました。AssemblyAIによると、90 msでストリーミングし、100万文字あたり$15で提供されます。また、精度、自然さ、コストを総合すると、大規模運用できる最高のTTSモデルだとしています。OpenRouterによると、モデルは同サービスで利用可能で、米国またはEUから4,000以上の音声を提供しています。