 AI Tracker
Multimodal: as notícias,
para devs.
As últimas notícias de multimodal de todos os provedores de IA: lançamentos, mudanças de preço e descontinuações, resumidos com o que significam para você.
Hume lança a Audio Decision API, que responde a perguntas sobre áudio em uma única chamada
A Hume afirma que sua Audio Decision API permite que desenvolvedores façam perguntas sobre áudio, como quantos locutores há, se alguém está rindo ou se uma pessoa que está ao telefone está frustrada. Segundo a Hume, a API substitui um trabalho que antes exigia 10 ou mais modelos.Meituan lança LongCat-2.5, um modelo multimodal de 1,6T de parâmetros para tarefas de agentes
A Meituan lançou o LongCat-2.5, segundo uma publicação no X da conta leo114119 que contém um link para o blog LongCat da Meituan. A publicação diz que a Meituan o descreve como um modelo multimodal nativo desenvolvido para tarefas de agentes, com 1,6 trilhão de parâmetros, e como forte em projetos complexos de programação visual e em trabalhos profissionais de escritório, como design criativo, tarefas 3D e análise de negócios.
Google announces Gemini 4 Carbon, its next frontier model, to cyber defenders first
Google announced Gemini 4 Carbon on October 28, 2026, calling it its strongest model, with state-of-the-art cybersecurity and long-horizon capabilities. It follows Gemini 4 Argon by two weeks. Sundar Pichai's post and Google's blog say it is not yet generally available: starting this week a subset of cyber defenders get access, with more trusted partners added through the Fairwind Program. Google says it will bring Carbon to developers, businesses and consumers "as soon as possible", and that it is taking part in the U.S. government's voluntary process for pre-release model testing.
Hex, um app local de entrada por voz para conversar com agentes de programação, chega à versão estável
A conta da OpenCode anunciou no X, em 31 de outubro, que uma versão estável do Hex está disponível. Ela descreve o Hex como uma forma rápida de conversar por voz com qualquer agente, que roda localmente e funciona em Mac, Windows e Linux. A publicação traz um link para anoma.ly/hex.OpenCode 2.2.3 adiciona uma ferramenta de geração de imagens
A conta do OpenCode publicou no X, em 30 de outubro, que o OpenCode 2.2.3 tem uma ferramenta de geração de imagens compatível com modelos de imagem da OpenAI, Gemini, Grok e outros. A publicação sugere usá-la para criar conceitos de interface ou arte de referência para videogames.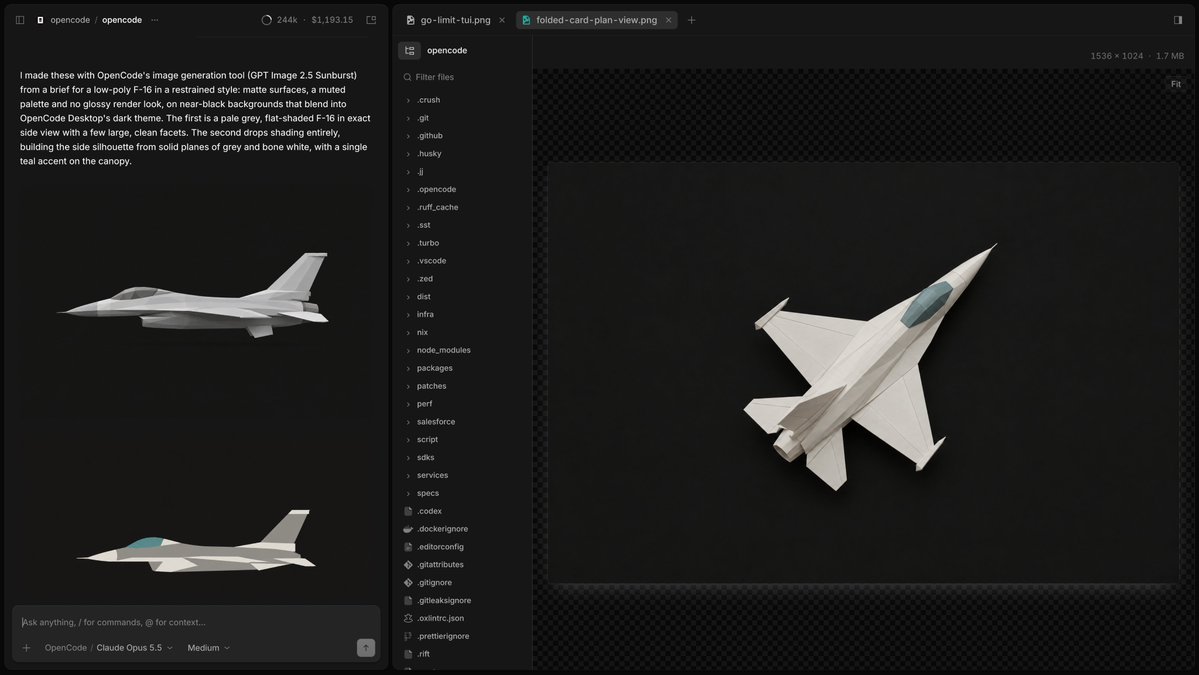
ElevenLabs lança SFX v3, modelo de efeitos sonoros que segue prompts com várias etapas
A ElevenLabs lançou o SFX v3, seu mais novo modelo de efeitos sonoros. Segundo a empresa, o modelo cria efeitos sonoros mais ricos e precisos a partir de um único prompt de texto, segue várias instruções em um mesmo prompt com mais confiabilidade (por exemplo: uma multidão comemorando, uma bola caindo e, em seguida, a multidão vaiando) e oferece melhorias em música e vocais.PokeBot lança o RoboAPI, uma API que dá instruções em linguagem natural a braços robóticos
A PokeBot apresentou o RoboAPI em 29 de outubro, com tecnologia do Poke-Aurora, que a empresa chama de seu modelo de ações no mundo. Segundo a empresa, robôs compatíveis podem receber instruções em linguagem natural por meio de uma API simples, sem treinamento específico para cada tarefa.Pika lança H3 Flex, um modelo de vídeo rápido que, segundo a empresa, é o melhor modelo de texto para vídeo com pesos abertos no DesignArena
A Pika apresentou o H3 Flex, que, segundo a empresa, estreia como o modelo nº 1 de pesos abertos no ranking de texto para vídeo do DesignArena (alegação da Pika). A empresa descreve o modelo como feito para iteração profissional: faixas de áudio exportáveis, resoluções de até 4K e geração mais rápida que o tempo real, com um clipe de 15 segundos e trilha sonora em apenas 7 segundos.Phonic 1 estreia em 1º lugar no Speech to Speech Index da Artificial Analysis
A Artificial Analysis (um site de benchmarks, com medições próprias) afirma que o Phonic 1 (High), modelo de speech-to-speech da Phonic, fica em 1º lugar entre 22 no Speech to Speech Index, com 87,1, pouco à frente do Grok Voice 3.0 (86,9). O modelo está disponível pela Phonic API por US$ 0,07 por minuto.Fish Audio lança Drama 3, que a Artificial Analysis classifica como nº 1 entre os modelos de fala com pesos abertos
A Fish Audio lançou o Drama 3, com pesos disponíveis no Hugging Face. A Artificial Analysis (um site de benchmarks, com medições próprias) afirma que ele é o modelo nº 1 com pesos abertos em suas duas arenas de fala e o nº 1 entre todos os modelos em seu benchmark de Robustez de Pronúncia.Artificial Analysis apresenta o AA-Robotics v0.1, um benchmark de modelos que controlam um braço robótico
A Artificial Analysis publicou o AA-Robotics v0.1, no qual modelos controlam um braço robótico e mostram a tarefa do ponto de vista do modelo. Em um exemplo em que o mesmo robô escreve "hello world", a Artificial Analysis diz que Claude Opus 5.5 escreveu dando toques ponto a ponto, com 3.270 movimentos do braço ao longo de 34 minutos, enquanto GPT-6 Astra escreveu com traços contínuos, com 514 movimentos em 13 minutos.ElevenLabs apresenta Cue, um modelo de alinhamento forçado
A área de pesquisa da ElevenLabs apresentou Cue, um modelo de alinhamento forçado: a etapa que transforma uma transcrição em marcações de tempo, usadas em legendas, dublagem e transcrições clicáveis. Ele posiciona cada caractere na linha do tempo do áudio.Rime lança Prism, um modelo de fala para fala para agentes de voz
A Rime lançou o Prism, um modelo de fala para fala para agentes de voz com IA. Os números abaixo são alegações da própria Rime, não medições independentes.Artificial Analysis lança o AA-Video-I2V v2.1, benchmark para modelos de imagem para vídeo
A Artificial Analysis lançou o AA-Video-I2V v2.1 e o AA-Video-I2V-Silent v2.1, benchmarks para modelos de imagem para vídeo. Cada prompt combina uma imagem inicial em 1080p com um prompt criado para ela e é classificado por caso de uso, capacidade e estilo visual; os modelos são avaliados em até 1080p e ranqueados em 10 casos de uso e 10 capacidades. A classificação geral usa amostras distribuídas igualmente entre eles. Os resultados são da própria Artificial Analysis.
OpenBMB lança MiniCPM-OCR, um parser de documentos de 1B, com um modelo de 2B que avalia resultados de OCR
A OpenBMB apresentou o MiniCPM-OCR no X em 28 de outubro, rodando localmente em um iPhone e um iPad. Lançado com pesos abertos, ele pode ser executado com llama.cpp, vLLM, SGLang ou Ollama; o código de fine-tuning é open source, e a OpenBMB também oferece uma demonstração e uma API.AssemblyAI lança seu primeiro modelo de conversão de texto em fala, AssemblyAI-TTS-1
A AssemblyAI lançou o AssemblyAI-TTS-1, seu primeiro modelo de conversão de texto em fala, criado para agentes de voz. A AssemblyAI afirma que ele transmite áudio em 90 ms por US$ 15 por milhão de caracteres e o considera o melhor modelo de TTS que você pode executar em escala quando se leva em conta, em conjunto, precisão, naturalidade e custo. A OpenRouter informa que o modelo já está disponível na plataforma, com mais de 4.000 vozes hospedadas nos EUA ou na UE.