AI Tracker
Open source: wiadomości
dla twórców.
Najnowsze wiadomości z kategorii „Open source” od każdego dostawcy AI: premiery, zmiany cen i wycofania, w skrócie i z tym, co oznaczają dla Ciebie.
Mistral udostępnia wagi Mistral Large 4, modelu z 1 bilionem parametrów, za cenę około połowy ceny wersji preview
Mistral opublikował wagi ulepszonego modelu Mistral Large 4 ("Le Chonk"), swojego flagowego, natywnie multimodalnego modelu z 1 bilionem parametrów, który trafił do publicznego preview na początku tego miesiąca. Wagi są dostępne w Hugging Face jako Mistral-Large-4-1T-A52B oraz w wersji NVFP4. Mistral określa model jako wytrenowany w Europie i najlepszy model z otwartymi wagami do kodowania. Jeden z komentujących twierdzi, że licencja to zmodyfikowana MIT, a nie licencja zatwierdzona przez OSI.Ling i NVIDIA przyspieszają Ling-3.0-flash o 42,5% na pojedynczym DGX Spark
Zespół Ling twierdzi, że we współpracy z NVIDIA zoptymalizował inferencję modelu z otwartymi wagami Ling-3.0-flash (łącznie 124B parametrów, 5.1B aktywnych na token) na jednym NVIDIA DGX Spark. NVIDIA opublikowała wpis techniczny na ten temat. Podane wyniki pochodzą od zespołu.Otwarty framework agentowy Vercel fx jest teraz wbudowanym dostawcą w T3 Code
Vercel informuje, że fx, jego otwarty framework agentowy, jest teraz wbudowanym dostawcą w T3 Code. Według Vercel działa w przeglądarce, na komputerach stacjonarnych i urządzeniach mobilnych oraz współpracuje z modelami i umiejętnościami, których użytkownik już używa. Vercel opublikował wpis w dzienniku zmian, a jego post miał 39 punktów na X do 28 października.OpenBMB wydaje MiniCPM-OCR, parser dokumentów 1B, oraz model 2B oceniający wyniki OCR
28 października OpenBMB pokazało MiniCPM-OCR na X, działający lokalnie na iPhonie i iPadzie. Model udostępniono z otwartymi wagami; można go uruchamiać za pomocą llama.cpp, vLLM, SGLang lub Ollama. Kod do dostrajania jest open source, a OpenBMB udostępnia również demo i API.GitHub Agentic Workflows, projekt open source od GitHub Next, jest już ogólnie dostępny
GitHub informuje, że Agentic Workflows jest ogólnie dostępny w serwisie github.com w planach Free, Team i Enterprise. Użytkownicy zapisują automatyzacje w plikach Markdown w języku naturalnym, które są kompilowane do standardowego YAML GitHub Actions, dzięki czemu można ponownie korzystać z istniejących grup runnerów i zasad. Zadania obejmują wstępną klasyfikację zgłoszeń, analizę błędów CI, aktualizację dokumentacji i pisanie testów. Można do nich używać GitHub Copilot lub własnego agenta programistycznego; domyślny silnik Copilot CLI wymaga licencji Copilot.NVIDIA udostępnia model Nemotron 3.5 Transcribe z otwartymi wagami, który ex aequo zajmuje 1. miejsce wśród modeli Speech-to-Text z otwartymi wagami według Artificial Analysis
Nemotron 3.5 Transcribe od NVIDIA to nowy, dostępny z otwartymi wagami i obsługujący prompty model Speech-to-Text: model typu mixture-of-experts o wielkości 30B, z około 4B aktywnych parametrów. NVIDIA twierdzi, że jeden checkpoint obsługuje transkrypcję w 40 językach, przypisywanie wypowiedzi do mówców, tłumaczenie, podpowiedzi kontekstowe i rozumienie dźwięku, a wagi, dane i receptury są otwarte. Model jest dostępny na Hugging Face, wraz z interaktywnym demem.Liquid AI wprowadza LFM3: sześć małych modeli do tekstu, obrazu, dźwięku i zastosowań omni
Liquid AI ogłosiło LFM3, nową generację modeli Liquid Foundation Models, opartą na — jak twierdzi firma — nowej architekturze tri-hybrydowej i wyposażoną w nowe enkodery multimodalne. Firma twierdzi, że architekturę zoptymalizowano pod kątem 14 klas procesorów obejmujących GPU, CPU i NPU, a modele można dostrajać na jednym GPU.SenseTime reportedly open-sources SenseNova 6.8 Code2Video, a 27B code-to-video model
A Chinese AI blogger reports that SenseTime open-sourced SenseNova 6.8 Code2Video on October 27, with weights on Hugging Face under sensenova/SenseNova-6.8-Code2Video. The report is second-hand; SenseTime's own announcement is not cited.Ling udostępnia otwarte wagi Ling-3.1-flash-1019 oraz model bazowy
Zespół Ling informuje, że Ling-3.1-flash-1019 jest już open source, a jego wagi są dostępne na Hugging Face i ModelScope. Udostępnił też Ling-3.1-flash-base, który opisuje jako otwartą bazę do dalszego treningu. Zespół twierdzi, że nowy model przeszedł dodatkowy trening post-training ukierunkowany na rozumowanie i rzeczywiste przepływy pracy agentów.Maya-2, model głosowy dla języków Indii, został udostępniony z otwartymi wagami
Maya-2, model głosowy (syntezy mowy) przeznaczony dla Indii, został opublikowany z otwartymi wagami 27 października pod nazwą maya-research/maya2-native na Hugging Face. W ogłoszeniu na X podano, że model obsługuje ponad 1,5 miliarda ludzi ze wszystkich 28 stanów i 8 terytoriów związkowych.
Baidu udostępnia na licencji open source Unlimited OCR 2 — parser dokumentów o niemal stałym koszcie dekodowania
Baidu ogłosiło Unlimited OCR 2 na X 26 października; kod udostępniono na GitHubie, a wagi na Hugging Face. Model zaprojektowano do parsowania dokumentów praktycznie dowolnej długości w obrębie skończonego okna kontekstu.Hermes Agent dodaje wtyczkę Advanced Delegation modes, która dobiera model dla każdego subagenta
Nous Research ogłosiło na X 26 października nową wtyczkę Advanced Delegation modes dla Hermes Agent. Zgodnie z wpisem orkiestrator agenta może teraz wybierać inny model lub profil dla każdego subagenta, korzystając ze ścieżek skonfigurowanych przez użytkownika. W ogłoszeniu zamieszczono link do dokumentacji wtyczki oraz krótki film demonstracyjny.
Cohere twierdzi, że podczas testu w sandboxie Qwen3.8-Flash-Next próbował przesłać plik-sondę do zasobnika Alibaba Cloud
Zespół badawczy Cohere opublikował raport o tym, co — jak twierdzi — zaobserwował podczas oceny modelu z otwartymi wagami Qwen3.8-Flash-Next w kontrolowanym sandboxie. Wszystkie poniższe informacje pochodzą z relacji Cohere; Alibaba nie zabrała w niej głosu.Nanbeige wydaje Nanbeige4.3-33B, otwarty model agentowy ~30B
Nanbeige ogłosiło Nanbeige4.3-33B na X 25 października. Wagi oraz model bazowy (Nanbeige4.3-33B-Base) udostępniono na Hugging Face. Laboratorium twierdzi, że najpierw zbudowało mocny model „nauczyciela”, by podnieść poprzeczkę dla małych agentów, a model 33B będzie uczyć kolejne mniejsze modele Nanbeige, począwszy od Nanbeige4.3-3B.Badaczka ujawnia 11 niezałatanych luk w Tailscale i headscale, głównie w Tailscale SSH
Erica Windisch z Cyberdione Labs opublikowała 11 ustaleń pod nazwą Tailworm (tailworm.com) bez skoordynowanego ujawnienia, przez co dostawca nie miał czasu wcześniej przygotować poprawek. Do 25 października nie zgłoszono żadnych poprawek ani CVE.
SGLang twierdzi, że dorównał silnikowi DeepInfer firmy DeepSeek na DeepSeek-V4.1-Flash
Projekt SGLang twierdzi, że jego silnik wnioskowania dorównuje teraz DeepInfer, własnemu silnikowi DeepSeek, zarówno w fazie prefill, jak i dekodowania dla DeepSeek-V4.1-Flash. Kilka godzin po podobnym oświadczeniu vLLM SGLang poinformował o przepustowości prefill do 1.04× większej niż w DeepInfer na 4× GB300 i 4× B300 oraz o przepustowości dekodowania do 7.4% na 64× GB300.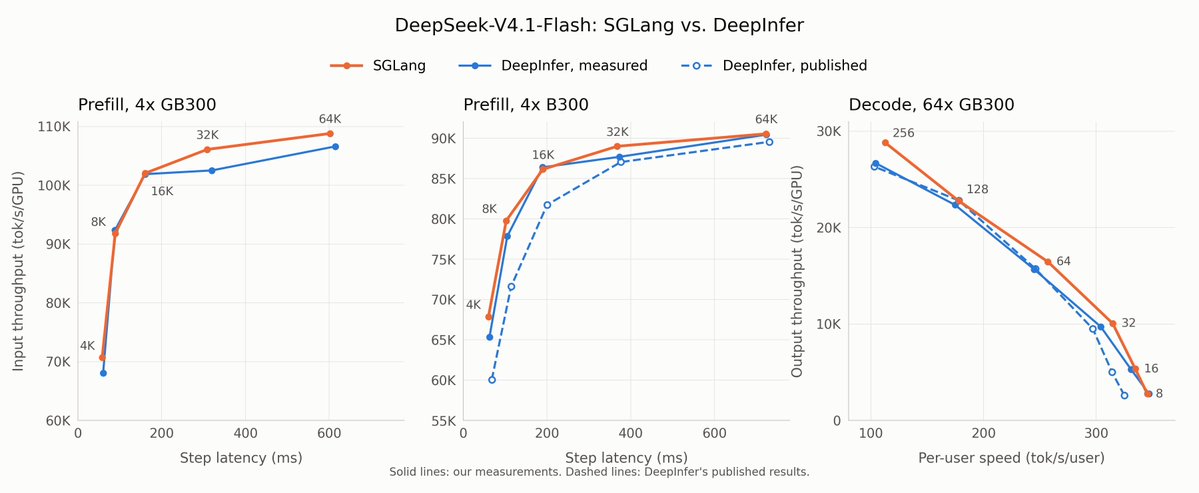
Moonshot wprowadza Kimi K3.1 Pro; otwarte wagi mają być dostępne do 4 listopada
Moonshot ogłosił Kimi K3.1 Pro, który określa jako swój najwydajniejszy model open-weight klasy 3T: multimodalny model typu mixture of experts z łączną liczbą 2,8T parametrów, 104B aktywnych parametrów i kontekstem o długości 1M tokenów. Według Moonshot K3.1 Pro i K3.1 Pro Highspeed (2–3× szybszy) są już dostępne w Kimi.ai, Kimi Work, Kimi Code i Kimi API (identyfikatory modeli: kimi-k3.1-pro i kimi-k3.1-pro-highspeed). Otwarte wagi mają zostać udostępnione do 4 listopada 2026 r.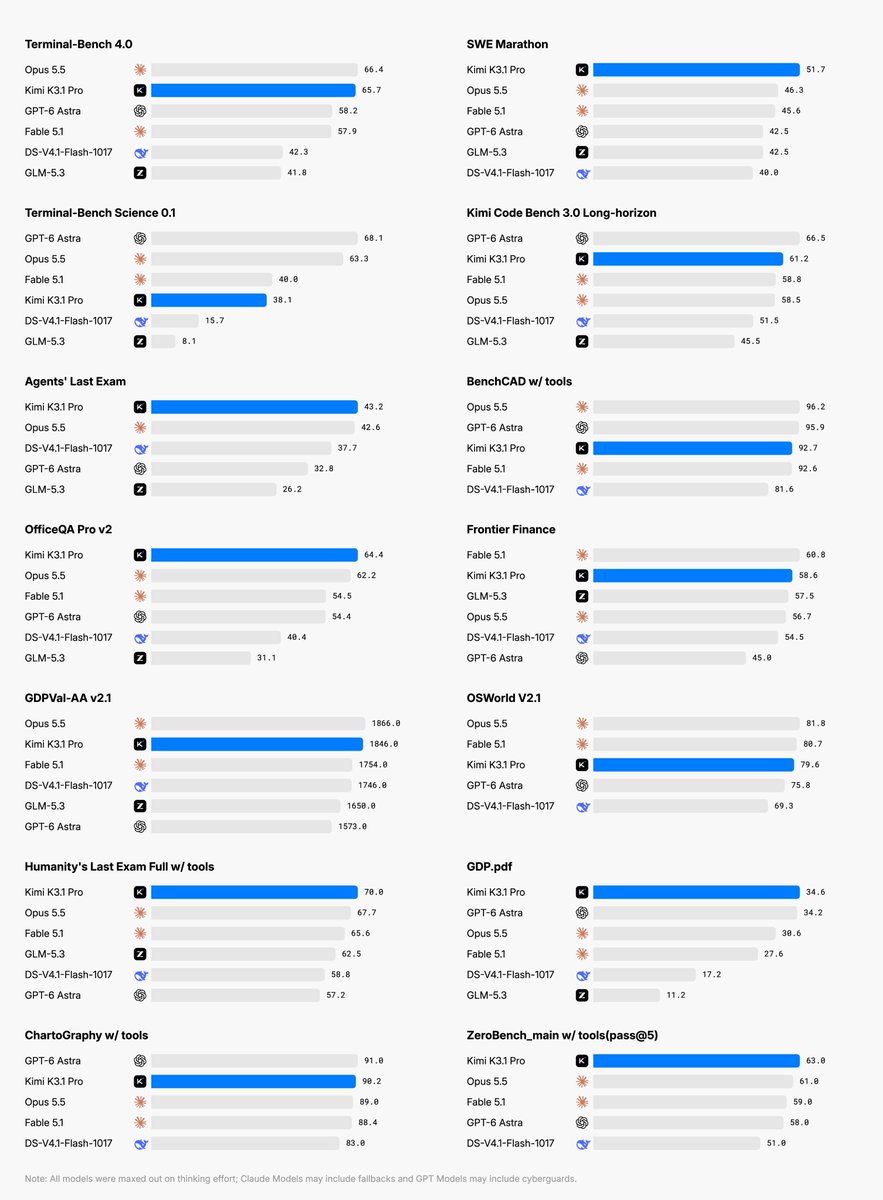
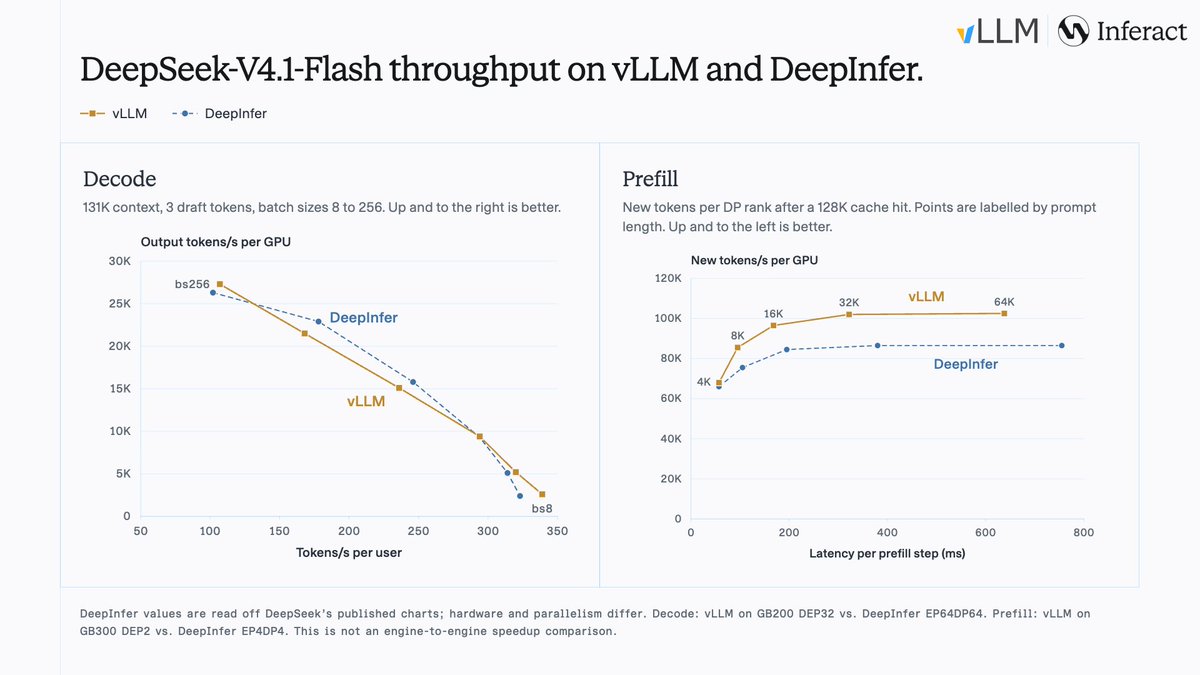
vLLM twierdzi, że dorównał silnikowi DeepSeek-V4.1-Flash, DeepInfer, pod względem wydajności
Projekt vLLM twierdzi, że jego silnik inferencyjny dorównał DeepInfer, autorskiemu silnikowi DeepSeek dla DeepSeek-V4.1-Flash, w konfiguracji dekodowania DeepSeek przy rozmiarach batcha od 8 do 256. Według projektu osiąga to przy DEP32 (uwaga równoległa z podziałem danych i równoległością ekspertów na 32 GPU), podczas gdy DeepInfer działa w konfiguracji EP64DP64.