 AI Tracker
Artificial Analysis publie la version 2.0 de son Coding Agent Index ; Claude Code avec Opus 5.5 arrive en tête avec 61,7
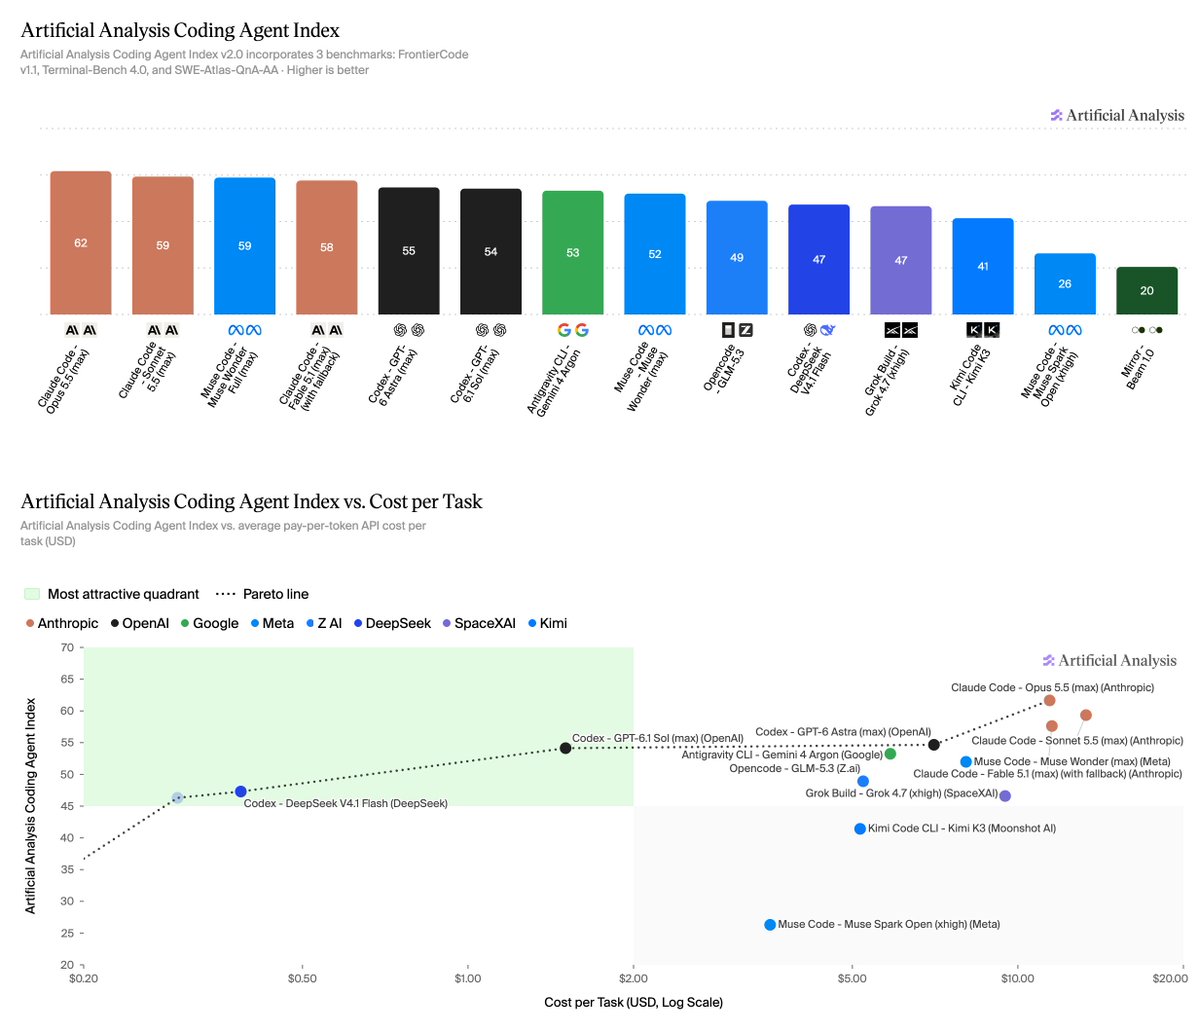
Artificial Analysis a lancé la version 2.0 de son Coding Agent Index, qui évalue les modèles avec leurs environnements d’agent sur 290 tâches couvrant le génie logiciel, l’utilisation du terminal et les questions-réponses sur les dépôts, avec une pondération égale. Les scores sont ceux d’Artificial Analysis et n’ont pas été vérifiés de manière indépendante.
Changements par rapport à la v1.5 :
- FrontierCode v1.1 de Cognition remplace DeepSWE v1.1. Il comprend 100 tâches sur de véritables dépôts open source et dispose d’un jeu de tests privé ; les changements sont évalués selon qu’un mainteneur les accepterait ou non. Toute tentative signalée pour avoir accédé à des éléments de solution obtient un score nul.
- SWE-Atlas-QnA-AA révise l’évaluation des 124 tâches de questions-réponses sur des dépôts de Scale AI : 127 des 1 306 critères de la grille ont été reformulés et le juge est désormais GPT-6 Luna (xhigh), avec cinq votes par critère.
- Terminal-Bench 4.0 ne change pas.
- Les scores baissent pour presque toutes les configurations évaluées dans les deux versions : la moyenne passe de 54,8 à 47,4, principalement à cause de FrontierCode (moyenne de 45,1 % contre 65,6 % pour DeepSWE).
Résultats :
- Index : Claude Code avec Claude Opus 5.5 (max) obtient 61,7, devant Claude Code avec Claude Sonnet 5.5 (59,3), Muse Code avec Muse Wonder Full (58,9) et Claude Code avec Claude Fable 5.1 (57,6).
- FrontierCode : Opus 5.5 obtient 56,0 %, suivi de Codex avec DeepSeek V4.1 Flash (52,6 %), Codex avec GPT-6.1 Sol (49,4 %) et Codex avec GPT-6 Astra (49,3 %). Sur les 24 configurations, 15 obtiennent entre 43 % et 49 %.
- SWE-Atlas-QnA-AA : Muse Code avec Muse Wonder Full arrive en tête avec 68,8 %, suivi de Claude Code avec Fable 5.1 (66,4 %) et Opus 5.5 (65,9 %).
- Coût par tâche (coûts d’API à la consommation, par token) : Codex avec DeepSeek V4.1 Flash obtient 47,3 pour 0,39 $, Codex avec GPT-6.1 Sol 54,1 pour 1,50 $, Codex avec GPT-6 Astra 54,7 pour 7,04 $, et Claude Code avec Opus 5.5 61,7 pour 11,42 $.
Sources
Discussions
- Coding agent score vs API cost per task, Artificial Analysis Index v2.0:X · 6 commentaires
Recevez ce genre d'actus en notification.
AI Tracker vous prévient dès que quelque chose change pour les outils que vous utilisez.