 AI Tracker
Artificial AnalysisがCoding Agent Index v2.0を公開、Claude Code with Opus 5.5が61.7で首位
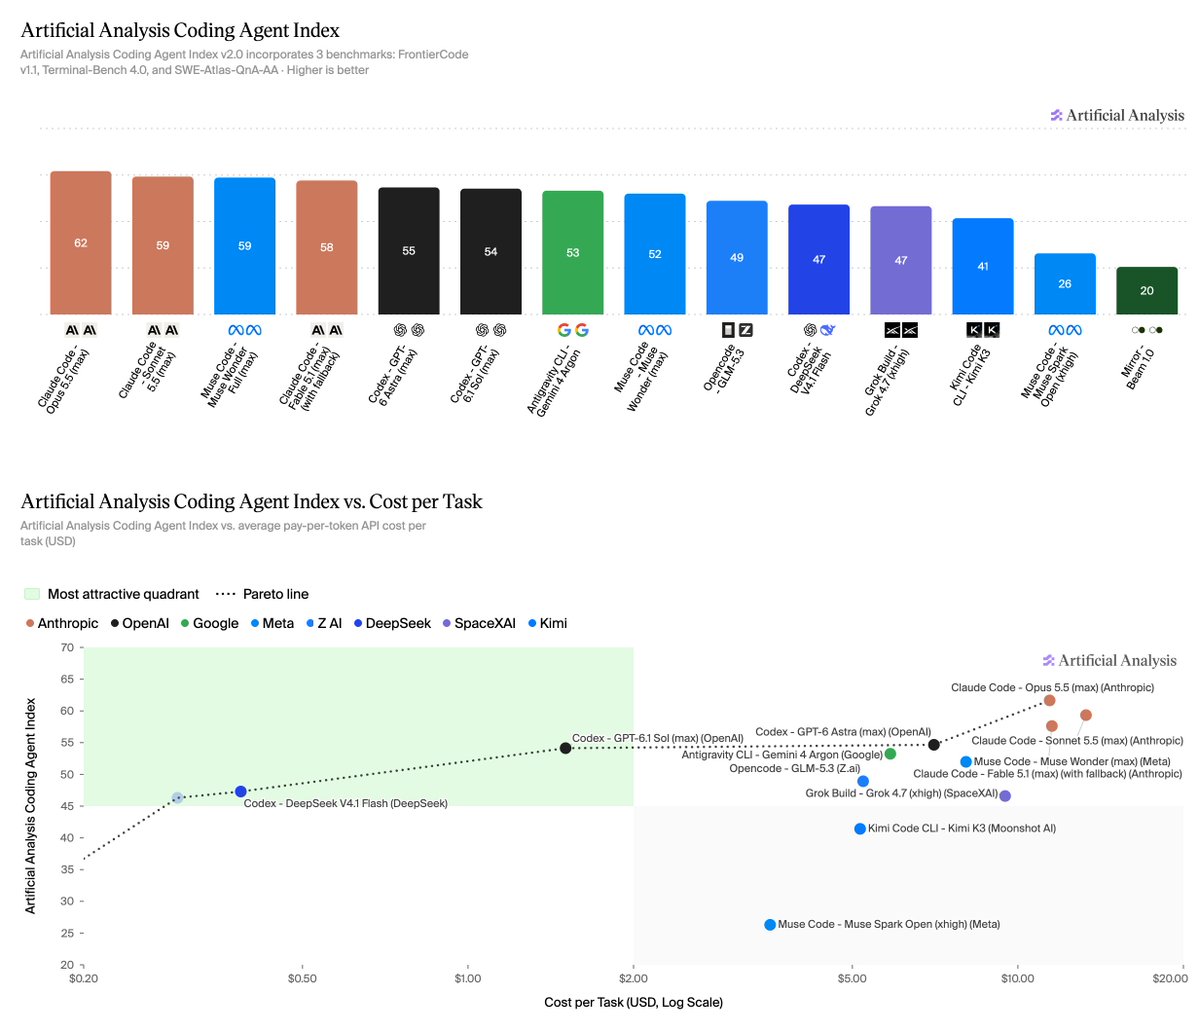
Artificial AnalysisはCoding Agent Indexのv2.0を公開しました。この指数では、ソフトウェアエンジニアリング、ターミナルの使用、リポジトリに関するQ&Aの290タスクを対象に、モデルとそのエージェントハーネスを同じ比重で評価します。スコアはArtificial Analysis独自のもので、独立した検証は受けていません。
v1.5からの変更点:
- CognitionのFrontierCode v1.1がDeepSWE v1.1に置き換わりました。非公開のテストセットを用いて実際のオープンソースリポジトリ上の100タスクを評価し、メンテナーが変更をマージするかどうかを基準に採点します。解答資料へのアクセスが検出された試行は0点になります。
- SWE-Atlas-QnA-AAでは、Scale AIのリポジトリQ&A 124タスクの採点方法が改訂されました。1,306のルーブリック基準のうち127項目の表現が変更され、判定にはGPT-6 Luna (xhigh)を使用し、各基準につき5票で評価します。
- Terminal-Bench 4.0に変更はありません。
- 両バージョンで測定されたほぼすべての構成でスコアが低下しました。平均は54.8から47.4に下がっており、主な要因はFrontierCodeです(平均45.1%、DeepSWEでは65.6%)。
結果:
- Index: Claude Code with Claude Opus 5.5 (max)が61.7で首位。Claude Code with Claude Sonnet 5.5(59.3)、Muse Code with Muse Wonder Full(58.9)、Claude Code with Claude Fable 5.1(57.6)が続きます。
- FrontierCode: Opus 5.5が56.0%で首位。Codex with DeepSeek V4.1 Flash(52.6%)、Codex with GPT-6.1 Sol(49.4%)、Codex with GPT-6 Astra(49.3%)が続きます。24構成のうち15構成は43%から49%の範囲です。
- SWE-Atlas-QnA-AA: Muse Code with Muse Wonder Fullが68.8%で首位。Claude Code with Fable 5.1(66.4%)、Opus 5.5(65.9%)が続きます。
- タスクあたりのコスト(トークン従量制API料金):Codex with DeepSeek V4.1 Flashは$0.39で47.3、Codex with GPT-6.1 Solは$1.50で54.1、Codex with GPT-6 Astraは$7.04で54.7、Claude Code with Opus 5.5は$11.42で61.7です。
ソース
ディスカッション
こんなニュースをプッシュで。
使っているツールに変化があると、AI Tracker がお知らせします。