 AI Tracker
Artificial Analysis, Coding Agent Index v2.0’ı yayımladı; Opus 5.5 kullanan Claude Code 61,7 puanla lider
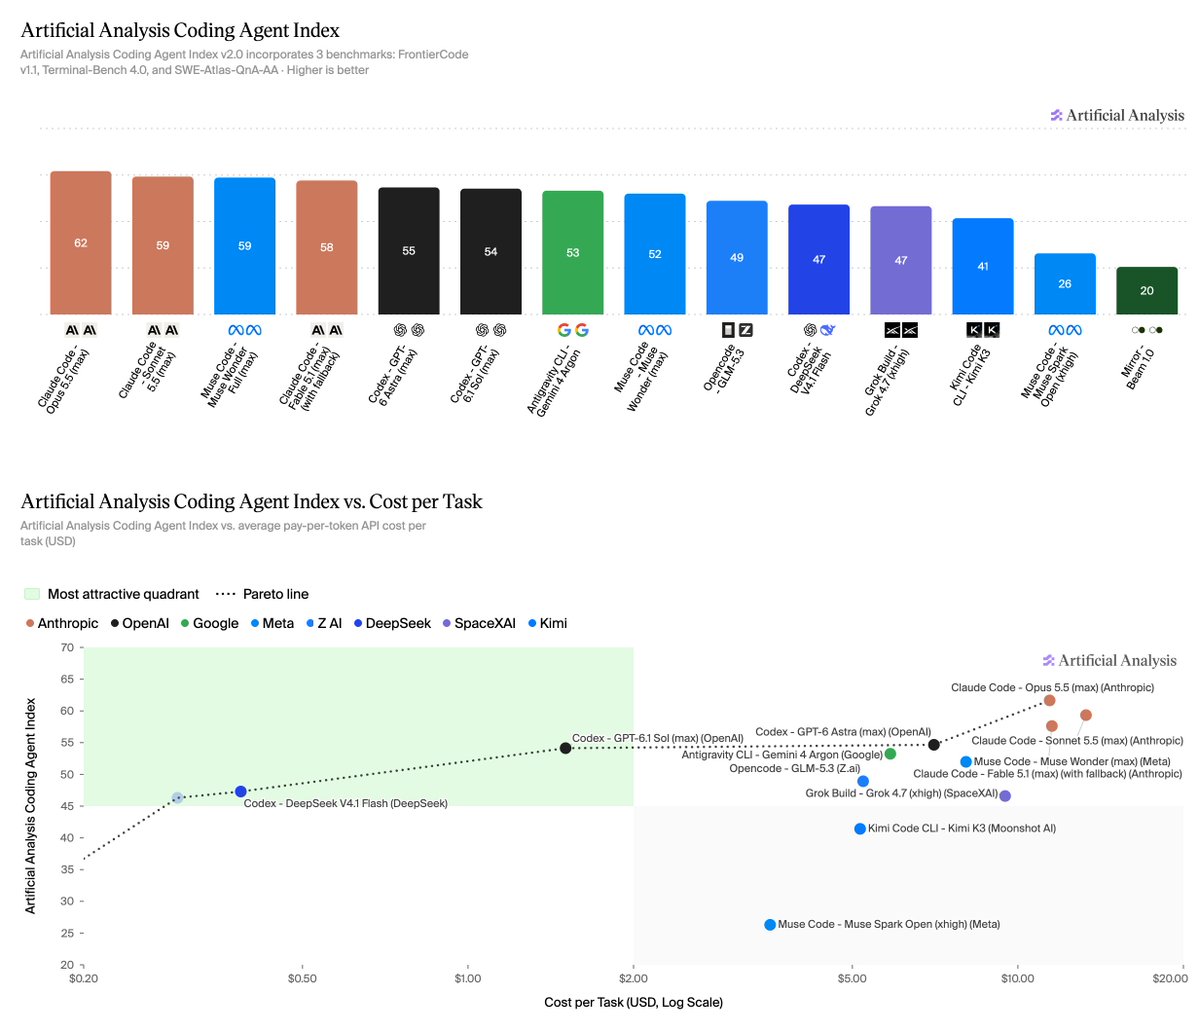
Artificial Analysis, Coding Agent Index’in v2.0 sürümünü kullanıma sundu. Bu sürümde modeller, yazılım mühendisliği, terminal kullanımı ve depo soru-cevap alanlarında toplam 290 görev üzerinden, eşit ağırlıklarla, kendi agent harness’leriyle birlikte puanlanıyor. Puanlar Artificial Analysis’ın kendi değerlendirmeleri olup bağımsız olarak doğrulanmış değil.
v1.5’ten değişenler:
- Cognition’ın FrontierCode v1.1 modeli, DeepSWE v1.1’in yerini alıyor. Gerçek açık kaynak depolarında yürütülen ve özel bir test kümesine sahip 100 görev içeriyor. Değerlendirme, bir bakımcının değişikliği birleştirip birleştirmeyeceğine göre yapılıyor; çözüm materyaline eriştiği belirlenen bir deneme sıfır puan alıyor.
- SWE-Atlas-QnA-AA, Scale AI’ın 124 depo soru-cevap görevinin puanlamasını yeniliyor: 1.306 rubrik ölçütünün 127’sinin ifadesi değiştirildi ve artık her ölçüt için beş oyla GPT-6 Luna (xhigh) hakem olarak kullanılıyor.
- Terminal-Bench 4.0’da değişiklik yok.
- Her iki sürümde de ölçülen yapılandırmaların neredeyse tamamının puanı düştü: ortalama 54,8’den 47,4’e geriledi. Bunun başlıca nedeni FrontierCode (DeepSWE’deki %65,6’ya kıyasla ortalama %45,1).
Sonuçlar:
- Endeks: Claude Opus 5.5 (max) kullanan Claude Code 61,7 puanla; Claude Sonnet 5.5 kullanan Claude Code’un (59,3), Muse Wonder Full kullanan Muse Code’un (58,9) ve Claude Fable 5.1 kullanan Claude Code’un (57,6) önünde.
- FrontierCode: Opus 5.5 %56,0 puan aldı. Onu DeepSeek V4.1 Flash kullanan Codex (%52,6), GPT-6.1 Sol kullanan Codex (%49,4) ve GPT-6 Astra kullanan Codex (%49,3) izledi. 24 yapılandırmanın 15’i %43 ile %49 arasında puan aldı.
- SWE-Atlas-QnA-AA: Muse Wonder Full kullanan Muse Code %68,8 ile lider; ardından Fable 5.1 kullanan Claude Code (%66,4) ve Opus 5.5 kullanan Claude Code (%65,9) geliyor.
- Görev başına maliyet (kullandıkça öde API maliyetleri): DeepSeek V4.1 Flash kullanan Codex, 0,39 $ karşılığında 47,3 puan; GPT-6.1 Sol kullanan Codex, 1,50 $ karşılığında 54,1 puan; GPT-6 Astra kullanan Codex, 7,04 $ karşılığında 54,7 puan; Opus 5.5 kullanan Claude Code ise 11,42 $ karşılığında 61,7 puan aldı.
Kaynaklar
Tartışmalar
Bu tür haberleri bildirim olarak alın.
Kullandığınız araçlarda bir şey değiştiğinde AI Tracker sizi uyarır.