 AI Tracker
Artificial Analysis, Coding Agent Index v2.0 공개… Claude Code와 Opus 5.5가 61.7점으로 선두
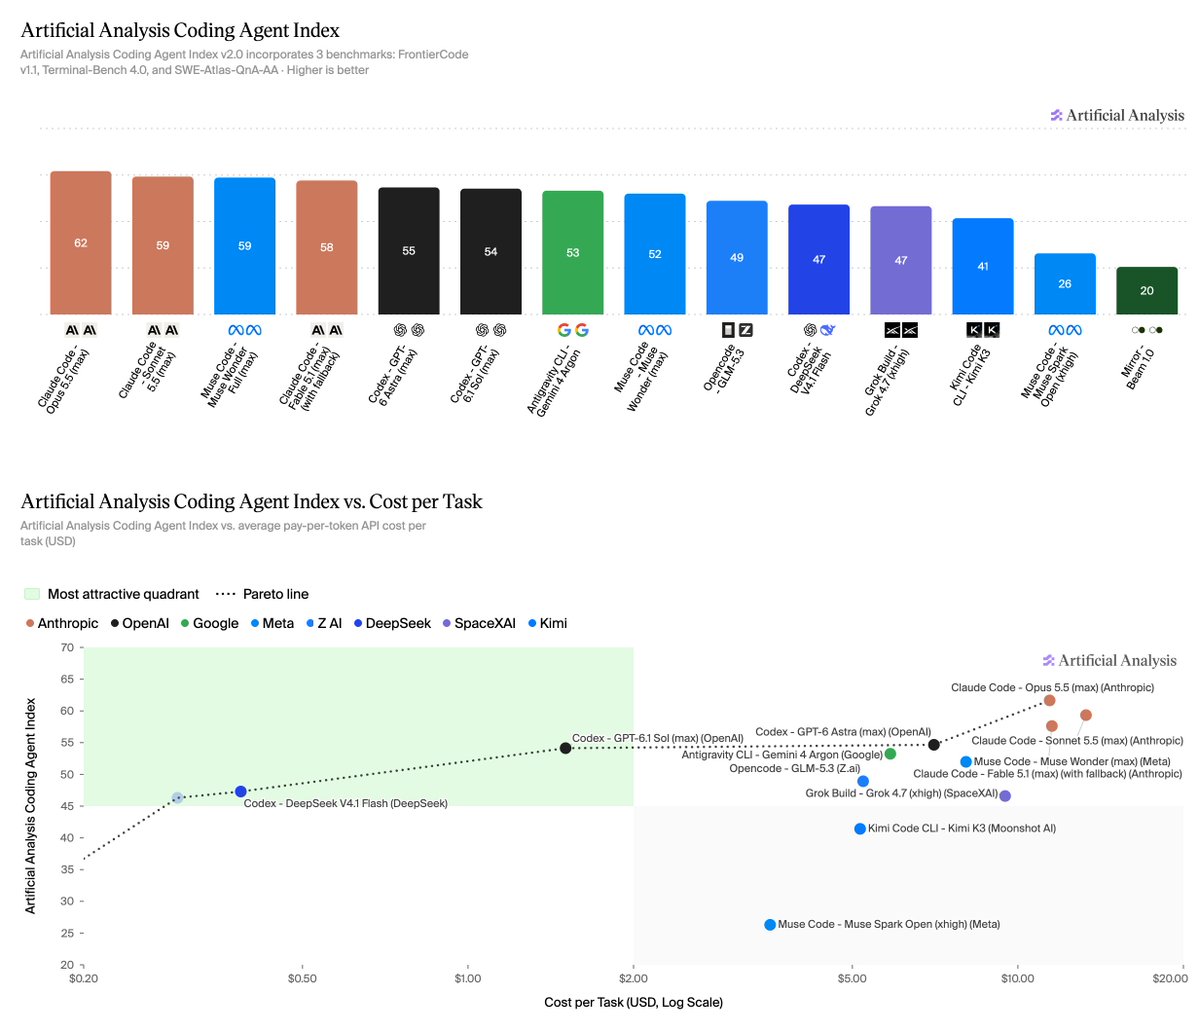
Artificial Analysis가 Coding Agent Index v2.0을 공개했습니다. 이 지수는 소프트웨어 엔지니어링, 터미널 사용, 저장소 Q&A에 걸친 290개 과제에서 모델과 에이전트 하네스를 함께 평가하며, 각 항목에 동일한 가중치를 부여합니다. 점수는 Artificial Analysis 자체 평가이며, 독립적으로 검증되지는 않았습니다.
v1.5 대비 변경 사항:
- FrontierCode v1.1(Cognition)이 DeepSWE v1.1을 대체합니다. 비공개 테스트 세트를 갖춘 실제 오픈소스 저장소 과제 100개로 구성되며, 유지 관리자가 변경 사항을 병합할지 여부를 기준으로 채점합니다. 정답 자료에 접근한 것으로 표시된 시도는 0점 처리됩니다.
- SWE-Atlas-QnA-AA는 Scale AI의 저장소 Q&A 과제 124개의 채점 방식을 개정합니다. 루브릭 기준 1,306개 중 127개의 문구를 수정했고, 이제 GPT-6 Luna (xhigh)가 기준마다 5표로 판정합니다.
- Terminal-Bench 4.0은 변경되지 않았습니다.
- 두 버전에서 모두 측정된 거의 모든 구성의 점수가 하락했습니다. 평균은 54.8점에서 47.4점으로 떨어졌으며, 주된 원인은 FrontierCode입니다(평균 45.1%, DeepSWE는 65.6%).
결과:
- 지수: Claude Code와 Claude Opus 5.5 (max)가 61.7점으로 선두를 차지했습니다. Claude Code와 Claude Sonnet 5.5(59.3점), Muse Code와 Muse Wonder Full(58.9점), Claude Code와 Claude Fable 5.1(57.6점)이 뒤를 이었습니다.
- FrontierCode: Opus 5.5가 56.0%를 기록했고, Codex와 DeepSeek V4.1 Flash(52.6%), Codex와 GPT-6.1 Sol(49.4%), Codex와 GPT-6 Astra(49.3%)가 뒤를 이었습니다. 24개 구성 중 15개가 43~49%를 기록했습니다.
- SWE-Atlas-QnA-AA: Muse Code와 Muse Wonder Full이 68.8%로 선두를 차지했고, Claude Code와 Fable 5.1(66.4%), Opus 5.5(65.9%)가 뒤를 이었습니다.
- 과제당 비용(토큰 사용량에 따른 API 요금): Codex와 DeepSeek V4.1 Flash는 $0.39에 47.3점, Codex와 GPT-6.1 Sol은 $1.50에 54.1점, Codex와 GPT-6 Astra는 $7.04에 54.7점, Claude Code와 Opus 5.5는 $11.42에 61.7점을 기록했습니다.
출처
토론
이런 뉴스를 푸시로 받아보세요.
사용하는 도구에 변화가 생기면 AI Tracker가 알려드립니다.