 AI Tracker
Artificial Analysis 發布 Coding Agent Index v2.0;Claude Code 搭配 Opus 5.5 以 61.7 領先
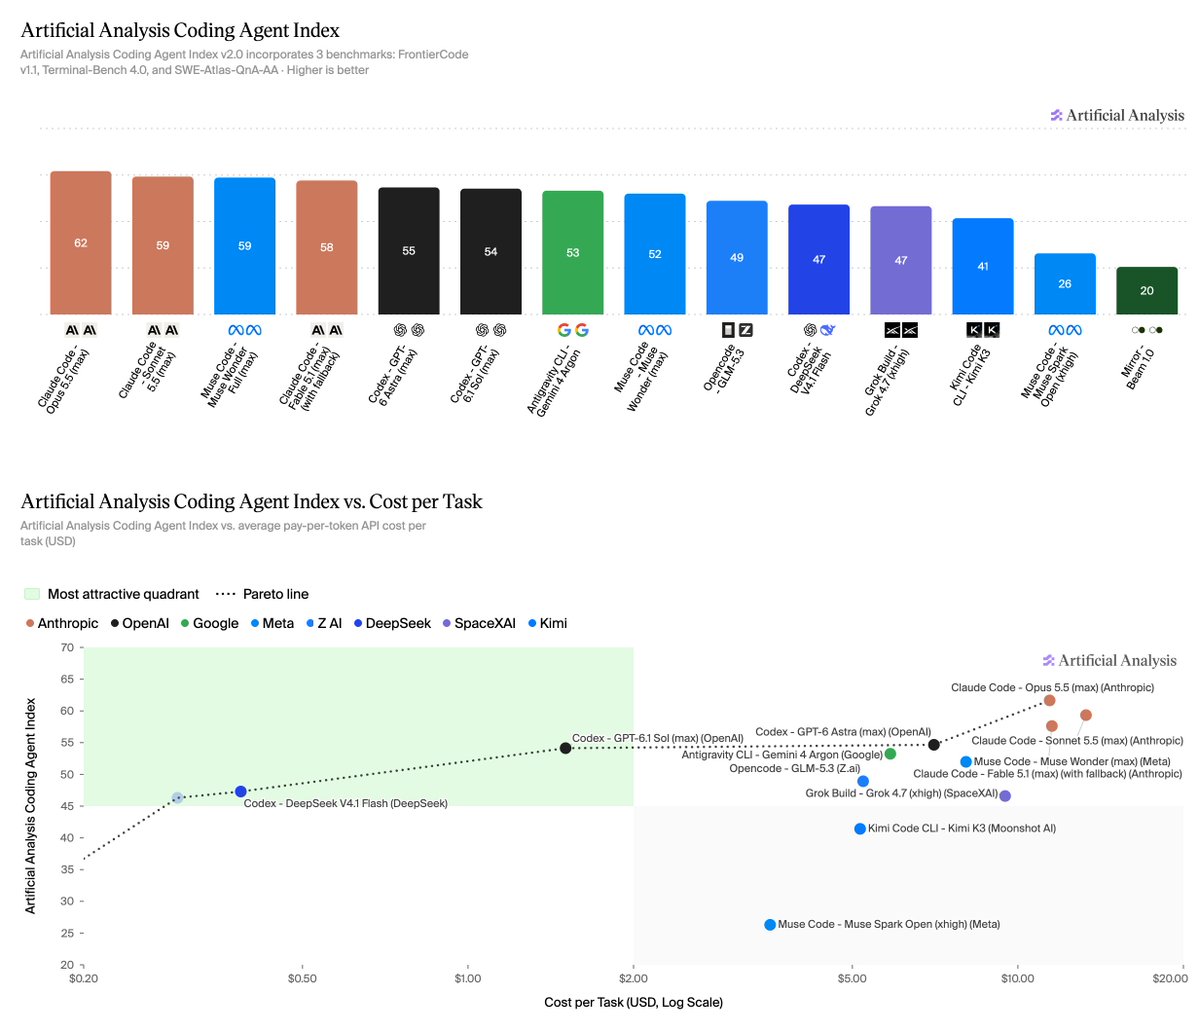
Artificial Analysis 推出 Coding Agent Index v2.0,這項指標會將模型與其 agent harness 一併評分,涵蓋軟體工程、終端機使用和程式碼庫問答等 290 項任務,權重均等。分數由 Artificial Analysis 自行評定,未經獨立驗證。
相較 v1.5 的變更:
- Cognition 的 FrontierCode v1.1 取代 DeepSWE v1.1。此基準包含 100 項使用真實開源程式碼庫的任務,並採用私有測試集;評分依據是維護者是否會合併該變更。若某次嘗試被標記為存取解答材料,分數即為零。
- SWE-Atlas-QnA-AA 調整了 Scale AI 的 124 項程式碼庫問答任務評分方式:1,306 項評分規準中有 127 項經過改寫,評審模型則改為 GPT-6 Luna (xhigh),每項規準投票五次。
- Terminal-Bench 4.0 維持不變。
- 幾乎所有在兩個版本中都有評測的配置,分數都下降:平均分從 54.8 降至 47.4,主要原因是 FrontierCode(平均 45.1%,DeepSWE 則為 65.6%)。
結果:
- Index:Claude Code 搭配 Claude Opus 5.5 (max) 得分 61.7,領先 Claude Code 搭配 Claude Sonnet 5.5 (59.3)、Muse Code 搭配 Muse Wonder Full (58.9),以及 Claude Code 搭配 Claude Fable 5.1 (57.6)。
- FrontierCode:Opus 5.5 得分 56.0%,其次是 Codex 搭配 DeepSeek V4.1 Flash (52.6%)、Codex 搭配 GPT-6.1 Sol (49.4%) 和 Codex 搭配 GPT-6 Astra (49.3%)。24 種配置中有 15 種得分介於 43% 至 49%。
- SWE-Atlas-QnA-AA:Muse Code 搭配 Muse Wonder Full 以 68.8% 領先,其次是 Claude Code 搭配 Fable 5.1 (66.4%) 和 Opus 5.5 (65.9%)。
- 每項任務成本(按 token 計費的 API 費用):Codex 搭配 DeepSeek V4.1 Flash 得分 47.3,費用 $0.39;Codex 搭配 GPT-6.1 Sol 得分 54.1,費用 $1.50;Codex 搭配 GPT-6 Astra 得分 54.7,費用 $7.04;Claude Code 搭配 Opus 5.5 得分 61.7,費用 $11.42。
來源
討論
這樣的新聞,第一時間推播給你。
你使用的 AI 工具一有變化,AI Tracker 就會通知你。