 AI Tracker
Artificial Analysis:ツールなしではClaude Fable 5.2のVIALS-AAスコアが67%から44%に低下し、ツールありのHaiku 5.5を下回る
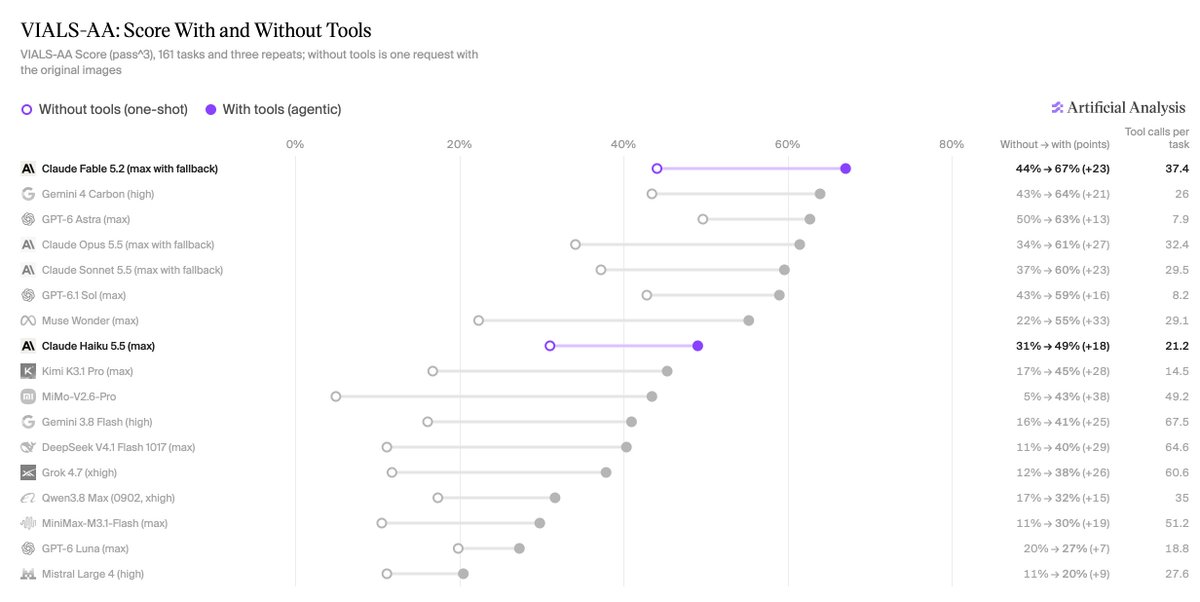
Artificial Analysisは、ライフサイエンス分野の視覚的推論ベンチマークVIALS-AAを、質問と画像を含む単一のリクエストでツールを使わないワンショット形式で再実施した。通常のベンチマークでは、モデルはサンドボックス内で思考し、コードを実行し、画像を確認するエージェントとして動作する。同社によると、モデル全体ではツールの使用によりスコアがほぼ倍増し、平均約25%から約47%になった。
- Fable 5.2 (max): ツールありではタスクあたり$4.20で67%、ツールなしではタスクあたり$0.73で44%。ツールありのClaude Haiku 5.5 (max)を下回る。
- Haiku 5.5 (max): ツールありではタスクあたり$0.07で49%。Artificial Analysisによると、特定のスコアを最も安く達成する方法は、小型モデルにツールを使わせることが多い。Claude Opus 5.5はツールなしで$0.33、34%を記録。
- カウントタスク: 細胞のカウントと定量化に関する23タスクでは、Fableのpass^3率はツールありの65%からツールなしでは9%に低下。Opus 5.5は57%から4%、Claude Sonnet 5.5は65%から13%。GPT-6 Astraは61%から35%、GPT-6.1 Solは61%から39%に低下。系統発生に関する23タスクでは、Astraはツールありで78%、ツールなしで83%を達成。
- 最も効果が大きいモデル: ツールなしで31%未満のスコアだった10モデルは、タスクあたり平均約42回ツールを呼び出した。一方、31%を超えた7モデルは約23回だった。MiMo-V2.6-Proはタスクあたり約49回の呼び出しで5%から43%に上昇。Gemini 3.8 Flash (high)は約68回で16%から41%に上昇。AstraとSolはタスクあたり約8回呼び出し、スコアはそれぞれ13ポイント、16ポイント上昇した。
- コスト: ツールを使うと全モデルでタスクあたりのコストが上昇し、Astraの$0.21から$0.27への増加に対し、Fableでは5.8倍になった。倍率が最も大きかったのはQwen3.8 Max (0902, xhigh)の28倍、Gemini 3.8 Flashの20倍、MiMo-V2.6-Proの15倍。
これらはArtificial Analysis独自の測定結果。
ソース
こんなニュースをプッシュで。
使っているツールに変化があると、AI Tracker がお知らせします。