 AI Tracker
Artificial Analysis: bez narzędzi Claude Fable 5.2 spada z 67% do 44% w VIALS-AA, poniżej Haiku 5.5 z narzędziami
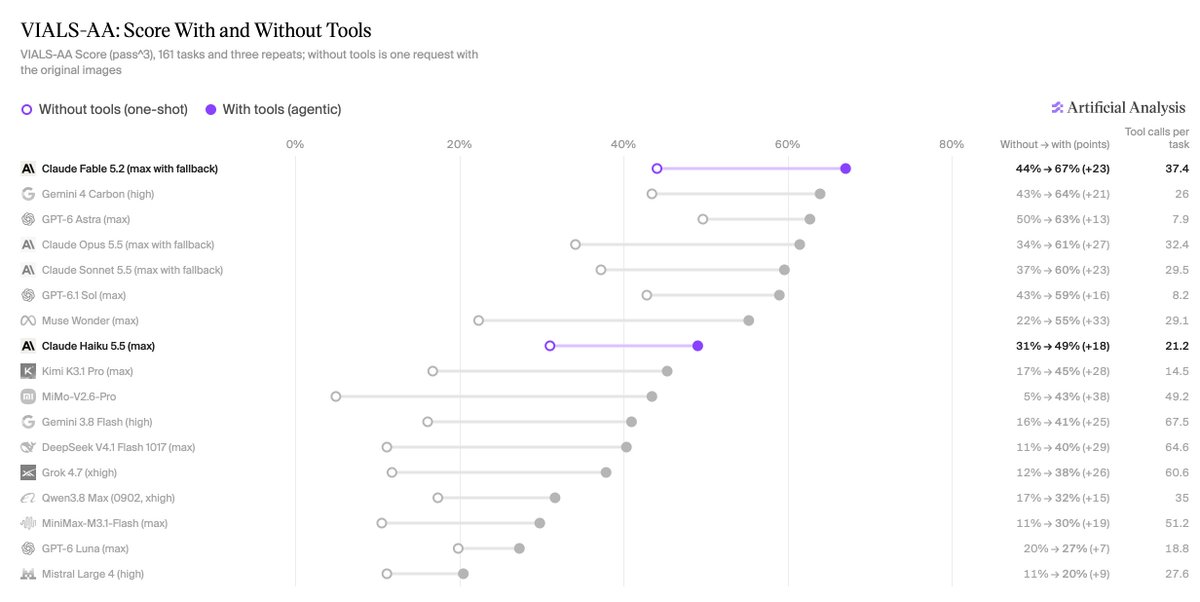
Artificial Analysis ponownie przeprowadziło test VIALS-AA, benchmark rozumowania wizualnego w naukach przyrodniczych, w formacie jednego zapytania: pojedyncze zapytanie zawierało pytanie i obrazy, bez narzędzi. Domyślnie benchmark zakłada, że modele działają jak agenci: rozumują, uruchamiają kod i oglądają obrazy w środowisku izolowanym. Jak podaje Artificial Analysis, użycie narzędzi niemal podwaja wyniki modeli — średnio z około 25% do około 47%.
- Fable 5.2 (max): 67% z narzędziami przy koszcie 4,20 USD za zadanie; 44% bez narzędzi przy koszcie 0,73 USD za zadanie — to wynik niższy niż Claude Haiku 5.5 (max) z narzędziami.
- Haiku 5.5 (max): 49% z narzędziami przy koszcie 0,07 USD za zadanie. Artificial Analysis podaje, że najtańszym sposobem uzyskania danego wyniku jest często użycie mniejszego modelu z narzędziami: Claude Opus 5.5 bez narzędzi uzyskuje 34% przy koszcie 0,33 USD.
- Zadania zliczania: w 23 zadaniach polegających na zliczaniu komórek i kwantyfikacji odsetek zaliczonych zadań Fable spada z 65% z narzędziami do 9% bez nich; Opus 5.5 — z 57% do 4%; Claude Sonnet 5.5 — z 65% do 13%. Wynik GPT-6 Astra spada z 61% do 35%, a GPT-6.1 Sol — z 61% do 39%. W 23 zadaniach z filogenetyki Astra zalicza 78% zadań z narzędziami i 83% bez nich.
- Kto zyskuje najwięcej: dziesięć modeli, które bez narzędzi uzyskują mniej niż 31%, wykonuje średnio około 42 wywołań narzędzi na zadanie, a siedem modeli z wynikiem powyżej tego progu — około 23. MiMo-V2.6-Pro poprawia wynik z 5% do 43% przy około 49 wywołaniach na zadanie; Gemini 3.8 Flash (high) — z 16% do 41% przy około 68 wywołaniach. Astra i Sol wykonują około 8 wywołań na zadanie, a ich wyniki rosną odpowiednio o 13 i 16 punktów procentowych.
- Koszt: narzędzia zwiększają koszt każdego zadania dla wszystkich modeli — od wzrostu z 0,21 USD do 0,27 USD w przypadku Astry po 5,8-krotny wzrost w przypadku Fable. Największe mnożniki odnotowano dla Qwen3.8 Max (0902, xhigh) — 28×, Gemini 3.8 Flash — 20× i MiMo-V2.6-Pro — 15×.
To własne pomiary Artificial Analysis.
Źródła
Otrzymuj takie wiadomości jako push.
AI Tracker powiadomi Cię, gdy coś zmieni się w narzędziach, których używasz.