 AI Tracker
Artificial Analysis:不使用工具时,Claude Fable 5.2 在 VIALS-AA 上的得分从 67% 降至 44%,低于使用工具的 Haiku 5.5
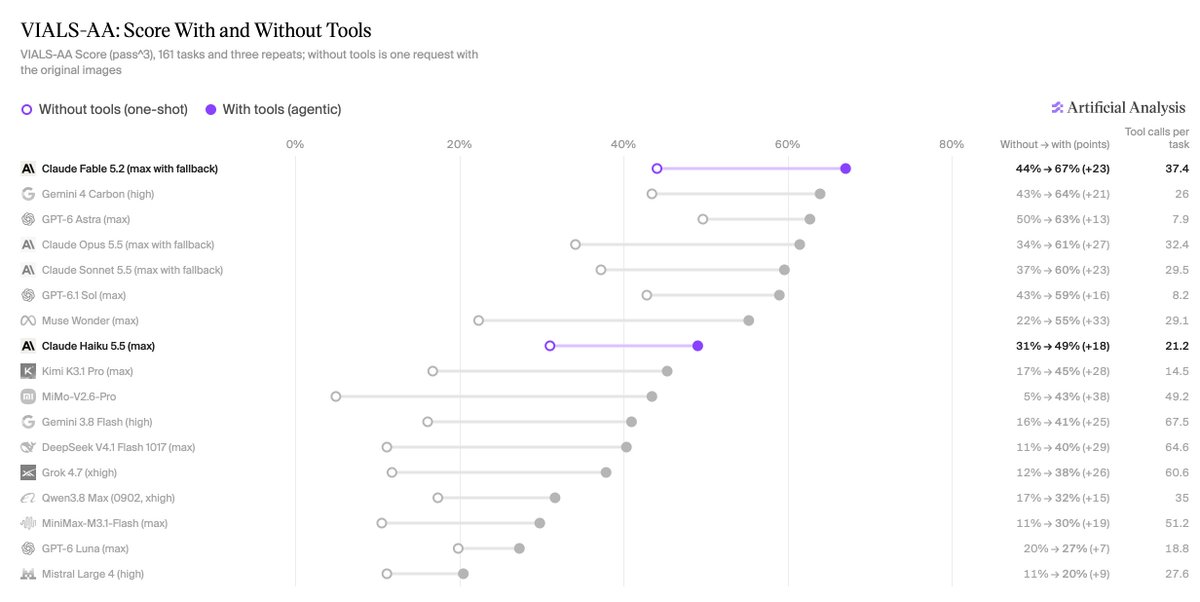
Artificial Analysis 以单次请求形式重新运行了 VIALS-AA(其生命科学视觉推理基准测试):请求中包含问题和图像,且不使用工具。默认情况下,该基准测试会让模型作为智能体运行,在沙盒中思考、运行代码并查看图像。该机构表示,在各模型中,使用工具后得分几乎翻倍,平均分从约 25% 升至约 47%。
- Fable 5.2 (max):使用工具时得分为 67%,每项任务成本 $4.20;不使用工具时得分为 44%,每项任务成本 $0.73,低于使用工具的 Claude Haiku 5.5 (max)。
- Haiku 5.5 (max):使用工具时得分为 49%,每项任务成本 $0.07。Artificial Analysis 表示,要达到某一分数,通常最便宜的方式是使用带工具的较小模型:Claude Opus 5.5 不使用工具时得分为 34%,每项任务成本 $0.33。
- 计数任务:在 23 项细胞计数和定量任务中,Fable 使用工具时的 pass^3 率为 65%,不使用工具时降至 9%;Opus 5.5 从 57% 降至 4%;Claude Sonnet 5.5 从 65% 降至 13%。GPT-6 Astra 从 61% 降至 35%,GPT-6.1 Sol 从 61% 降至 39%。在 23 项系统发育任务中,Astra 使用工具时通过率为 78%,不使用工具时为 83%。
- 哪些模型提升最大:不使用工具时得分低于 31% 的十个模型,平均每项任务调用工具约 42 次;得分高于 31% 的七个模型,平均约 23 次。MiMo-V2.6-Pro 使用工具后,得分从 5% 升至 43%,每项任务约调用 49 次;Gemini 3.8 Flash (high) 从 16% 升至 41%,每项任务约调用 68 次。Astra 和 Sol 每项任务约调用 8 次,得分分别提高 13 和 16 个百分点。
- 成本:对所有模型来说,使用工具都会提高每项任务的成本,从 Astra 的 $0.21 升至 $0.27,到 Fable 的 5.8 倍不等;倍数最高的是 Qwen3.8 Max (0902, xhigh),为 28 倍,其次是 Gemini 3.8 Flash 的 20 倍和 MiMo-V2.6-Pro 的 15 倍。
以上数据为 Artificial Analysis 自行测得。
来源
这样的新闻,第一时间推送给你。
你用的 AI 工具一有变化,AI Tracker 就会提醒你。