 AI Tracker
Artificial Analysis:不使用工具時,Claude Fable 5.2 在 VIALS-AA 的得分從 67% 降至 44%,低於使用工具的 Haiku 5.5
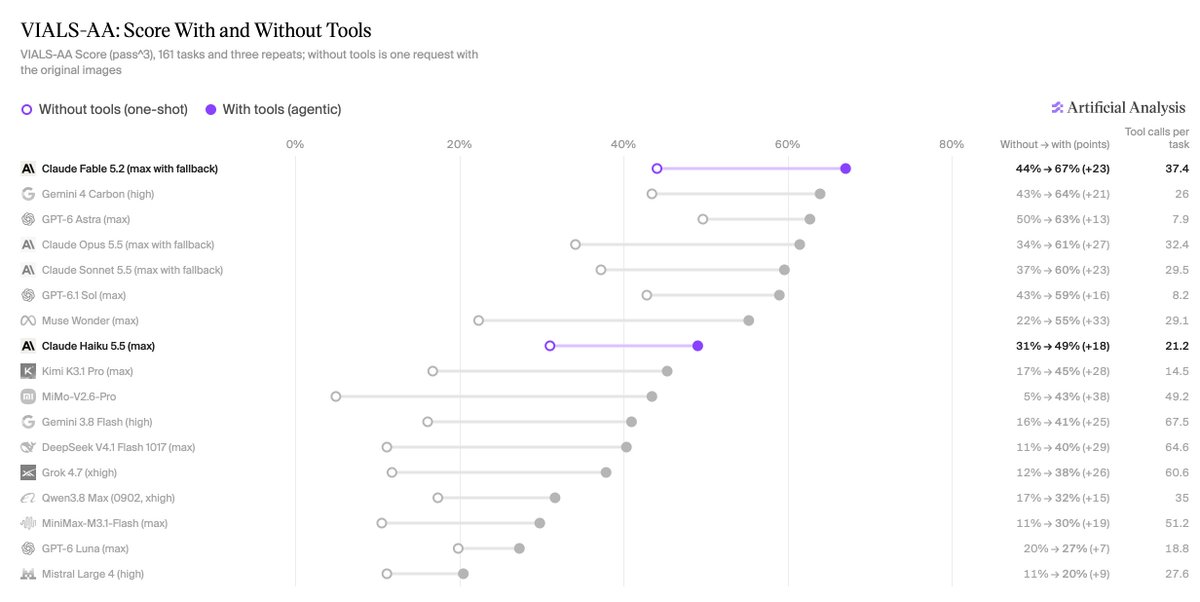
Artificial Analysis 以單次提示格式重新執行其生命科學視覺推理基準測試 VIALS-AA:單一請求中包含問題與圖片,且不使用工具。基準測試預設讓模型以代理程式的方式運作,在沙箱中思考、執行程式碼並檢視圖片。該機構表示,所有模型使用工具後的平均分數幾乎翻倍,從約 25% 升至約 47%。
- Fable 5.2 (max):使用工具時得分 67%,每項任務花費 $4.20;不使用工具時得分 44%,每項任務花費 $0.73,低於使用工具的 Claude Haiku 5.5 (max)。
- Haiku 5.5 (max):使用工具時得分 49%,每項任務花費 $0.07。Artificial Analysis 表示,要達到特定分數,最便宜的方式往往是使用較小型模型搭配工具:Claude Opus 5.5 不使用工具時得分 34%,每項任務花費 $0.33。
- 計數任務:在 23 項細胞計數與量化任務中,Fable 使用工具時的 pass^3 通過率為 65%,不使用工具時降至 9%;Opus 5.5 從 57% 降至 4%;Claude Sonnet 5.5 從 65% 降至 13%。GPT-6 Astra 從 61% 降至 35%,GPT-6.1 Sol 則從 61% 降至 39%。在 23 項系統發育任務中,Astra 使用工具時的通過率為 78%,不使用工具時為 83%。
- 進步最多的模型:不使用工具時得分低於 31% 的十款模型,平均每項任務呼叫工具約 42 次;得分高於該門檻的七款模型,平均約 23 次。MiMo-V2.6-Pro 使用工具後從 5% 升至 43%,每項任務約呼叫 49 次;Gemini 3.8 Flash (high) 從 16% 升至 41%,每項任務約呼叫 68 次。Astra 和 Sol 每項任務約呼叫 8 次,分別提高 13 和 16 個百分點。
- 成本:所有模型使用工具後,每項任務的成本都會增加,從 Astra 的 $0.21 升至 $0.27,到 Fable 的 5.8 倍不等;倍數最高的是 Qwen3.8 Max (0902, xhigh),達 28 倍,其次為 Gemini 3.8 Flash 的 20 倍,以及 MiMo-V2.6-Pro 的 15 倍。
以上為 Artificial Analysis 自行測得的數據。
來源
這樣的新聞,第一時間推播給你。
你使用的 AI 工具一有變化,AI Tracker 就會通知你。