 AI Tracker
Artificial Analysis: sin herramientas, Claude Fable 5.2 baja del 67 % al 44 % en VIALS-AA, por debajo de Haiku 5.5 con herramientas
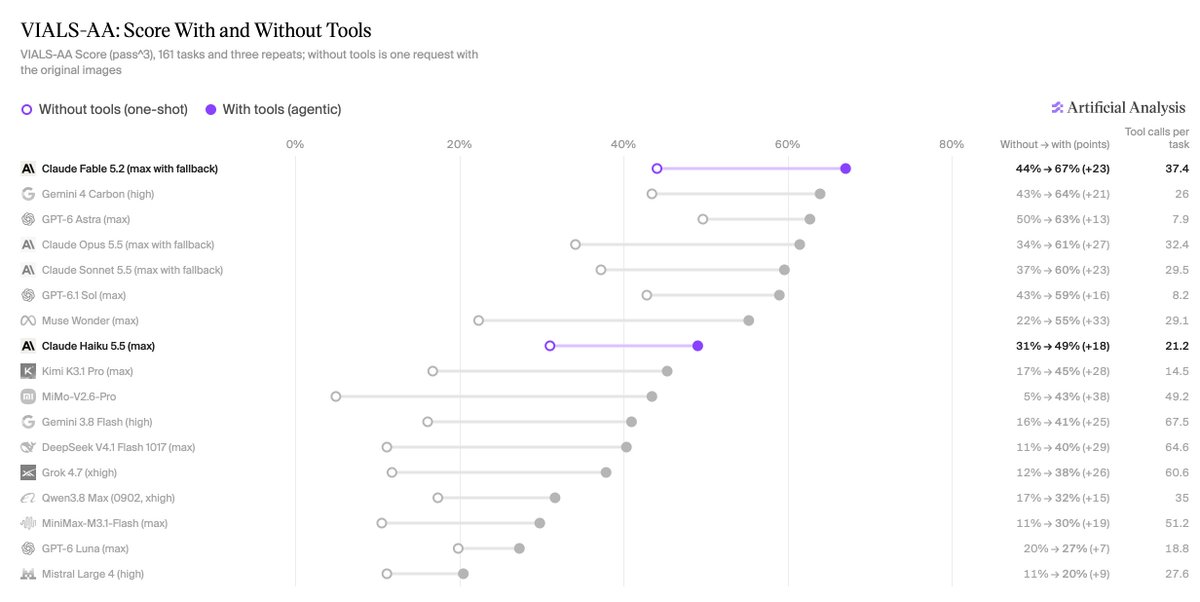
Artificial Analysis volvió a ejecutar VIALS-AA, su benchmark de razonamiento visual en ciencias de la vida, en un formato de una sola interacción: una única solicitud con la pregunta y las imágenes, sin herramientas. De forma predeterminada, el benchmark hace que los modelos trabajen como agentes que razonan, ejecutan código y ven imágenes en un entorno aislado. Según la empresa, en todos los modelos el uso de herramientas casi duplica las puntuaciones, que pasan de alrededor del 25 % al 47 % de promedio.
- Fable 5.2 (max): 67 % con herramientas, a $4.20 por tarea; 44 % sin herramientas, a $0.73 por tarea, por debajo de Claude Haiku 5.5 (max) con herramientas.
- Haiku 5.5 (max): 49 % con herramientas, a $0.07 por tarea. Artificial Analysis señala que, a menudo, la forma más barata de alcanzar una puntuación determinada es usar un modelo más pequeño con herramientas: Claude Opus 5.5 sin herramientas obtiene un 34 % a $0.33.
- Tareas de conteo: en las 23 tareas de conteo y cuantificación de células, la tasa de aprobación^3 de Fable cae del 65 % con herramientas al 9 % sin ellas; la de Opus 5.5, del 57 % al 4 %; y la de Claude Sonnet 5.5, del 65 % al 13 %. GPT-6 Astra baja del 61 % al 35 % y GPT-6.1 Sol, del 61 % al 39 %. En las 23 tareas de filogenética, Astra aprueba el 78 % con herramientas y el 83 % sin ellas.
- Quiénes mejoran más: los diez modelos con puntuaciones inferiores al 31 % sin herramientas promedian unas 42 llamadas a herramientas por tarea; los siete que superan esa cifra, unas 23. MiMo-V2.6-Pro pasa del 5 % al 43 %, con unas 49 llamadas por tarea; Gemini 3.8 Flash (high), del 16 % al 41 %, con unas 68. Astra y Sol hacen unas 8 llamadas por tarea y mejoran 13 y 16 puntos, respectivamente.
- Costo: las herramientas aumentan el costo por tarea de todos los modelos, desde los $0.21 de Astra hasta los $0.27, y hasta un aumento de 5.8× en el caso de Fable; los multiplicadores más altos corresponden a Qwen3.8 Max (0902, xhigh), con 28×; Gemini 3.8 Flash, con 20×; y MiMo-V2.6-Pro, con 15×.
Estas son mediciones propias de Artificial Analysis.
Fuentes
Recibe noticias como esta por push.
AI Tracker te avisa cuando algo cambia en las herramientas que usas.