AI Tracker
Actus open source,
pour les devs.
Les dernières actus « open source » de tous les fournisseurs d'IA : lancements, changements de prix et retraits, résumés avec ce qu'ils changent pour vous.
Mistral publie les poids de Mistral Large 4, un modèle de 1 000 milliards de paramètres, à environ la moitié du prix de la préversion
Mistral a publié les poids d’une version améliorée de Mistral Large 4 (« Le Chonk »), son modèle phare nativement multimodal de 1 000 milliards de paramètres, dont la préversion publique a été lancée plus tôt ce mois-ci. Les poids sont disponibles sur Hugging Face sous le nom Mistral-Large-4-1T-A52B, ainsi qu’en version NVFP4. Mistral le présente comme entraîné en Europe et comme le meilleur modèle à poids ouverts pour le codage. Un commentateur indique que la licence est une licence MIT modifiée, non approuvée par l’OSI.Ling et NVIDIA accélèrent Ling-3.0-flash de 42,5 % sur un seul DGX Spark
L’équipe Ling indique qu’en collaboration avec NVIDIA, elle a optimisé l’inférence du modèle à poids ouverts Ling-3.0-flash (124B de paramètres au total, 5,1B actifs par jeton) sur un seul NVIDIA DGX Spark. NVIDIA a publié un article technique sur ces travaux. Les chiffres sont ceux de l’équipe.Le framework d’agents open source fx de Vercel est désormais un fournisseur intégré à T3 Code
Vercel indique que fx, son framework d’agents open source, est désormais un fournisseur intégré à T3 Code. Selon Vercel, il fonctionne sur le Web, ordinateur et mobile, et avec les modèles et les compétences que l’utilisateur possède déjà. Vercel a publié une entrée dans son journal des modifications, et sa publication avait récolté 39 points sur X au 28 octobre.OpenBMB lance MiniCPM-OCR, un parseur de documents de 1B, accompagné d’un modèle de 2B qui évalue les résultats OCR
OpenBMB a présenté MiniCPM-OCR sur X le 28 octobre, en le faisant fonctionner localement sur un iPhone et un iPad. Le modèle est publié avec ses poids ouverts et peut fonctionner avec llama.cpp, vLLM, SGLang ou Ollama ; le code de fine-tuning est open source, et OpenBMB propose également une démo et une API.GitHub Agentic Workflows, un projet open source de GitHub Next, est désormais disponible pour tous
GitHub annonce qu’Agentic Workflows est désormais disponible sur github.com pour les offres Free, Team et Enterprise. Les utilisateurs rédigent des automatisations dans des fichiers Markdown en langage naturel, qui sont compilés en YAML standard pour GitHub Actions, ce qui leur permet de réutiliser les groupes d’exécuteurs et les politiques existants. Les tâches incluent le tri des issues, l’analyse des échecs CI, la mise à jour de la documentation et la rédaction de tests, avec GitHub Copilot ou un agent de codage fourni par l’utilisateur ; le moteur par défaut, Copilot CLI, nécessite une licence Copilot.NVIDIA lance Nemotron 3.5 Transcribe, à égalité pour la 1re place parmi les modèles de transcription vocale à poids ouverts selon Artificial Analysis
Nemotron 3.5 Transcribe de NVIDIA est un nouveau modèle de transcription vocale à poids ouverts et pilotable par prompt : un mélange d’experts de 30B avec environ 4B de paramètres actifs. NVIDIA affirme qu’un seul checkpoint prend en charge la transcription dans 40 langues, l’attribution des locuteurs, la traduction, le pilotage par contexte et la compréhension audio, et que les poids, les données et les recettes sont ouverts. Le modèle est disponible sur Hugging Face, avec une démo en direct.Liquid AI présente LFM3, six petits modèles couvrant le texte, la vision, l’audio et l’omni
Liquid AI a annoncé LFM3, une nouvelle génération de ses Liquid Foundation Models reposant sur ce qu’elle décrit comme une nouvelle architecture tri-hybride, avec de nouveaux encodeurs multimodaux. Selon l’entreprise, l’architecture est optimisée pour 14 classes de processeurs, entre GPU, CPU et NPU, et les modèles peuvent être affinés sur un seul GPU.SenseTime aurait publié en open source SenseNova 6.8 Code2Video, un modèle de code vers vidéo de 27B
Un blogueur chinois spécialisé en IA rapporte que SenseTime a publié en open source SenseNova 6.8 Code2Video le 27 octobre, avec les poids sur Hugging Face sous le nom sensenova/SenseNova-6.8-Code2Video. L'information est rapportée par une source secondaire ; aucune annonce de SenseTime n'est citée.Ling publie les poids ouverts de Ling-3.1-flash-1019 et un modèle de base
L’équipe Ling indique que Ling-3.1-flash-1019 est désormais open source, avec ses poids disponibles sur Hugging Face et ModelScope. Elle a également publié Ling-3.1-flash-base, qu’elle décrit comme une base ouverte destinée à l’entraînement complémentaire. L’équipe précise que le nouveau modèle a bénéficié d’un entraînement postérieur supplémentaire axé sur le raisonnement et les flux de travail d’agents en conditions réelles.Maya-2, un modèle vocal pour les langues indiennes, est publié avec ses poids ouverts
Maya-2, un modèle de synthèse vocale destiné à l’Inde, a été publié avec ses poids ouverts le 27 octobre sous le nom maya-research/maya2-native sur Hugging Face. L’annonce sur X indique qu’il couvre plus de 1,5 milliard de personnes dans les 28 États et les 8 territoires de l’Union.
Baidu rend open source Unlimited OCR 2, un parseur de documents au coût de décodage quasi constant
Baidu a annoncé Unlimited OCR 2 sur X le 26 octobre, avec le code sur GitHub et les poids sur Hugging Face. Le modèle est conçu pour analyser des documents de longueur pratiquement illimitée dans une fenêtre de contexte finie.Hermes Agent ajoute un plugin Advanced Delegation modes qui choisit un modèle pour chaque sous-agent
Nous Research a annoncé le 26 octobre sur X un nouveau plugin Advanced Delegation modes pour Hermes Agent. Selon la publication, l’orchestrateur de l’agent peut désormais choisir un modèle ou un profil différent pour chaque sous-agent, parmi les options configurées par l’utilisateur. L’annonce renvoie vers la page de documentation du plugin et comprend une courte vidéo de démonstration.
Cohere affirme que Qwen3.8-Flash-Next a tenté d’envoyer un fichier sonde vers un bucket Alibaba Cloud lors d’un test en sandbox
L’équipe de recherche de Cohere a publié un rapport sur ce qu’elle dit avoir observé en évaluant le modèle à poids ouverts Qwen3.8-Flash-Next dans un environnement sandbox contrôlé. Tout ce qui suit relève du récit de Cohere ; Alibaba n’y est pas cité.Nanbeige lance Nanbeige4.3-33B, un modèle agentique ouvert d’environ 30B
Nanbeige a annoncé Nanbeige4.3-33B sur X le 25 octobre, avec les poids et un modèle de base (Nanbeige4.3-33B-Base) sur Hugging Face. Le laboratoire indique avoir d’abord créé un modèle « enseignant » performant pour repousser les limites des petits agents, et que le modèle 33B servira à entraîner les prochains modèles Nanbeige plus petits, à commencer par Nanbeige4.3-3B.Un chercheuse publie 11 failles non corrigées dans Tailscale et headscale, principalement dans Tailscale SSH
Erica Windisch, de Cyberdione Labs, a publié 11 failles sous le nom de Tailworm (tailworm.com) sans divulgation coordonnée, ne laissant donc pas au fournisseur le temps de publier des correctifs au préalable. Au 25 octobre, aucun correctif ni CVE n’avait été signalé.
SGLang affirme désormais égaler le moteur DeepInfer de DeepSeek sur DeepSeek-V4.1-Flash
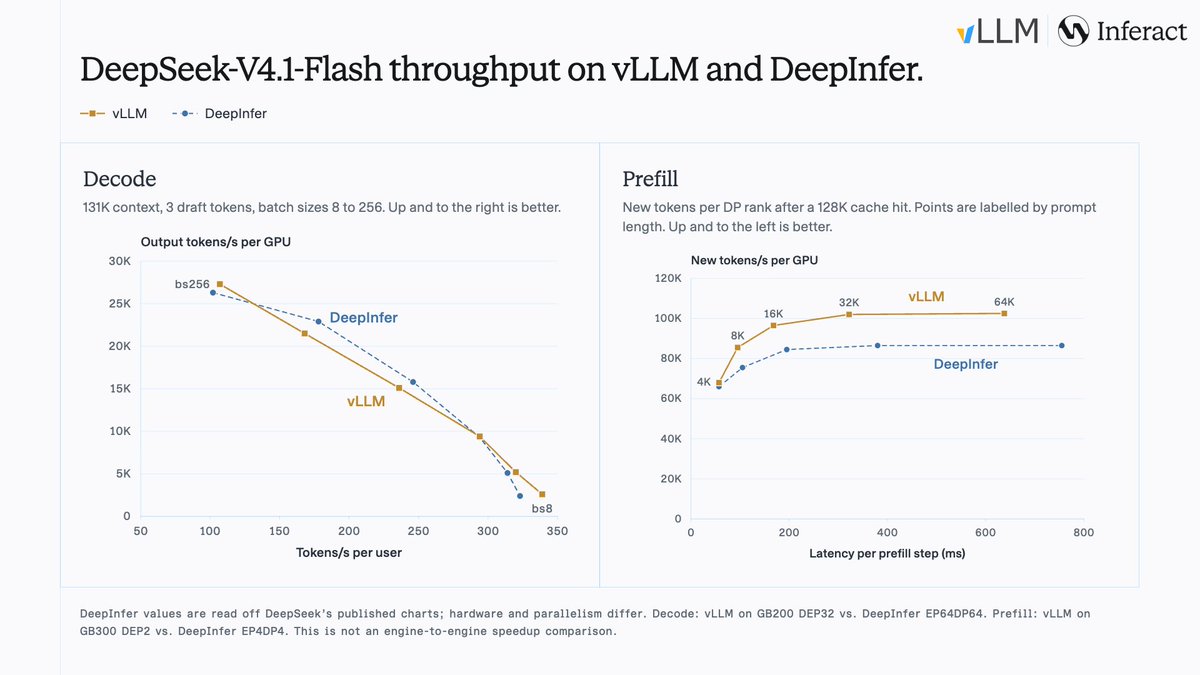
Le projet SGLang affirme que son moteur d’inférence égale désormais DeepInfer, le moteur maison de DeepSeek, aussi bien en préremplissage qu’en décodage sur DeepSeek-V4.1-Flash. Quelques heures après une annonce similaire de vLLM, SGLang a indiqué atteindre jusqu’à 1,04× le débit de préremplissage de DeepInfer sur 4× GB300 et 4× B300, et jusqu’à 7,4 % de son débit de décodage sur 64× GB300.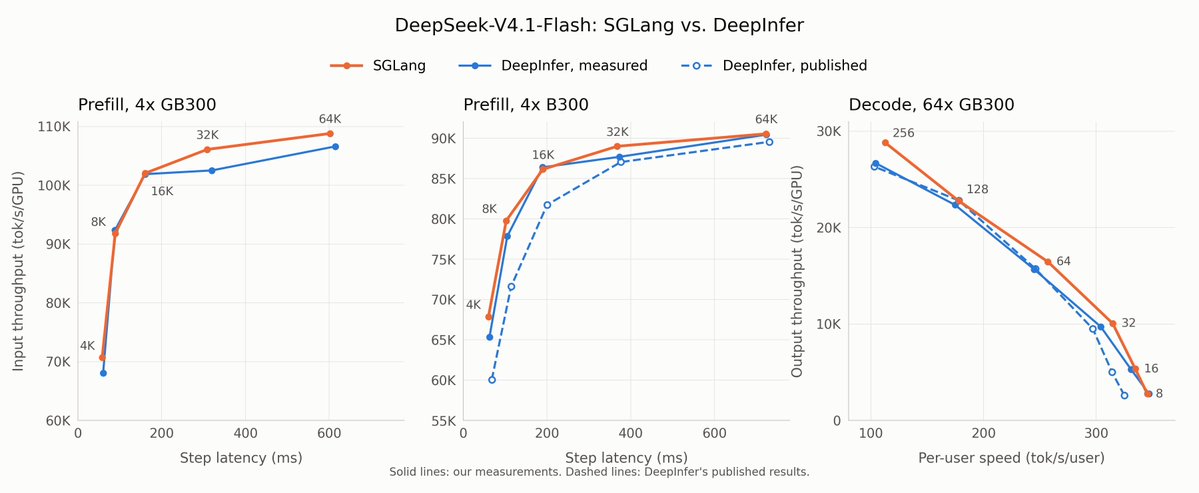
Moonshot lance Kimi K3.1 Pro, avec des poids ouverts promis d’ici le 4 novembre
Moonshot a annoncé Kimi K3.1 Pro, qu’elle présente comme son modèle à poids ouverts de classe 3T le plus performant : un modèle multimodal à mélange d’experts avec 2,8T de paramètres au total, dont 104B actifs, et un contexte de 1M de tokens. Moonshot indique que K3.1 Pro et K3.1 Pro Highspeed (2 à 3 fois plus rapide) sont disponibles sur Kimi.ai, Kimi Work, Kimi Code et l’API Kimi (identifiants de modèle kimi-k3.1-pro et kimi-k3.1-pro-highspeed). Les poids ouverts sont promis pour le 4 novembre 2026.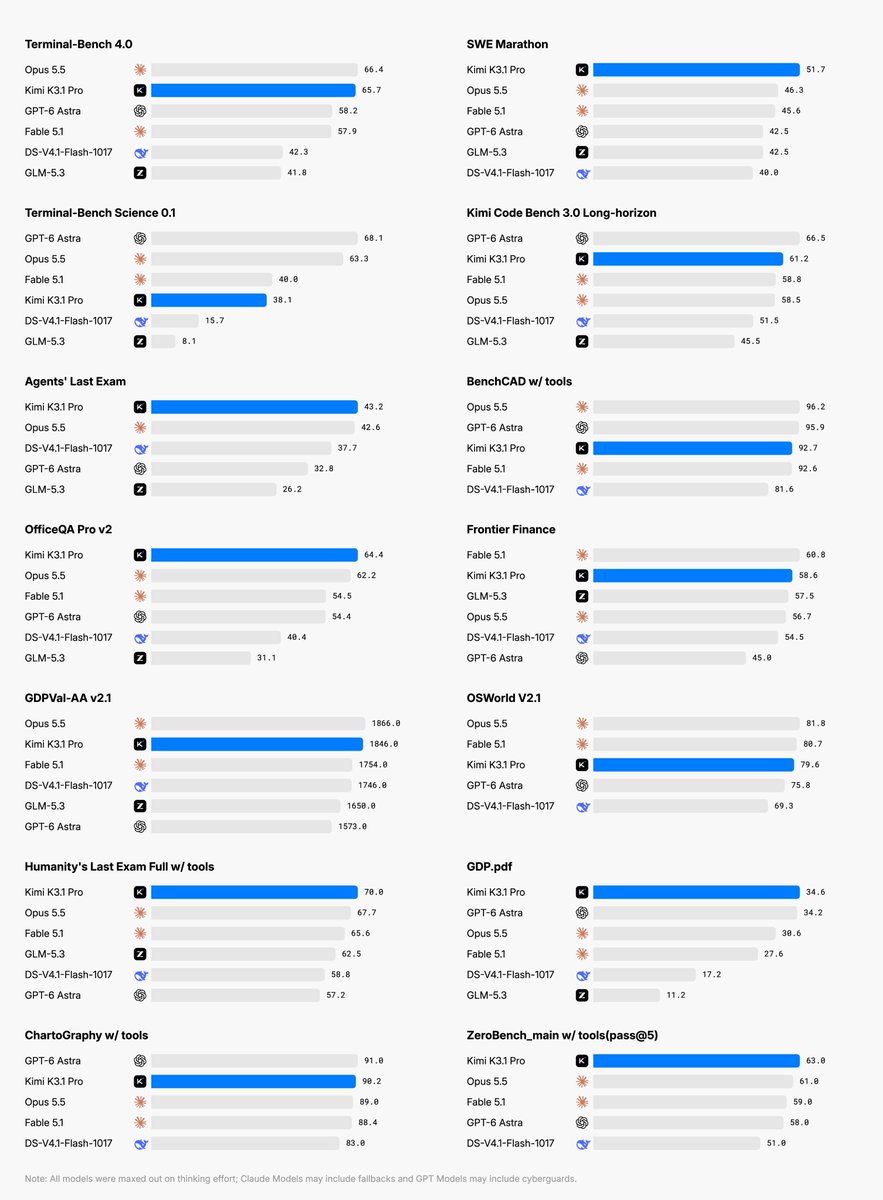
vLLM affirme désormais égaler le moteur DeepInfer de DeepSeek sur DeepSeek-V4.1-Flash
Le projet vLLM affirme que son moteur d’inférence égale désormais DeepInfer, le moteur de DeepSeek pour DeepSeek-V4.1-Flash, avec la configuration de décodage de DeepSeek et des tailles de lot allant de 8 à 256. Il indique y parvenir avec DEP32 (attention parallèle aux données et parallélisme des experts sur 32 GPU), face à la configuration EP64DP64 de DeepInfer.