 AI Tracker
Google ergänzt die TPU 8tx für vertrauliche Inferenz und die TPU 8i Max für lange Kontexte
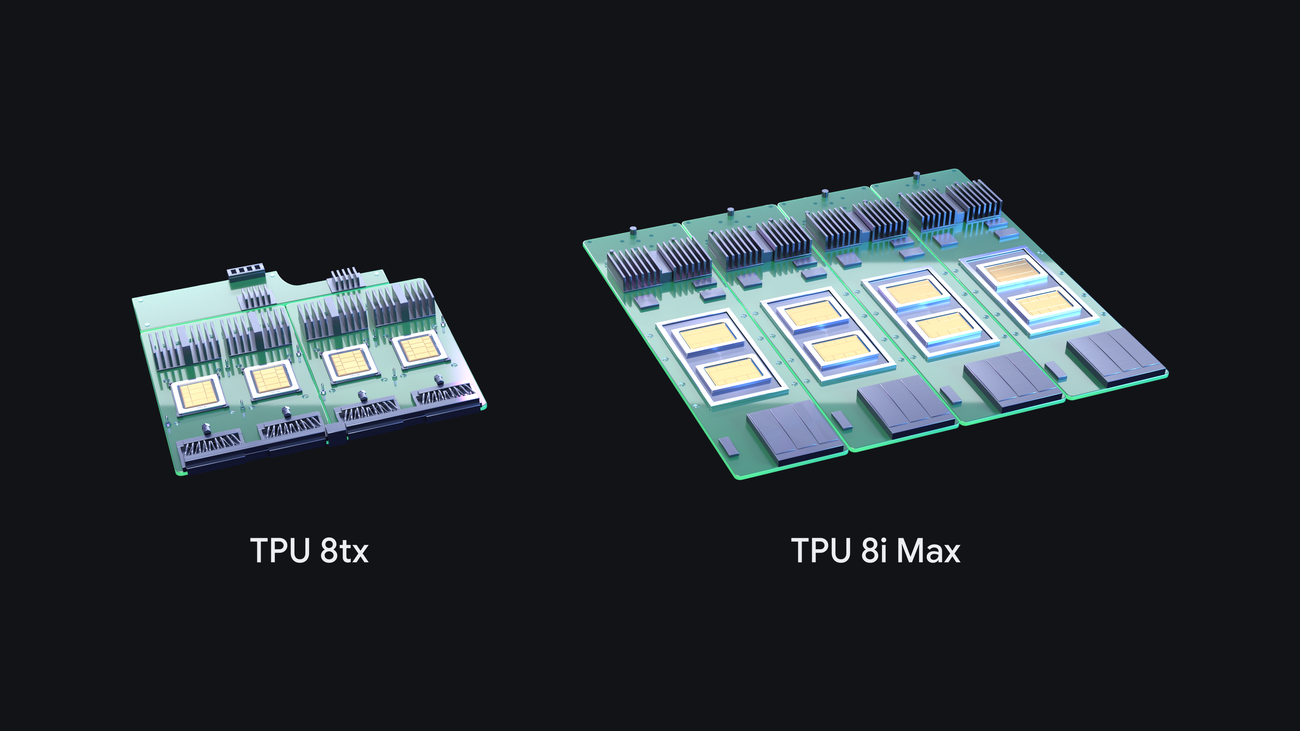
Google hat zwei weitere Systeme seiner TPU-Reihe der achten Generation angekündigt. Damit gibt es laut dem Unternehmen innerhalb eines Jahres vier neue TPU-Systeme. Sie ergänzen die TPU 8t (Training) und die TPU 8i (Reasoning mit geringer Latenz), die im April auf der Google Cloud Next vorgestellt wurden. Google nannte im Beitrag keine Termine für die Verfügbarkeit.
TPU 8tx ist für sichere, vertrauliche Inferenz und Training im kleinen Maßstab für regulierte Unternehmen und Behörden ausgelegt. Google zufolge bleiben Daten und Modellgewichte selbst während der Nutzung durch Hardware geschützt. Das System basiert auf dem Silizium der TPU 8t und Hosts mit AMD EPYC der 5. Generation. Bei nahezu ohne Leistungseinbußen soll es die Latenz gegenüber der TPU 8t um bis zu das Zweifache senken.
TPU 8i Max vereint zwei TPU-8i-Chips in einem Package. Laut Google bietet sie die doppelte Rechenleistung sowie die doppelte SRAM- und HBM-Bandbreite der TPU 8i, ist für sehr große Kontextfenster ausgelegt und bringt doppelt so viel Silizium im vorhandenen Rack-Format unter.
Software für Entwickler. Google zufolge wurde TorchTPU im vergangenen Monat als Open Source veröffentlicht. Damit laufen PyTorch-Code und Hugging-Face-Modelle nativ auf TPUs; für vLLM und SGLang gibt es TPU-Backends. Außerdem kündigte Google Folgendes an:
- eine Open-Source-TPU-Agentensuite in der Vorschau, die sich in Claude Code, Cursor und Google Antigravity integriert, um den Einstieg in TPUs zu erleichtern, Engpässe zu diagnostizieren und Kernel zu optimieren;
- eine Open-Source-XLA-Serving-Engine, mit der sich in Python trainieren und in einer C++-Laufzeit über TPUs, GPUs und CPUs hinweg bereitstellen lässt;
- TPU Sync, eine Open-Source-Schicht für Modellzustände, die KV-Caches auf Speicher außerhalb des Chips auslagert. Laut Google senkt sie die Latenz bei der KV-Übertragung und die Zeit bis zum ersten Token um mehr als 90 %;
- Agent Compute Engine, die inaktive Agentensitzungen pausiert und fortsetzt, um Infrastrukturkosten zu senken;
- Cloud Pathways und GKE Dynamic Slicing, beide jetzt allgemein über Google Kubernetes Engine verfügbar. Laut Google verkürzt Dynamic Slicing die Startzeiten von Jobs um bis zu das Fünffache und beschleunigt die Fehlerbehebung um bis zu das 4,5-Fache.
Google gibt außerdem an, dass sein vLLM-TorchTPU-Stack bei den Benchmarks InferenceX und AgentX eine branchenführende Preis-Leistung erzielt hat. Dabei handelt es sich um eigene Angaben von Google.
Quellen
- Unsere neuesten TPUs: 8tx und 8i Max – für das agentische Zeitalter entwickeltHacker News · 4 Kommentare
News wie diese als Push.
AI Tracker benachrichtigt dich, wenn sich bei deinen Tools etwas ändert.