 AI Tracker
Google dodaje TPU 8tx do poufnego wnioskowania oraz TPU 8i Max do obsługi długich kontekstów
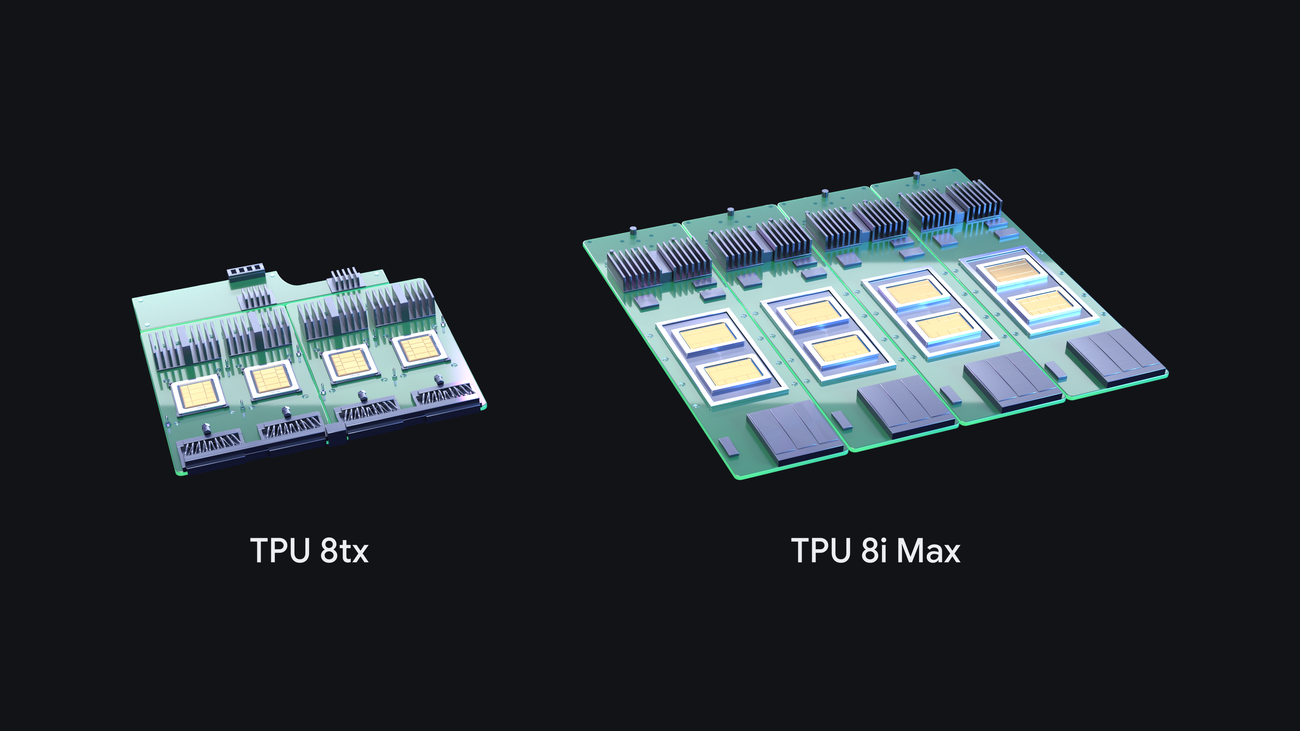
Google ogłosiło dwa kolejne systemy z linii TPU ósmej generacji, co — jak twierdzi — oznacza cztery nowe systemy TPU w ciągu jednego roku. Dołączają do TPU 8t (do trenowania) i TPU 8i (do rozumowania o niskich opóźnieniach), zaprezentowanych w kwietniu podczas Google Cloud Next. W poście Google nie podało dat dostępności.
TPU 8tx jest przeznaczony do bezpiecznego, poufnego wnioskowania oraz trenowania modeli na małą skalę w regulowanych przedsiębiorstwach i instytucjach rządowych. Google twierdzi, że chroni dane i wagi modeli na poziomie sprzętowym nawet podczas ich używania, bazuje na krzemie TPU 8t i hostach AMD EPYC 5. generacji, a przy niemal zerowym spadku wydajności zapewnia do 2 razy niższe opóźnienia niż TPU 8t.
TPU 8i Max umieszcza dwa układy TPU 8i w jednym pakiecie. Według Google oferuje dwukrotnie większą moc obliczeniową, SRAM i przepustowość HBM niż TPU 8i, jest przeznaczony do obsługi bardzo dużych okien kontekstowych i mieści dwa razy więcej krzemu w istniejącej przestrzeni szafy.
Oprogramowanie dla deweloperów. Google twierdzi, że w zeszłym miesiącu udostępniło TorchTPU jako open source, dzięki czemu kod PyTorch i modele Hugging Face działają natywnie na TPU, a vLLM i SGLang mają backendy TPU. Firma ogłosiła również:
- otwarty zestaw agentów TPU, dostępny w wersji zapoznawczej, który integruje się z Claude Code, Cursor i Google Antigravity, aby ułatwić rozpoczęcie pracy z TPU, diagnozować wąskie gardła i optymalizować kernele;
- otwarty XLA Serving Engine, umożliwiający trenowanie w Pythonie i serwowanie w środowisku uruchomieniowym C++ na TPU, GPU i CPU;
- TPU Sync — otwartą warstwę zarządzania stanem modeli, która przenosi pamięci podręczne KV poza układ; Google twierdzi, że skraca ona opóźnienie transferu KV i czas do pierwszego tokena o ponad 90%;
- Agent Compute Engine, który wstrzymuje i wznawia bezczynne sesje agentów, by obniżyć koszty infrastruktury;
- Cloud Pathways i GKE dynamic slicing, które są już ogólnie dostępne w Google Kubernetes Engine; Google twierdzi, że dynamic slicing skraca czas uruchamiania zadań nawet 5-krotnie i przyspiesza odzyskiwanie po awarii nawet 4,5-krotnie.
Google twierdzi również, że jego stos vLLM-TorchTPU osiągnął najlepszy w branży stosunek ceny do wydajności w testach InferenceX i AgentX; są to deklaracje samego Google.
Źródła
- Nasze najnowsze TPU: 8tx i 8i Max, stworzone z myślą o erze agentówHacker News · 4 komentarze
Otrzymuj takie wiadomości jako push.
AI Tracker powiadomi Cię, gdy coś zmieni się w narzędziach, których używasz.