 AI Tracker
Google menambahkan TPU 8tx untuk inferensi rahasia dan TPU 8i Max untuk konteks panjang
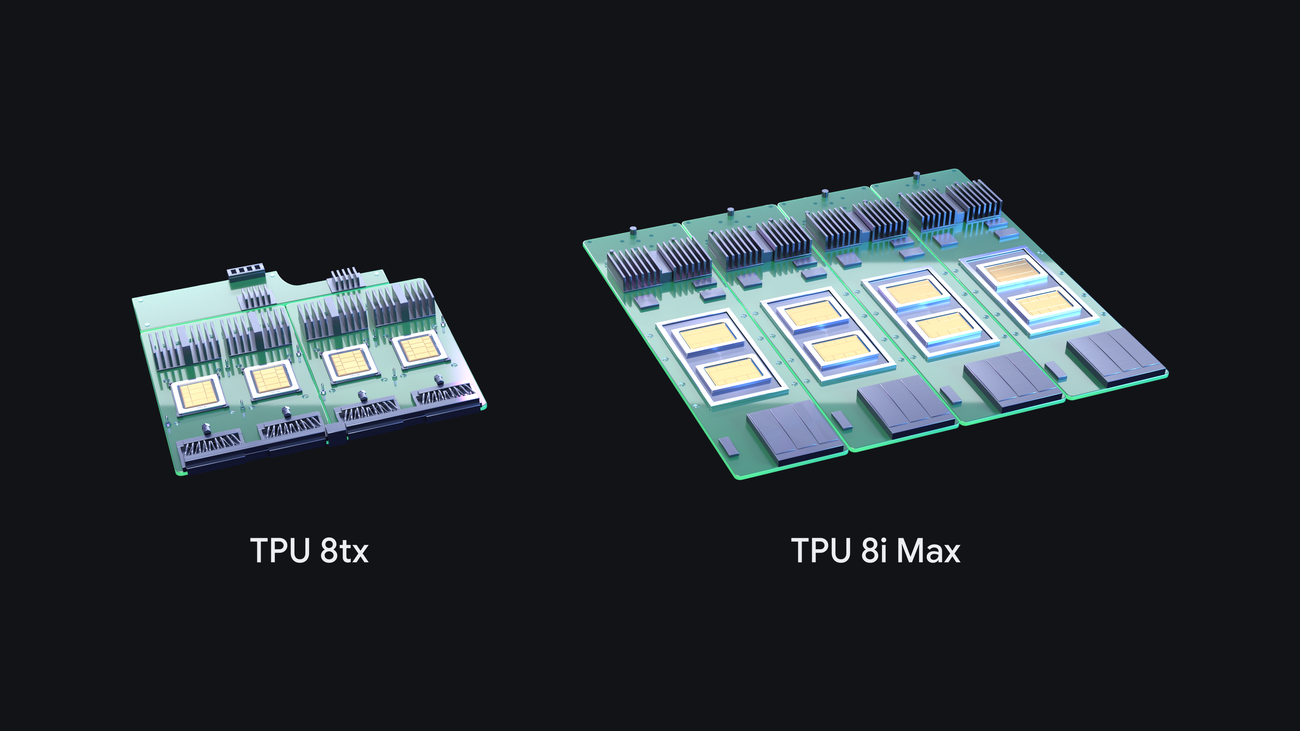
Google mengumumkan dua sistem lagi dalam lini TPU generasi kedelapannya, yang menurut perusahaan menjadikan total empat sistem TPU baru dalam satu tahun. Keduanya melengkapi TPU 8t (pelatihan) dan TPU 8i (penalaran berlatensi rendah), yang diperkenalkan di Google Cloud Next pada April. Google tidak menyebutkan tanggal ketersediaan dalam unggahan tersebut.
TPU 8tx ditujukan untuk inferensi rahasia yang aman dan pelatihan skala kecil bagi perusahaan dan pemerintah yang diatur oleh ketentuan khusus. Google mengatakan sistem ini melindungi data dan bobot model di perangkat keras bahkan saat sedang digunakan, dibangun dengan silikon TPU 8t dan host AMD EPYC generasi ke-5, serta memberikan latensi hingga 2x lebih rendah daripada TPU 8t dengan penalti kinerja nyaris nol.
TPU 8i Max menempatkan dua chip TPU 8i dalam satu paket. Google mengatakan perangkat ini memiliki daya komputasi, SRAM, dan bandwidth HBM dua kali lipat dibandingkan TPU 8i, ditujukan untuk jendela konteks yang sangat besar, serta memuat silikon dua kali lebih banyak dalam ukuran rak yang sudah ada.
Perangkat lunak untuk pengembang. Google mengatakan telah membuka sumber TorchTPU bulan lalu, sehingga kode PyTorch dan model Hugging Face dapat berjalan secara native di TPU, dengan backend TPU untuk vLLM dan SGLang. Google juga mengumumkan:
- rangkaian agen TPU sumber terbuka, dalam pratinjau, yang terintegrasi dengan Claude Code, Cursor, dan Google Antigravity untuk membantu penggunaan TPU, mendiagnosis hambatan kinerja, dan mengoptimalkan kernel;
- XLA Serving Engine sumber terbuka, untuk melatih dengan Python dan melayani model dalam runtime C++ di TPU, GPU, dan CPU;
- TPU Sync, lapisan status model sumber terbuka yang memindahkan cache KV dari chip ke tingkatan penyimpanan lain, yang menurut Google memangkas latensi transfer KV dan waktu hingga token pertama lebih dari 90%;
- Agent Compute Engine, yang menangguhkan dan melanjutkan sesi agen yang tidak aktif untuk memangkas biaya infrastruktur;
- Cloud Pathways dan GKE dynamic slicing, keduanya kini tersedia secara umum di Google Kubernetes Engine; Google mengatakan dynamic slicing memangkas waktu mulai tugas hingga 5x dan mempercepat pemulihan dari kegagalan hingga 4,5x.
Google juga mengatakan stack vLLM-TorchTPU mereka mencapai rasio harga-kinerja tercanggih pada tolok ukur InferenceX dan AgentX; ini adalah klaim Google sendiri.
Sumber
- TPU terbaru kami: 8tx dan 8i Max, dirancang untuk era agentikHacker News · 4 komentar
Dapatkan berita seperti ini lewat push.
AI Tracker memberi tahu Anda saat ada perubahan pada alat yang Anda pakai.