 AI Tracker
Google añade TPU 8tx para inferencia confidencial y TPU 8i Max para contextos largos
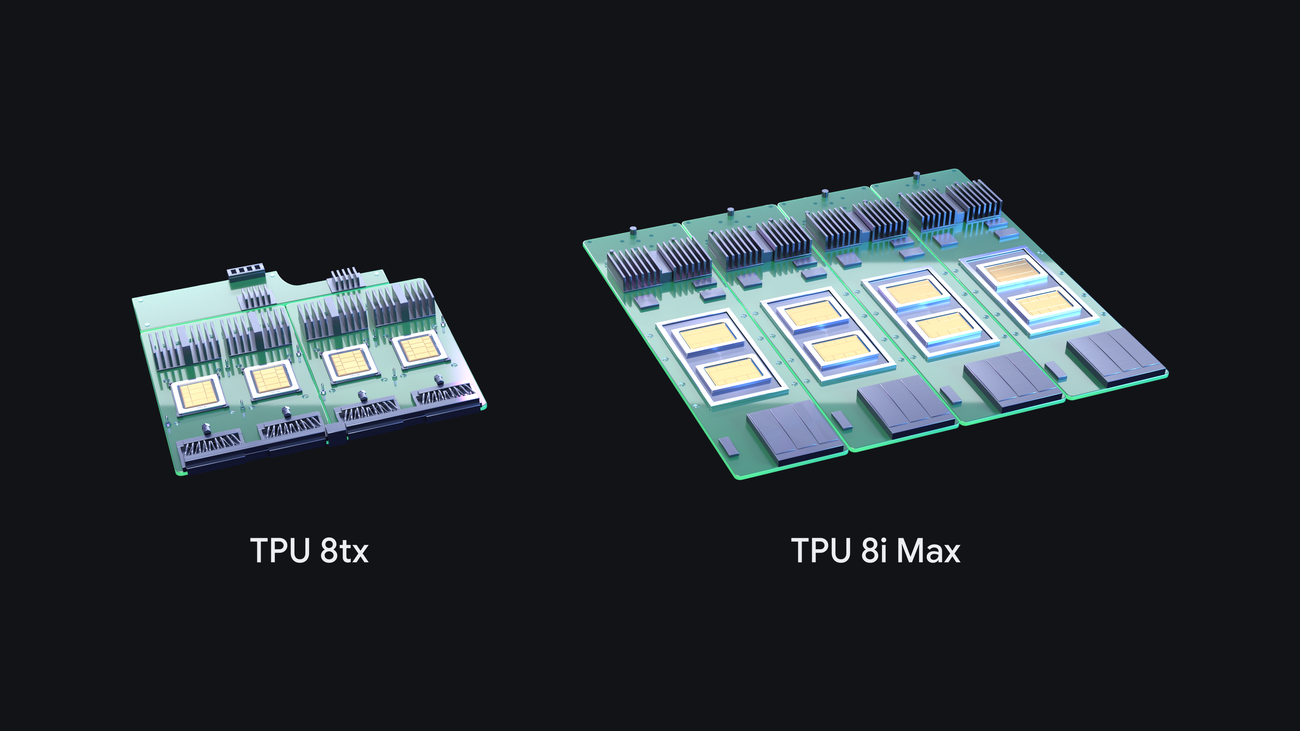
Google anunció dos sistemas más de su línea de TPU de octava generación, que, según afirma, suma cuatro nuevos sistemas TPU en un solo año. Se unen a TPU 8t (entrenamiento) y TPU 8i (razonamiento de baja latencia), presentados en Google Cloud Next en abril. Google no indicó fechas de disponibilidad en la publicación.
TPU 8tx está pensado para la inferencia segura y confidencial, así como para el entrenamiento a pequeña escala, en empresas reguladas y organismos gubernamentales. Google afirma que mantiene protegidos los datos y los pesos del modelo en el hardware incluso durante su uso, que está construido sobre silicio TPU 8t con hosts AMD EPYC de 5.ª generación y que ofrece hasta el doble de latencia reducida que TPU 8t, con una penalización de rendimiento casi nula.
TPU 8i Max integra dos chips TPU 8i en un solo paquete. Google afirma que ofrece el doble de capacidad de cómputo, SRAM y ancho de banda HBM que TPU 8i, está pensado para ventanas de contexto muy grandes y aloja el doble de silicio en el espacio actual del rack.
Software para desarrolladores. Google afirma que el mes pasado publicó TorchTPU como código abierto, de modo que el código de PyTorch y los modelos de Hugging Face se ejecutan de forma nativa en las TPU, con backends de TPU para vLLM y SGLang. También anunció:
- una suite de agentes de TPU de código abierto, en vista previa, que se integra con Claude Code, Cursor y Google Antigravity para facilitar la incorporación a las TPU, diagnosticar cuellos de botella y optimizar kernels;
- XLA Serving Engine, de código abierto, para entrenar en Python y servir en un entorno de ejecución C++ en TPU, GPU y CPU;
- TPU Sync, una capa de estado de modelos de código abierto que traslada las cachés KV fuera del chip por niveles; Google afirma que reduce en más del 90% la latencia de transferencia de KV y el tiempo hasta el primer token;
- Agent Compute Engine, que suspende y reanuda las sesiones de agentes inactivas para reducir los costos de infraestructura;
- Cloud Pathways y GKE dynamic slicing, ambos ya disponibles de forma general en Google Kubernetes Engine; Google afirma que dynamic slicing reduce hasta 5 veces los tiempos de inicio de los trabajos y acelera hasta 4,5 veces la recuperación ante fallos.
Google también afirma que su stack vLLM-TorchTPU alcanzó un rendimiento de precio de vanguardia en los benchmarks InferenceX y AgentX; estas son afirmaciones de la propia Google.
Fuentes
- Nuestras TPU más recientes: 8tx y 8i Max, diseñadas para la era agénticaHacker News · 4 comentarios
Recibe noticias como esta por push.
AI Tracker te avisa cuando algo cambia en las herramientas que usas.