 AI Tracker
Google представляет TPU 8tx для конфиденциального инференса и TPU 8i Max для работы с длинным контекстом
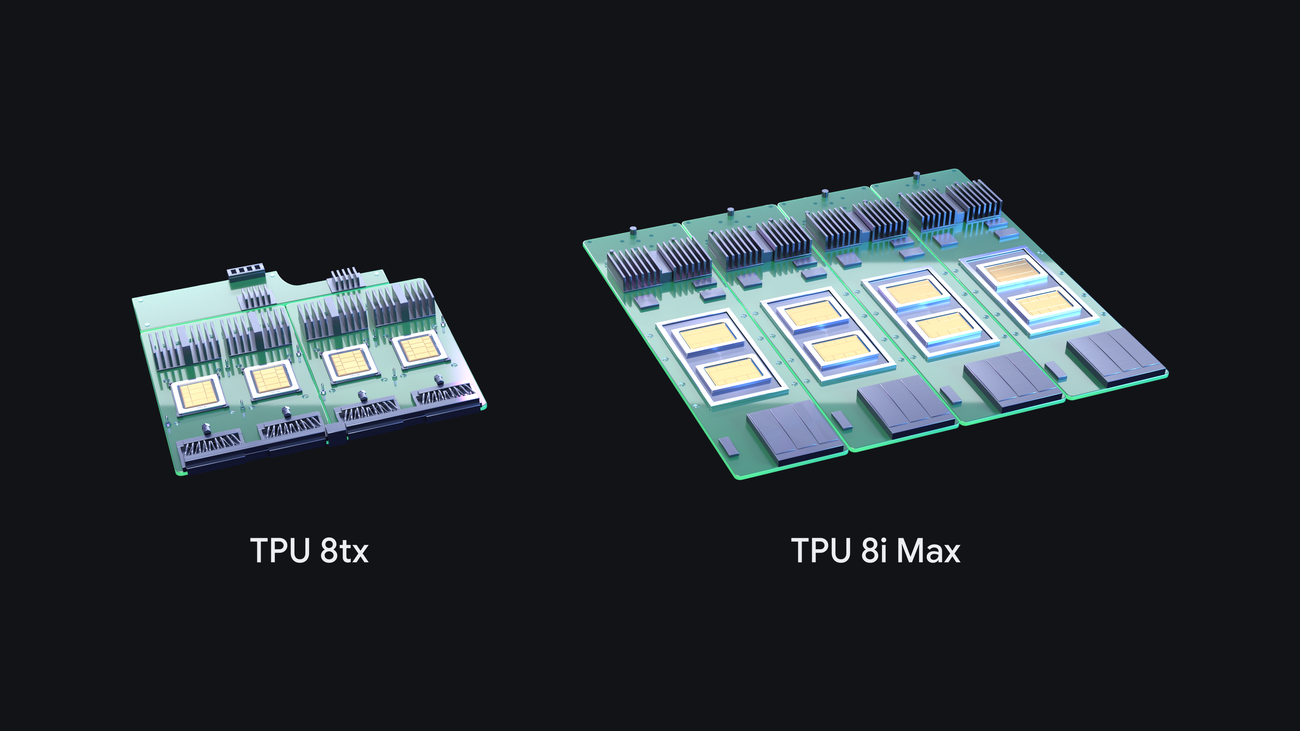
Google объявила о выпуске ещё двух систем восьмого поколения TPU — по словам компании, всего за год появились четыре новые системы TPU. Они дополняют TPU 8t (для обучения) и TPU 8i (для рассуждений с низкой задержкой), представленные на Google Cloud Next в апреле. В публикации Google не указала даты доступности.
TPU 8tx предназначена для безопасного конфиденциального инференса и обучения небольших моделей для регулируемых отраслей и государственных организаций. Google утверждает, что данные и веса моделей защищены на аппаратном уровне даже во время использования; система построена на кремнии TPU 8t и оснащена хостами 5-го поколения AMD EPYC, а задержка в ней до 2 раз ниже, чем у TPU 8t, практически без потери производительности.
TPU 8i Max объединяет два чипа TPU 8i в одном корпусе. По словам Google, её вычислительная мощность, объём SRAM и пропускная способность HBM вдвое выше, чем у TPU 8i. Система рассчитана на очень большие окна контекста и вмещает вдвое больше кремниевых кристаллов в существующую стойку.
ПО для разработчиков. Google сообщает, что в прошлом месяце открыла исходный код TorchTPU: теперь код PyTorch и модели Hugging Face работают на TPU напрямую, а для vLLM и SGLang доступны бэкенды TPU. Компания также представила:
- набор агентов TPU с открытым исходным кодом, доступный в предварительной версии: он интегрируется с Claude Code, Cursor и Google Antigravity, помогая начать работу с TPU, находить узкие места и оптимизировать ядра;
- XLA Serving Engine с открытым исходным кодом, позволяющий обучать модели на Python и обслуживать их в среде выполнения C++ на TPU, GPU и CPU;
- TPU Sync — слой управления состоянием моделей с открытым исходным кодом, который переносит KV-кэши на другие уровни хранения. Google утверждает, что это сокращает задержку передачи KV и время до первого токена более чем на 90%;
- Agent Compute Engine, приостанавливающий и возобновляющий простаивающие сессии агентов для снижения затрат на инфраструктуру;
- Cloud Pathways и динамическое разбиение на срезы в GKE — оба решения теперь общедоступны в Google Kubernetes Engine. По словам Google, динамическое разбиение сокращает время запуска задач до 5 раз и ускоряет восстановление после сбоев до 4,5 раза.
Google также утверждает, что её стек vLLM-TorchTPU показал лучшие на данный момент результаты по соотношению цены и производительности в тестах InferenceX и AgentX; это заявления самой Google.
Источники
- Наши новейшие TPU: 8tx и 8i Max — для эпохи агентных системHacker News · 4 комментария
Получайте такие новости в push.
AI Tracker сообщит, когда что-то меняется в ваших инструментах.