 AI Tracker
Google ajoute TPU 8tx pour l’inférence confidentielle et TPU 8i Max pour les contextes longs
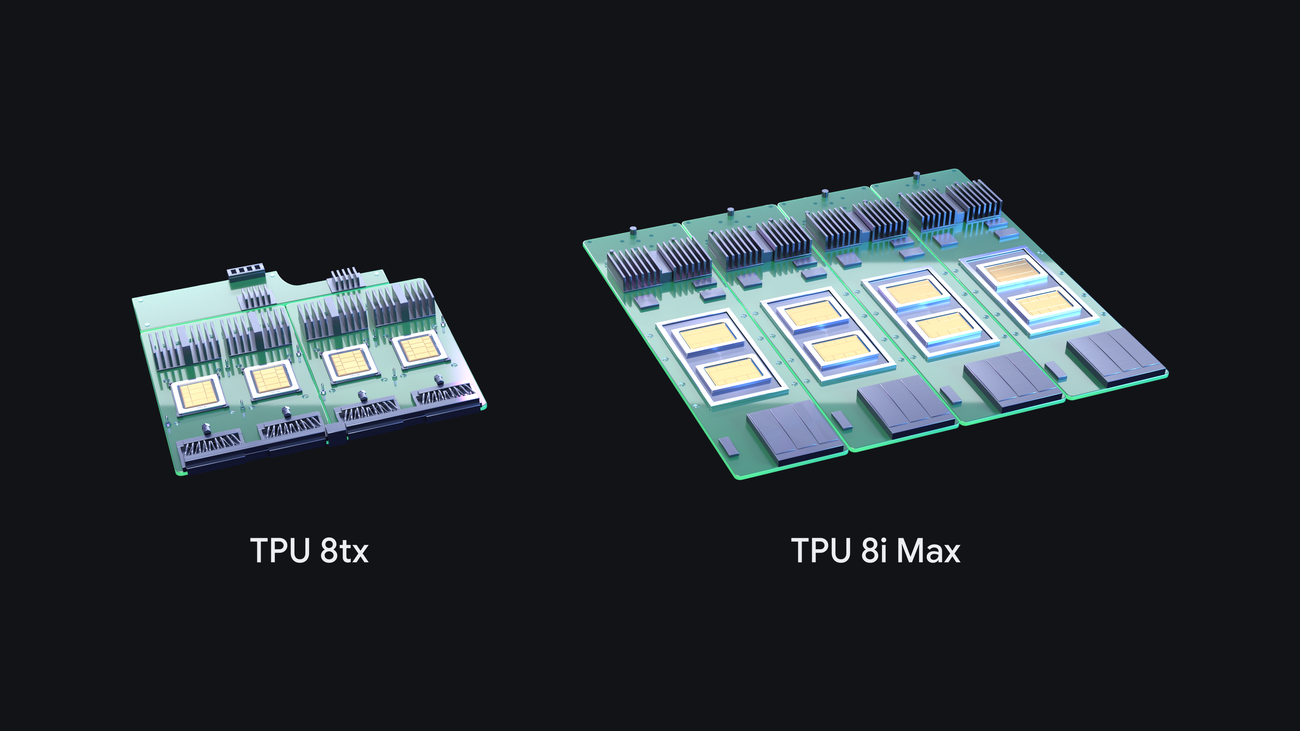
Google a annoncé deux systèmes supplémentaires dans sa gamme de TPU de huitième génération, portant selon l’entreprise à quatre le nombre de nouveaux systèmes TPU lancés en une seule année. Ils viennent s’ajouter à TPU 8t (entraînement) et TPU 8i (raisonnement à faible latence), présentés à Google Cloud Next en avril. Google n’a pas communiqué de dates de disponibilité dans son billet.
TPU 8tx est conçu pour l’inférence sécurisée et confidentielle, ainsi que pour l’entraînement à petite échelle destiné aux entreprises et aux administrations soumises à des réglementations. Google affirme qu’il protège les données et les poids des modèles dans le matériel, même pendant leur utilisation, qu’il repose sur le silicium de TPU 8t avec des hôtes AMD EPYC de 5e génération, et qu’il offre jusqu’à 2 fois moins de latence que TPU 8t, avec une baisse de performances quasi nulle.
TPU 8i Max intègre deux puces TPU 8i dans un même boîtier. Google affirme qu’il offre deux fois plus de capacité de calcul, de SRAM et de bande passante HBM que TPU 8i, qu’il vise les fenêtres de contexte très longues et qu’il loge deux fois plus de silicium dans l’espace déjà occupé par le rack.
Logiciels pour les développeurs. Google indique avoir publié TorchTPU en open source le mois dernier, permettant ainsi d’exécuter nativement sur les TPU le code PyTorch et les modèles Hugging Face, avec des backends TPU pour vLLM et SGLang. L’entreprise a également annoncé :
- une suite d’agents TPU open source, en préversion, qui s’intègre à Claude Code, Cursor et Google Antigravity pour faciliter la prise en main des TPU, diagnostiquer les goulots d’étranglement et optimiser les kernels ;
- un moteur XLA Serving Engine open source, permettant d’entraîner en Python et de servir les modèles dans un environnement d’exécution C++ sur les TPU, GPU et CPU ;
- TPU Sync, une couche open source de gestion de l’état des modèles qui déporte les caches KV hors de la puce. Google affirme qu’elle réduit de plus de 90 % la latence de transfert des KV et le délai avant le premier token ;
- Agent Compute Engine, qui suspend et reprend les sessions d’agents inactives afin de réduire les coûts d’infrastructure ;
- Cloud Pathways et le découpage dynamique de GKE, tous deux désormais disponibles de manière générale sur Google Kubernetes Engine ; Google affirme que le découpage dynamique réduit jusqu’à 5 fois le temps de démarrage des tâches et accélère jusqu’à 4,5 fois la reprise après une panne.
Google affirme également que sa pile vLLM-TorchTPU a atteint des performances prix de pointe dans les benchmarks InferenceX et AgentX ; il s’agit d’affirmations de Google.
Sources
- Nos nouveaux TPU : 8tx et 8i Max, conçus pour l’ère des agentsHacker News · 4 commentaires
Recevez ce genre d'actus en notification.
AI Tracker vous prévient dès que quelque chose change pour les outils que vous utilisez.