 AI Tracker
Google aggiunge TPU 8tx per l’inferenza riservata e TPU 8i Max per contesti lunghi
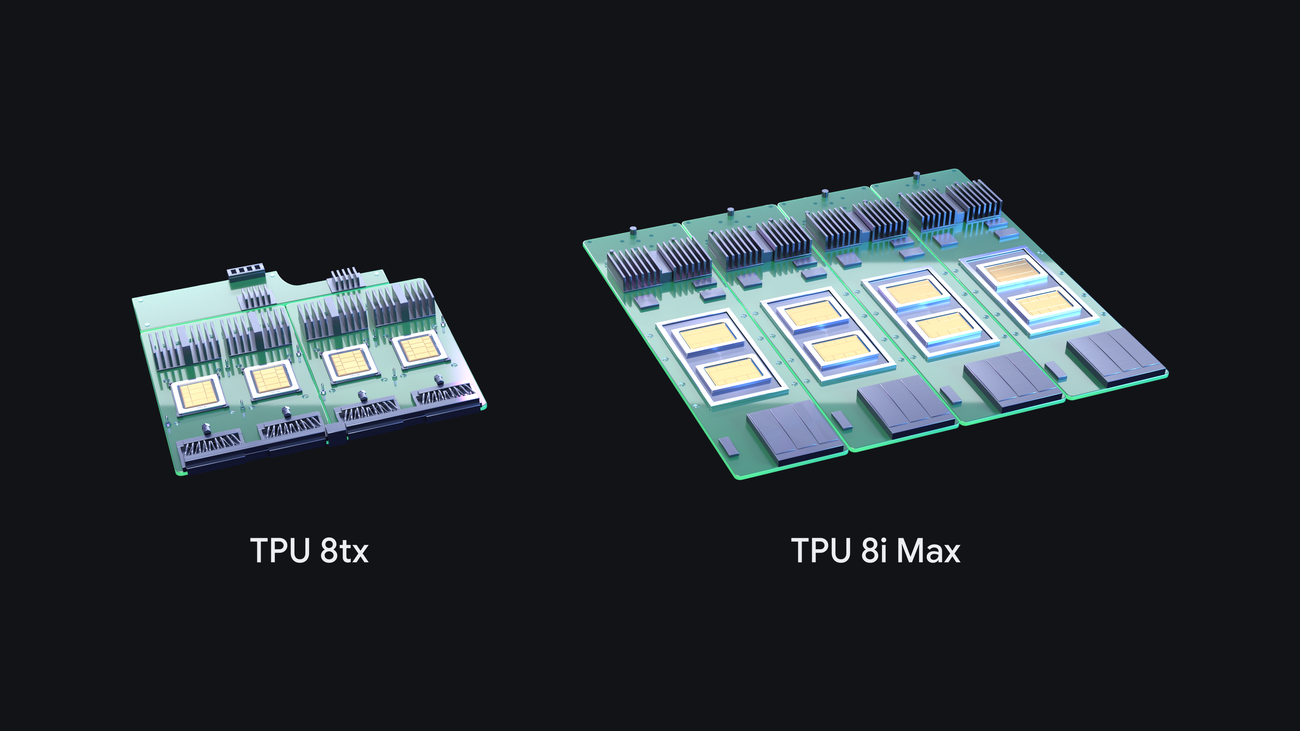
Google ha annunciato altri due sistemi della sua linea di TPU di ottava generazione, portando a quattro i nuovi sistemi TPU presentati in un solo anno, secondo quanto afferma. Si aggiungono a TPU 8t (per l’addestramento) e TPU 8i (per il ragionamento a bassa latenza), presentati a Google Cloud Next ad aprile. Nel post Google non ha indicato le date di disponibilità.
TPU 8tx è pensato per l’inferenza sicura e riservata e per l’addestramento su piccola scala di aziende e governi soggetti a regolamentazione. Google afferma che protegge hardware alla mano i dati e i pesi del modello anche durante l’elaborazione, che è basato sul silicio di TPU 8t con host AMD EPYC di quinta generazione e che offre una latenza fino a 2 volte inferiore rispetto a TPU 8t, con una penalizzazione delle prestazioni pressoché nulla.
TPU 8i Max integra due chip TPU 8i in un unico package. Google afferma che offre il doppio della capacità di calcolo, della SRAM e della larghezza di banda HBM di TPU 8i, è pensato per finestre di contesto molto ampie e alloggia il doppio del silicio nell’ingombro dei rack esistenti.
Software per sviluppatori. Google afferma di aver reso open source TorchTPU il mese scorso, consentendo così l’esecuzione nativa su TPU di codice PyTorch e modelli Hugging Face, con backend TPU per vLLM e SGLang. Ha inoltre annunciato:
- una suite open source di agenti TPU, in anteprima, che si integra con Claude Code, Cursor e Google Antigravity per configurare l’uso delle TPU, individuare colli di bottiglia e ottimizzare i kernel;
- XLA Serving Engine, open source, per addestrare in Python e servire modelli in un runtime C++ su TPU, GPU e CPU;
- TPU Sync, un livello open source per lo stato dei modelli che sposta le cache KV fuori dal chip su livelli di memoria; secondo Google, riduce di oltre il 90% la latenza del trasferimento KV e il tempo al primo token;
- Agent Compute Engine, che sospende e riprende le sessioni inattive degli agenti per ridurre i costi dell’infrastruttura;
- Cloud Pathways e GKE dynamic slicing, entrambi ora disponibili in generale su Google Kubernetes Engine; Google afferma che il dynamic slicing riduce i tempi di avvio dei job fino a 5 volte e accelera il ripristino dai guasti fino a 4,5 volte.
Google afferma inoltre che il suo stack vLLM-TorchTPU ha raggiunto prestazioni in termini di rapporto qualità-prezzo all’avanguardia nei benchmark InferenceX e AgentX; si tratta di affermazioni di Google.
Fonti
- Le nostre TPU più recenti: 8tx e 8i Max, progettate per l’era degli agentiHacker News · 4 commenti
Ricevi notizie come questa via push.
AI Tracker ti avvisa quando cambia qualcosa negli strumenti che usi.