 AI Tracker
Google adiciona o TPU 8tx para inferência confidencial e o TPU 8i Max para contextos longos
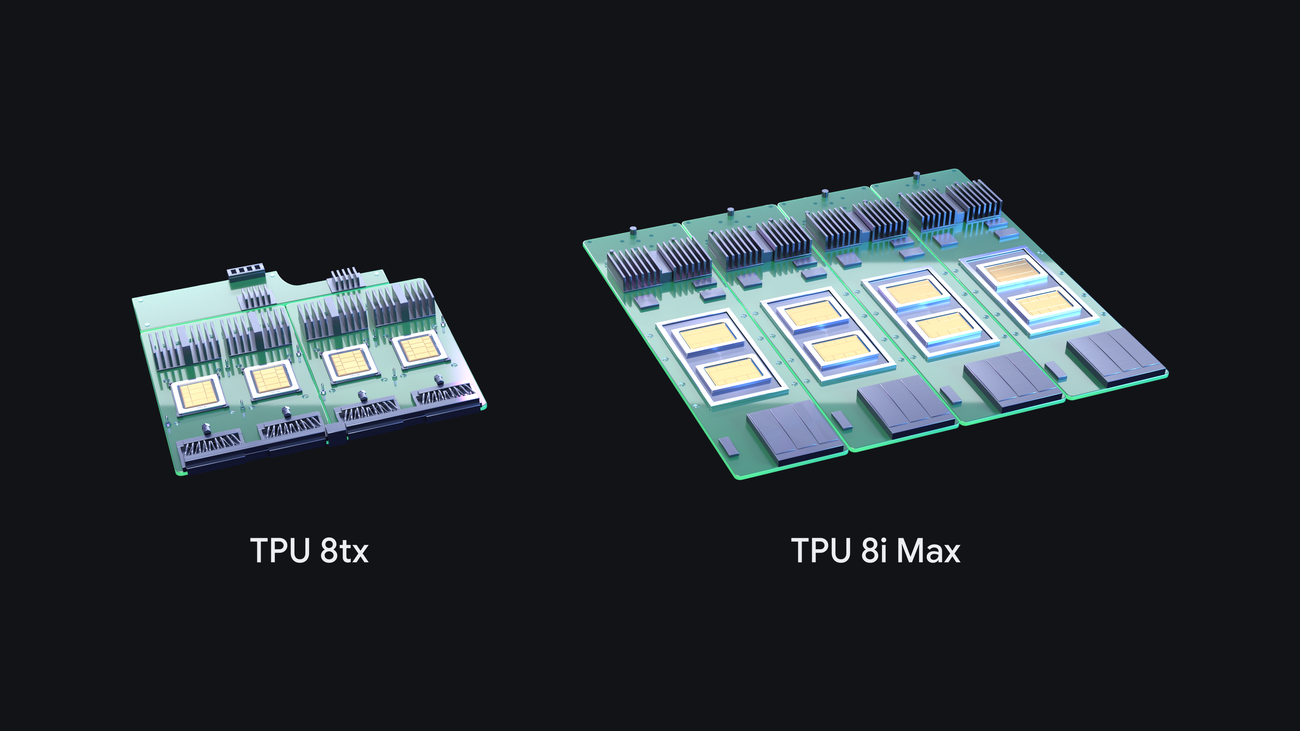
O Google anunciou mais dois sistemas em sua linha de TPUs de oitava geração, que, segundo a empresa, agora conta com quatro novos sistemas lançados em um único ano. Eles se juntam ao TPU 8t (treinamento) e ao TPU 8i (raciocínio de baixa latência), apresentados no Google Cloud Next em abril. O Google não informou datas de disponibilidade na publicação.
TPU 8tx é voltado para inferência segura e confidencial e treinamento em pequena escala para empresas de setores regulamentados e governos. O Google diz que ele mantém dados e pesos dos modelos protegidos por hardware mesmo durante o uso, é baseado no silício do TPU 8t com hosts AMD EPYC de 5ª geração e oferece latência até 2 vezes menor que a do TPU 8t, com uma penalidade de desempenho quase nula.
TPU 8i Max coloca dois chips TPU 8i em um único pacote. O Google diz que ele tem o dobro da capacidade computacional, da SRAM e da largura de banda da HBM do TPU 8i, é voltado para janelas de contexto muito grandes e acomoda o dobro de silício no espaço ocupado pelo rack existente.
Software para desenvolvedores. O Google diz que abriu o código do TorchTPU no mês passado, permitindo que código PyTorch e modelos do Hugging Face sejam executados nativamente em TPUs, com backends de TPU para vLLM e SGLang. A empresa também anunciou:
- um conjunto de agentes de TPU de código aberto, em prévia, que se integra ao Claude Code, Cursor e Google Antigravity para facilitar a adoção de TPUs, diagnosticar gargalos e ajustar kernels;
- um XLA Serving Engine de código aberto, para treinar em Python e servir em um runtime C++ em TPUs, GPUs e CPUs;
- o TPU Sync, uma camada de estado de modelo de código aberto que transfere caches KV para fora do chip em camadas e que, segundo o Google, reduz em mais de 90% a latência de transferência de KV e o tempo até o primeiro token;
- o Agent Compute Engine, que suspende e retoma sessões ociosas de agentes para reduzir os custos de infraestrutura;
- o Cloud Pathways e o fatiamento dinâmico do GKE, ambos agora disponíveis ao público geral no Google Kubernetes Engine; o Google diz que o fatiamento dinâmico reduz o tempo de inicialização de tarefas em até 5 vezes e acelera a recuperação de falhas em até 4,5 vezes.
O Google também diz que sua pilha vLLM-TorchTPU alcançou desempenho de custo de ponta nos benchmarks InferenceX e AgentX; essas são afirmações do próprio Google.
Fontes
- Nossas TPUs mais recentes: 8tx e 8i Max, projetadas para a era agênticaHacker News · 4 comentários
Receba notícias como esta por push.
O AI Tracker avisa você quando algo muda nas ferramentas que você usa.