 AI Tracker
Google voegt TPU 8tx toe voor vertrouwelijke inferentie en TPU 8i Max voor lange contexten
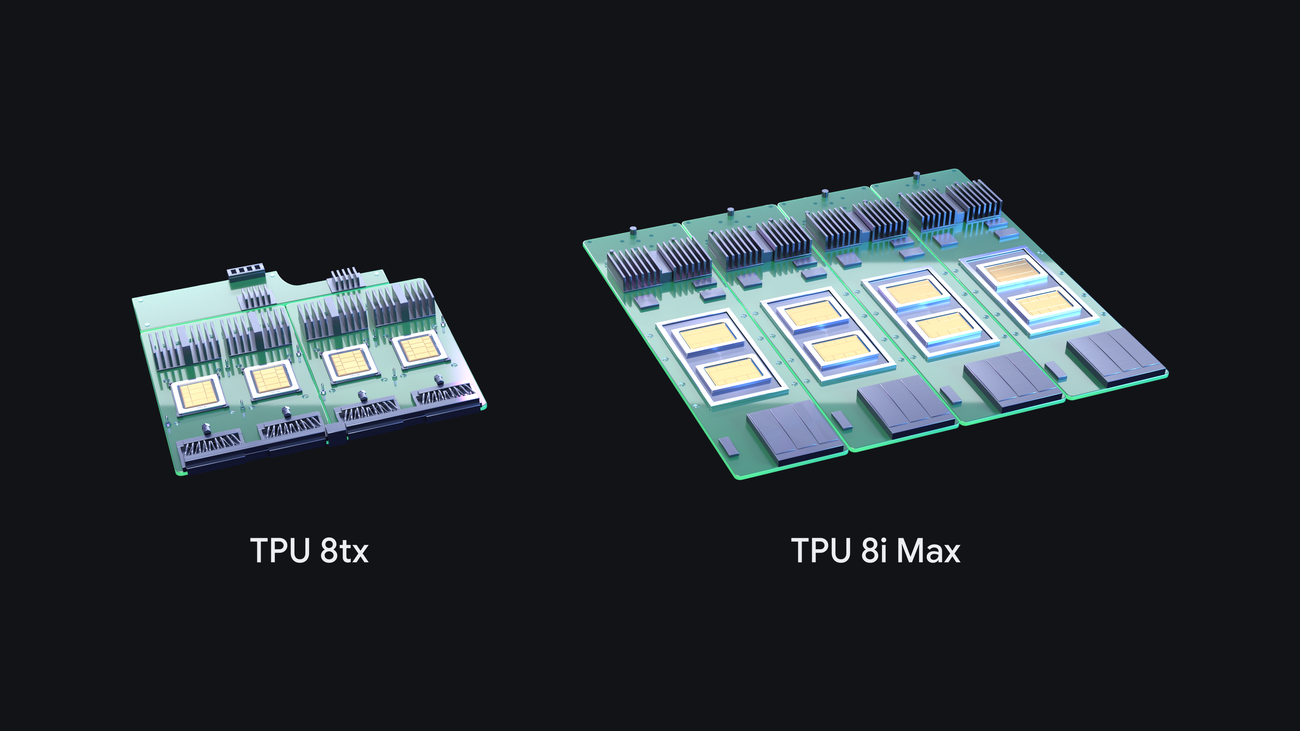
Google heeft twee systemen toegevoegd aan zijn TPU-lijn van de achtste generatie. Volgens het bedrijf komt het daarmee op vier nieuwe TPU-systemen in één jaar. Ze voegen zich bij TPU 8t (training) en TPU 8i (redeneren met lage latentie), die in april tijdens Google Cloud Next werden geïntroduceerd. Google noemde in het bericht geen beschikbaarheidsdatums.
TPU 8tx is bedoeld voor veilige, vertrouwelijke inferentie en kleinschalige training voor gereguleerde bedrijven en overheden. Volgens Google blijven gegevens en modelgewichten zelfs tijdens gebruik beschermd in hardware. Het systeem is gebaseerd op TPU 8t-silicium met AMD EPYC-hosts van de 5e generatie en biedt tot 2x lagere latentie dan TPU 8t, met vrijwel geen prestatieverlies.
TPU 8i Max plaatst twee TPU 8i-chips op één package. Volgens Google heeft het systeem twee keer zoveel rekenkracht, SRAM en HBM-bandbreedte als TPU 8i, is het bedoeld voor zeer grote contextvensters en past er twee keer zoveel silicium in de bestaande rackruimte.
Software voor ontwikkelaars. Google zegt TorchTPU vorige maand als open source beschikbaar te hebben gemaakt, zodat PyTorch-code en Hugging Face-modellen native op TPU's draaien, met TPU-backends voor vLLM en SGLang. Het bedrijf kondigde ook het volgende aan:
- een open-sourcesuite met TPU-agents, momenteel in preview, die integreert met Claude Code, Cursor en Google Antigravity om TPU's in gebruik te nemen, knelpunten op te sporen en kernels af te stellen;
- een open-source XLA Serving Engine, waarmee je in Python kunt trainen en modellen kunt serveren in een C++-runtime op TPU's, GPU's en CPU's;
- TPU Sync, een open-sourcelaag voor modelstatus die KV-caches naar andere opslag verplaatst. Volgens Google verlaagt dit de latentie van KV-overdracht en de tijd tot het eerste token met meer dan 90%;
- Agent Compute Engine, dat inactieve agentsessies opschort en hervat om de infrastructuurkosten te verlagen;
- Cloud Pathways en GKE dynamic slicing, beide nu algemeen beschikbaar op Google Kubernetes Engine. Volgens Google verkort dynamic slicing de opstarttijd van taken met maximaal 5x en versnelt het herstel na storingen met maximaal 4,5x.
Google zegt ook dat zijn vLLM-TorchTPU-stack toonaangevende prijs-prestatieverhoudingen behaalde op de benchmarks InferenceX en AgentX; dit zijn claims van Google zelf.
Bronnen
- Onze nieuwste TPU's: 8tx en 8i Max, gebouwd voor het agentische tijdperkHacker News · 4 reacties
Krijg nieuws als dit als pushmelding.
AI Tracker waarschuwt je zodra er iets verandert aan de tools die je gebruikt.