 AI Tracker
Google, 기밀 추론용 TPU 8tx와 긴 컨텍스트용 TPU 8i Max 추가
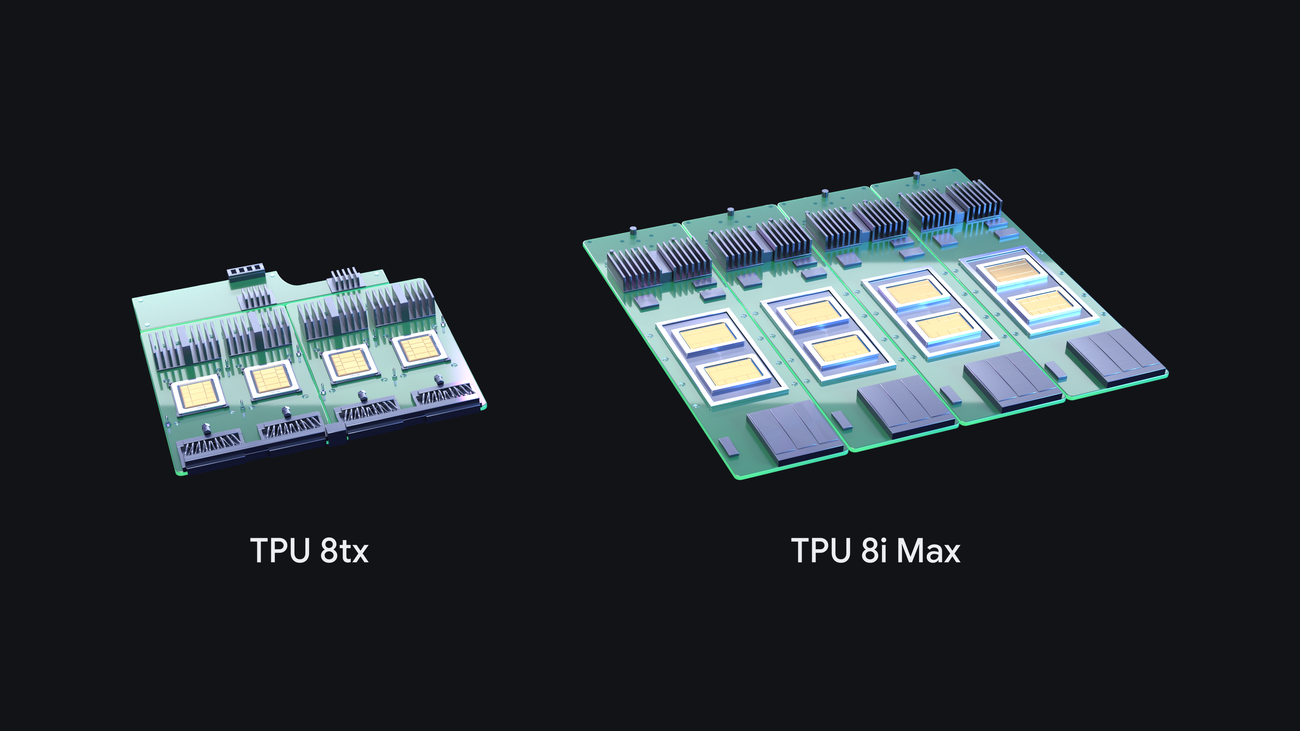
Google은 8세대 TPU 제품군에 시스템 두 종을 추가로 발표했습니다. Google에 따르면 이로써 한 해 동안 새 TPU 시스템 네 종을 선보이게 됐습니다. 이 제품들은 4월 Google Cloud Next에서 공개된 TPU 8t(학습용)와 TPU 8i(저지연 추론용)에 이어 출시됩니다. Google은 게시물에서 출시 일정을 밝히지 않았습니다.
TPU 8tx는 규제가 엄격한 기업과 정부를 위한 안전하고 기밀이 보장되는 추론 및 소규모 학습을 겨냥합니다. Google은 사용 중에도 하드웨어에서 데이터와 모델 가중치를 보호하며, 5세대 AMD EPYC 호스트와 TPU 8t 실리콘을 기반으로 하고, 성능 저하를 거의 일으키지 않으면서 TPU 8t보다 지연 시간을 최대 2배 줄인다고 밝혔습니다.
TPU 8i Max는 TPU 8i 칩 두 개를 하나의 패키지에 담았습니다. Google에 따르면 TPU 8i의 연산 성능, SRAM 및 HBM 대역폭을 두 배로 제공하고, 매우 긴 컨텍스트 윈도우를 겨냥하며, 기존 랙 공간에 실리콘을 두 배로 탑재합니다.
개발자를 위한 소프트웨어. Google은 지난달 TorchTPU를 오픈소스로 공개해 PyTorch 코드와 Hugging Face 모델을 TPU에서 네이티브로 실행할 수 있게 했으며, vLLM과 SGLang용 TPU 백엔드도 제공한다고 밝혔습니다. 또한 다음을 발표했습니다.
- Claude Code, Cursor, Google Antigravity에 연동해 TPU 온보딩, 병목 현상 진단, 커널 튜닝을 지원하는 프리뷰 단계의 오픈소스 TPU 에이전트 제품군
- TPU, GPU, CPU 전반에서 Python으로 학습하고 C++ 런타임으로 서빙할 수 있게 하는 오픈소스 XLA Serving Engine
- 칩 외부에 KV 캐시를 계층화하는 오픈소스 모델 상태 계층 TPU Sync. Google은 이를 통해 KV 전송 지연 시간과 첫 토큰 생성 시간이 90% 넘게 줄어든다고 밝혔습니다.
- 유휴 에이전트 세션을 일시 중단했다가 재개해 인프라 비용을 줄이는 Agent Compute Engine
- 현재 Google Kubernetes Engine에서 정식 제공되는 Cloud Pathways와 GKE dynamic slicing. Google은 dynamic slicing이 작업 시작 시간을 최대 5배 단축하고 장애 복구 속도를 최대 4.5배 높인다고 밝혔습니다.
Google은 자체 vLLM-TorchTPU 스택이 InferenceX 및 AgentX 벤치마크에서 가격 대비 성능 면에서 최고 수준을 기록했다고도 밝혔습니다. 이는 Google 자체 주장입니다.
출처
- 최신 TPU: 에이전트 시대를 위해 설계된 8tx와 8i MaxHacker News · 댓글 4개
이런 뉴스를 푸시로 받아보세요.
사용하는 도구에 변화가 생기면 AI Tracker가 알려드립니다.