 AI Tracker
Google 推出 TPU 8tx,支持机密推理;推出 TPU 8i Max,支持长上下文
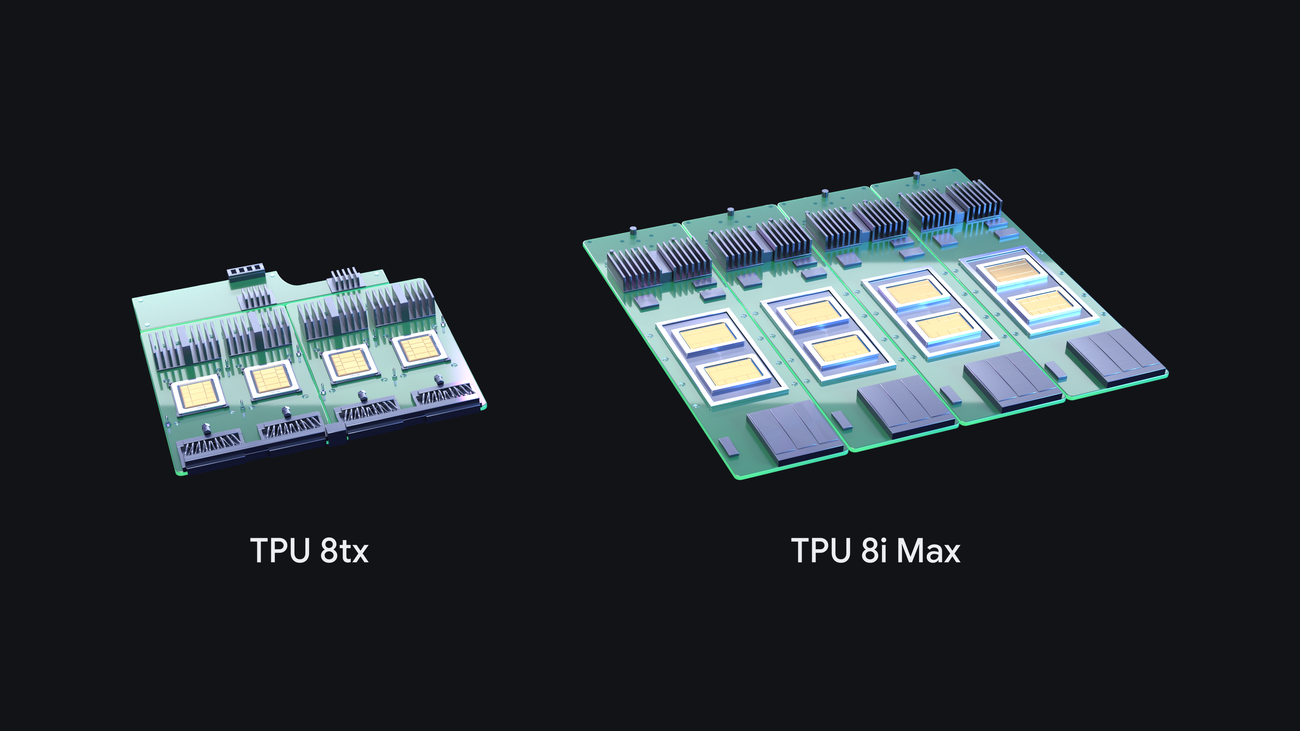
Google 宣布推出第八代 TPU 系列中的另外两套系统。据其称,这意味着他们在一年内推出了四套全新的 TPU 系统。这两套系统加入了 TPU 8t(用于训练)和 TPU 8i(用于低延迟推理)的行列;后两者于 4 月在 Google Cloud Next 上发布。Google 在这篇文章中没有公布上市日期。
TPU 8tx 面向安全、机密推理,以及受监管企业和政府机构的小规模训练。Google 称,即使数据和模型权重正在使用中,该系统也能通过硬件保护它们;它基于 TPU 8t 芯片,并搭配第 5 代 AMD EPYC 主机;与 TPU 8t 相比,其延迟最高可降低 2 倍,且性能损失近乎为零。
TPU 8i Max 在一个封装上集成了两颗 TPU 8i 芯片。Google 称,它的计算能力、SRAM 和 HBM 带宽均为 TPU 8i 的两倍,面向超大上下文窗口,并能在现有机架占用空间内容纳两倍的芯片。
面向开发者的软件。 Google 称,上个月开源了 TorchTPU,因此 PyTorch 代码和 Hugging Face 模型可以在 TPU 上原生运行,并为 vLLM 和 SGLang 提供 TPU 后端。该公司还宣布:
- 一套处于预览阶段的开源 TPU 智能体工具集,可接入 Claude Code、Cursor 和 Google Antigravity,帮助用户开始使用 TPU、诊断瓶颈并调优内核;
- 开源的 XLA Serving Engine,可用 Python 训练,并在 C++ 运行时中跨 TPU、GPU 和 CPU 提供服务;
- TPU Sync,这是一个开源模型状态层,可将 KV 缓存分层移出芯片。Google 称,它能将 KV 传输延迟和首个 token 的生成时间降低 90% 以上;
- Agent Compute Engine,可暂停并恢复处于空闲状态的智能体会话,从而降低基础设施成本;
- Cloud Pathways 和 GKE dynamic slicing,两者现已在 Google Kubernetes Engine 上全面开放。Google 称,dynamic slicing 可将作业启动时间缩短最多 5 倍,并将故障恢复速度提高最多 4.5 倍。
Google 还称,其 vLLM-TorchTPU 技术栈在 InferenceX 和 AgentX 基准测试中达到了业界领先的性价比;这些说法来自 Google 自身。
来源
- 我们最新的 TPU:为智能体时代打造的 8tx 和 8i MaxHacker News · 4 条评论
这样的新闻,第一时间推送给你。
你用的 AI 工具一有变化,AI Tracker 就会提醒你。