 AI Tracker
Artificial Analysis и Arena ставят Kimi K3.1 Pro на 4-е место в своих рейтингах и на #8 в Code Arena WebDev
Две независимые оценочные платформы опубликовали результаты для Kimi K3.1 Pro от Moonshot в течение часа после запуска модели. Обе указывают цену $2 за миллион входных токенов и $10 за миллион выходных токенов; Artificial Analysis указывает цену кэшированных входных токенов $0.20 — на 33% ниже, чем у Kimi K3.
Artificial Analysis сообщает, что модель набирает 55 баллов в Intelligence Index — на 11 больше, чем Kimi K3 (44), и занимает 4-е место в общем рейтинге после Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) и Muse Wonder Full (56). Другие показатели:
- 3-е место в GDPval-AA с результатом 1,846 Elo — на 312 выше, чем у Kimi K3.
- Самый высокий результат Terminal-Bench 4.0 среди всех протестированных платформой моделей — 67% (Kimi K3: 13%; Claude Sonnet 5.5: 64%).
- Результат AutomationBench-AA вырос с 58% до 73%. Улучшения в Humanity's Last Exam (с 47% до 52%), CritPt (с 23% до 25%) и SciCode (с 59% до 61%) скромнее.
- Доля галлюцинаций в AA-Omniscience снизилась с 53% до 44%.
- Стоимость задачи — около $1.98, примерно на прежнем уровне с Kimi K3, поскольку модель использует на 14% больше выходных токенов.
- После публикации весов модель, по оценке Artificial Analysis, станет лучшей среди моделей с открытыми весами, сократив отставание от проприетарных моделей с 12 до 3 баллов.
Arena сообщает, что модель занимает #8 в Code Arena: WebDev с результатом 1692 балла — на 9 позиций и 37 баллов выше, чем Kimi K3, — наравне с Claude Opus 5 (Max) при, как утверждает Arena, на 70% меньшей стоимости. Медианная стоимость задачи составляет $1.23 — на 29% меньше, чем у Kimi K3. Arena также сообщает о #7 в Brand & Marketing и #9 в Simulations и утверждает, что с открытыми весами модель стала бы лучшей открытой моделью в WebDev, опередив DeepSeek V4.1 Flash.
Artificial Analysis Cyber Index (опубликован позже в тот же день): Kimi K3.1 Pro набирает 64% — на 23 пункта выше, чем Kimi K3 (41%). По словам Artificial Analysis, это делает модель лучшей среди общедоступных моделей и второй в общем рейтинге — после доверенной версии GPT-6 Sol (Daybreak Blue, max) от OpenAI с доступом по запросу (69%), но выше DeepSeek V4.1 Flash 1017 (57%). Модель показывает лучший результат CyberGym-E2E-AA среди всех протестированных платформой моделей (95%), набирает 37% в DeepsecBench-AA и 61% в CWE-Bench-AA (там лидирует DeepSeek V4.1 Flash 1017 с результатом 69%), а также не отказывается отвечать по соображениям безопасности. Стоимость задачи — $2.81, на 15% выше, чем у Kimi K3, поскольку модель использует примерно вдвое больше входных токенов.
Extended NYT Connections (независимый бенчмарк Lech Mazur, опубликован позже в тот же день): Kimi K3.1 Pro (high) набирает 93.4 — чуть меньше, чем Kimi K3 с результатом 93.6, — при этом используя меньше токенов на рассуждения. Mazur также протестировал GPT-6 Astra (max) и GPT-6.1 Sol (max); Gemini 4 Argon (high) по-прежнему занимает первое место.
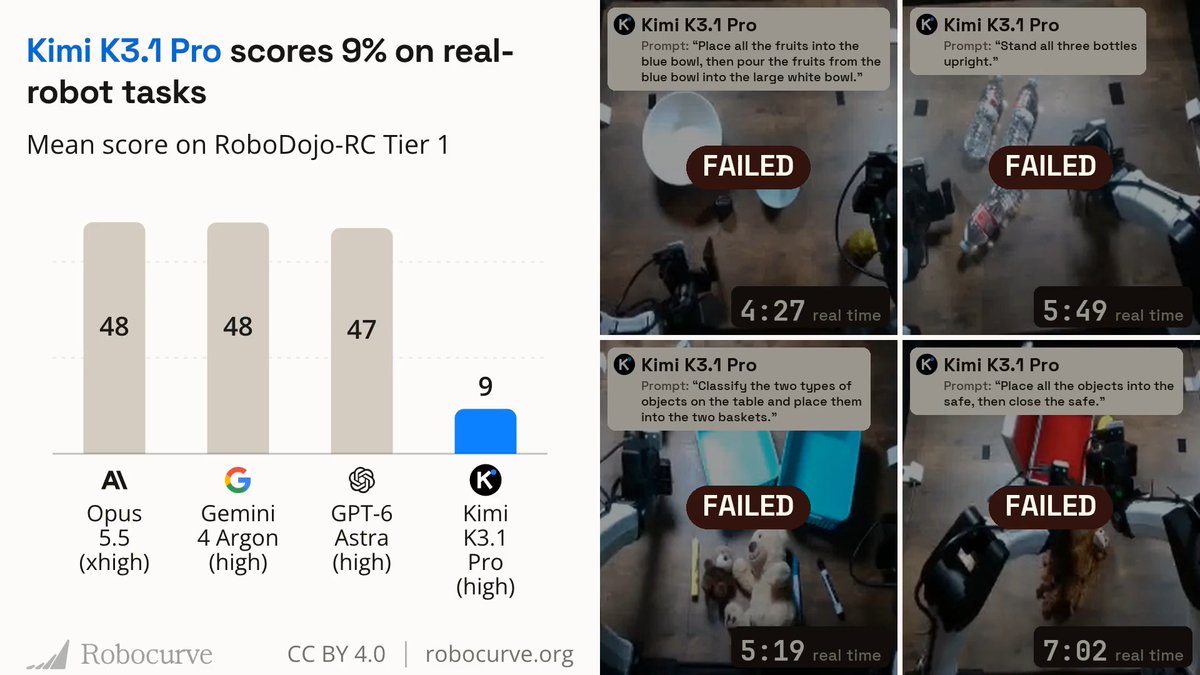
Robocurve real-robot tasks (опубликованы тем же вечером по тихоокеанскому времени): Robocurve, организация, оценивающая физические ИИ-системы, сообщает, что Kimi K3.1 Pro набирает 9% в тестах на реальных роботах, уступая Claude Opus 5.5, Gemini 4 Argon и GPT-6 Astra.
Agent Arena (опубликовано Arena 24 октября): Kimi K3.1 Pro (Max) занимает #11 в Agent Arena; чистый прирост качества составляет 7.6% по итогам более чем 4,000 реальных агентных сессий пользователей Arena. По словам Arena, это сделало бы модель лучшей открытой моделью в Agent Arena, опередив DeepSeek V4.1 Flash.
VulnPR-100 (опубликовано 24 октября пользователем, запустившим бенчмарк BugBunny): получив 100 pull request с известными уязвимостями и по часу на каждый, Kimi K3.1 Pro обнаружила 47 уязвимостей за $124.69 — на 10 больше, чем Kimi K3, при экономии $20.54. В перепубликованном посте добавлено, что DeepSeek V4.1 Flash 1017 обнаружила 54 уязвимости за $7.53.
Mazebench (опубликовано автором 24 октября): Kimi K3.1 Pro набирает 2% — это, как утверждается в посте, первый нетривиальный результат модели с открытыми весами; DeepSeek V4.1 Flash набирает 1%.
Design Creativity Bench (опубликовано сопровождающим бенчмарк 24 октября): общий показатель креативности Kimi K3.1 Pro вырос с 40.4 до 45.8 по сравнению с Kimi K3. Показатель уместности вырос с 96.8% до 98.5% и, согласно посту о бенчмарке, превысил результаты всех остальных оценённых моделей с открытыми весами, сравнявшись с Claude Fable 5.1. Модель генерирует дизайны почти вдвое быстрее Kimi K3, а медианная стоимость дизайна снизилась на 18% — с $0.570 до $0.466.
DesignArena Website leaderboard (опубликовано DesignArena 24 октября): по прогнозу, Kimi K3.1 Pro займёт #1 среди моделей с открытыми весами и разделит #3 в общем рейтинге, уступая только Muse Wonder (max) и Muse Spark 1.3 (xhigh) и сравнявшись с Muse Spark 1.3 Max. По данным DesignArena, на лидерборде моделей с открытыми весами она опережает Kimi K3 на 15 баллов Elo.
LLM Creative Story-Writing Benchmark (опубликован Lech Mazur 24 октября): Kimi K3.1 Pro (high) набирает 2.72 против 2.35 у Kimi K3. В сравнении на 50 одинаковых запросах модель одерживает 35 побед, 8 раз фиксируется ничья и 7 раз выигрывает Kimi K3. По словам Mazur, главное улучшение — более сильное построение сюжета: обязательные элементы последовательнее влияют на решения персонажей и их последствия. Кроме того, модель использует на 34% меньше токенов на рассуждения.
Источники
- Большая новость: @Kimi_Moonshot снова входит в топ-4 лабораторий Code Arena: WebDev благодаря выходу Kimi K3.1 Pro!X · 3 комментария
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 комментариев
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 комментарий
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 комментариев
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 комментария
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 комментарий
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 комментариев
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 комментариев
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 комментария
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 комментариев
Обсуждения
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 комментария
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 комментариев
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 комментариев
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 комментариев
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 комментариев
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 комментария
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 комментария
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 комментария
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 комментариев
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 комментариев
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 комментариев
Получайте такие новости в push.
AI Tracker сообщит, когда что-то меняется в ваших инструментах.