 AI Tracker
Artificial Analysis dan Arena menempatkan Kimi K3.1 Pro di peringkat ke-4 pada indeks mereka dan #8 di Code Arena WebDev
Dua evaluator independen menerbitkan hasil untuk Kimi K3.1 Pro dari Moonshot dalam waktu satu jam setelah peluncurannya. Keduanya menetapkan harga $2 per juta token input dan $10 per juta token output; Artificial Analysis mencantumkan harga input cache sebesar $0.20, 33% lebih rendah daripada Kimi K3.
Artificial Analysis menyebut model ini meraih skor 55 pada Intelligence Index, 11 poin di atas Kimi K3 (44) dan peringkat ke-4 secara keseluruhan, di bawah Claude Opus 5.5 (58), Claude Sonnet 5.5 (56), dan Muse Wonder Full (56). Angka lainnya:
- Peringkatnya ke-3 di GDPval-AA dengan 1.846 Elo, naik 312 poin dari Kimi K3.
- Skornya di Terminal-Bench 4.0 adalah yang tertinggi di antara semua model yang telah diuji, yakni 67% (Kimi K3: 13%; Claude Sonnet 5.5: 64%).
- AutomationBench-AA naik dari 58% menjadi 73%. Kenaikan pada Humanity's Last Exam (47% menjadi 52%), CritPt (23% menjadi 25%), dan SciCode (59% menjadi 61%) lebih kecil.
- Tingkat halusinasinya pada AA-Omniscience turun dari 53% menjadi 44%.
- Biaya per tugas sekitar $1.98, kurang lebih sama dengan Kimi K3, karena model ini menggunakan 14% lebih banyak token output.
- Setelah bobotnya dipublikasikan, Artificial Analysis menyebut model ini akan menjadi model open-weight dengan skor tertinggi, memperkecil selisih dengan model proprietary dari 12 poin menjadi 3.
Arena menyebut model ini berada di peringkat #8 di Code Arena: WebDev dengan 1692 poin, naik 9 posisi dan 37 poin dari Kimi K3, setara dengan Claude Opus 5 (Max) dengan biaya yang menurut Arena 70% lebih rendah. Biaya median per tugasnya $1.23, 29% lebih rendah daripada Kimi K3. Arena juga melaporkan peringkat #7 di Brand & Marketing dan #9 di Simulations, serta menyebut bahwa dengan bobot terbuka, model ini akan menjadi model open teratas di WebDev, mengungguli DeepSeek V4.1 Flash.
Artificial Analysis Cyber Index (diunggah pada hari itu juga, lebih belakangan): Kimi K3.1 Pro meraih skor 64%, naik 23 poin dari Kimi K3 (41%). Artificial Analysis menyebut skor itu menjadikannya model yang tersedia secara terbuka dengan peringkat tertinggi dan peringkat kedua secara keseluruhan, hanya di bawah GPT-6 Sol (Daybreak Blue, max) milik OpenAI yang memerlukan akses tepercaya dengan 69%, serta di atas DeepSeek V4.1 Flash 1017 (57%). Model ini meraih skor CyberGym-E2E-AA tertinggi di antara semua model yang telah diuji (95%), mendapat 37% di DeepsecBench-AA dan 61% di CWE-Bench-AA (DeepSeek V4.1 Flash 1017 memimpin dengan 69%), serta tidak menolak permintaan atas dasar keselamatan. Biaya per tugasnya $2.81, 15% lebih tinggi daripada Kimi K3, karena model ini menggunakan sekitar dua kali lebih banyak token input.
Extended NYT Connections (benchmark independen Lech Mazur, diunggah lebih belakangan): Kimi K3.1 Pro (high) meraih skor 93.4, sedikit di bawah Kimi K3 dengan 93.6, sementara menggunakan lebih sedikit token penalaran. Mazur juga menguji GPT-6 Astra (max) dan GPT-6.1 Sol (max); Gemini 4 Argon (high) masih berada di posisi pertama.
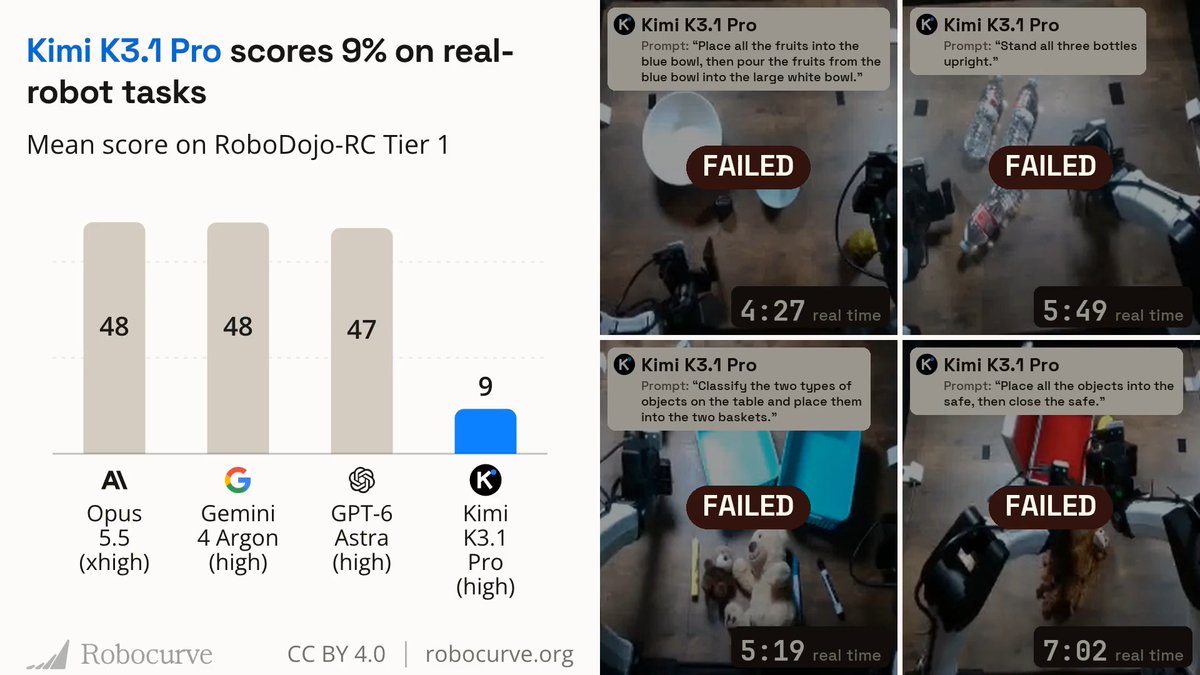
Tugas robot nyata Robocurve (diunggah malam itu, waktu Pasifik): Robocurve, organisasi yang melakukan benchmarking physical AI, menyebut Kimi K3.1 Pro meraih skor 9% pada tugas robot nyatanya, di bawah Claude Opus 5.5, Gemini 4 Argon, dan GPT-6 Astra.
Agent Arena (diunggah 24 Oktober oleh Arena): Kimi K3.1 Pro (Max) masuk Agent Arena di peringkat #11, dengan peningkatan bersih 7.6% pada lebih dari 4.000 sesi agentic dunia nyata dari pengguna Arena. Arena menyebut hasil itu akan menjadikannya model open teratas di Agent Arena, mengungguli DeepSeek V4.1 Flash.
VulnPR-100 (diunggah 24 Oktober oleh pengguna yang menjalankan benchmark BugBunny): saat diberi 100 pull request dengan kerentanan yang diketahui dan waktu satu jam per PR, Kimi K3.1 Pro menemukan 47 dengan biaya $124.69, 10 lebih banyak daripada Kimi K3 dengan biaya $20.54 lebih rendah. Unggahan yang meneruskan hasil menambahkan bahwa DeepSeek V4.1 Flash 1017 menemukan 54 dengan biaya $7.53.
Mazebench (diunggah 24 Oktober oleh pembuatnya): Kimi K3.1 Pro meraih skor 2%, yang dalam unggahan itu disebut sebagai skor nontrivial pertama untuk model open-weight; DeepSeek V4.1 Flash meraih 1%.
Design Creativity Bench (diunggah 24 Oktober oleh pengelolanya): skor kreativitas keseluruhan Kimi K3.1 Pro naik dari 40.4 menjadi 45.8 dibandingkan Kimi K3. Skor kesesuaiannya naik dari 96.8% menjadi 98.5%, yang menurut unggahan benchmark tersebut melampaui semua model open-weight lain yang telah dievaluasi dan setara dengan Claude Fable 5.1. Model ini menghasilkan desain hampir dua kali lebih cepat daripada Kimi K3, dan biaya median per desain turun 18%, dari $0.570 menjadi $0.466.
Papan peringkat Website DesignArena (diunggah 24 Oktober oleh DesignArena): Kimi K3.1 Pro diproyeksikan menempati peringkat #1 di antara model open-weight dan berada di posisi bersama untuk #3 secara keseluruhan, hanya di bawah Muse Wonder (max) dan Muse Spark 1.3 (xhigh), serta setara dengan Muse Spark 1.3 Max. DesignArena menyebut model ini unggul 15 poin Elo atas Kimi K3 di papan peringkat open-weight.
LLM Creative Story-Writing Benchmark (diunggah 24 Oktober oleh Lech Mazur): Kimi K3.1 Pro (high) meraih skor 2.72, naik dari 2.35 untuk Kimi K3. Dalam 50 prompt berpasangan, model ini mencatat 35 kemenangan, 8 seri, dan 7 kekalahan melawan Kimi K3. Mazur menyebut peningkatan utamanya adalah alur cerita yang lebih kuat, dengan elemen yang diminta secara lebih konsisten membentuk keputusan karakter dan konsekuensinya, serta penggunaan token penalaran 34% lebih sedikit.
Sumber
- Kabar besar: @Kimi_Moonshot kembali masuk 4 besar lab di Code Arena: WebDev dengan peluncuran Kimi K3.1 Pro!X · 3 komentar
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 komentar
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 komentar
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 komentar
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 komentar
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 komentar
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 komentar
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 komentar
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 komentar
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 komentar
Diskusi
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 komentar
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 komentar
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 komentar
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 komentar
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 komentar
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 komentar
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 komentar
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 komentar
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 komentar
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 komentar
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 komentar
Dapatkan berita seperti ini lewat push.
AI Tracker memberi tahu Anda saat ada perubahan pada alat yang Anda pakai.