 AI Tracker
Artificial Analysis e Arena colocam Kimi K3.1 Pro em 4º lugar em seus índices e em #8 no Code Arena WebDev
Dois avaliadores independentes publicaram resultados para o Kimi K3.1 Pro, da Moonshot, menos de uma hora após seu lançamento. Ambos informam o preço de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída; a Artificial Analysis lista o preço da entrada em cache em US$ 0,20, 33% abaixo do Kimi K3.
Artificial Analysis afirma que o modelo marcou 55 em seu Intelligence Index, 11 pontos acima do Kimi K3 (44) e 4º lugar geral, atrás de Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) e Muse Wonder Full (56). Outros resultados:
- Ficou em 3º lugar no GDPval-AA, com 1.846 Elo, 312 a mais que o Kimi K3.
- Obteve a maior pontuação no Terminal-Bench 4.0 entre todos os modelos testados pela organização: 67% (Kimi K3: 13%; Claude Sonnet 5.5: 64%).
- A pontuação no AutomationBench-AA sobe de 58% para 73%. Os avanços no Humanity's Last Exam (47% para 52%), CritPt (23% para 25%) e SciCode (59% para 61%) são menores.
- A taxa de alucinação no AA-Omniscience cai de 53% para 44%.
- O custo por tarefa é de cerca de US$ 1,98, aproximadamente o mesmo que o do Kimi K3, porque o modelo usa 14% mais tokens de saída.
- Quando os pesos forem publicados, a Artificial Analysis diz que ele será o modelo de pesos abertos com maior pontuação, reduzindo de 12 para 3 pontos a diferença em relação aos modelos proprietários.
Arena afirma que o modelo está em #8 no Code Arena: WebDev, com 1.692 pontos — 9 posições e 37 pontos acima do Kimi K3 —, empatado com Claude Opus 5 (Max) a um custo que, segundo a Arena, é 70% menor. O custo mediano por tarefa é de US$ 1,23, 29% abaixo do Kimi K3. A Arena também informa que o modelo está em #7 em Brand & Marketing e em #9 em Simulations, e diz que, com pesos abertos, ele seria o principal modelo aberto em WebDev, à frente do DeepSeek V4.1 Flash.
Artificial Analysis Cyber Index (publicado mais tarde no mesmo dia): o Kimi K3.1 Pro marca 64%, 23 pontos acima do Kimi K3 (41%). A Artificial Analysis diz que isso o torna o principal modelo disponível abertamente e o segundo no geral, atrás apenas do GPT-6 Sol (Daybreak Blue, max), da OpenAI, com acesso confiável, que marca 69%, e à frente do DeepSeek V4.1 Flash 1017 (57%). O modelo registra a maior pontuação no CyberGym-E2E-AA entre todos os testados pela organização (95%), 37% no DeepsecBench-AA e 61% no CWE-Bench-AA (o DeepSeek V4.1 Flash 1017 lidera nesse teste, com 69%), e não apresenta recusas de segurança. O custo por tarefa é de US$ 2,81, 15% acima do Kimi K3, porque usa cerca do dobro de tokens de entrada.
Extended NYT Connections (benchmark independente de Lech Mazur, publicado mais tarde no mesmo dia): o Kimi K3.1 Pro (high) marca 93,4, ligeiramente abaixo dos 93,6 do Kimi K3, usando menos tokens de raciocínio. Mazur também testou GPT-6 Astra (max) e GPT-6.1 Sol (max); Gemini 4 Argon (high) continua em primeiro lugar.
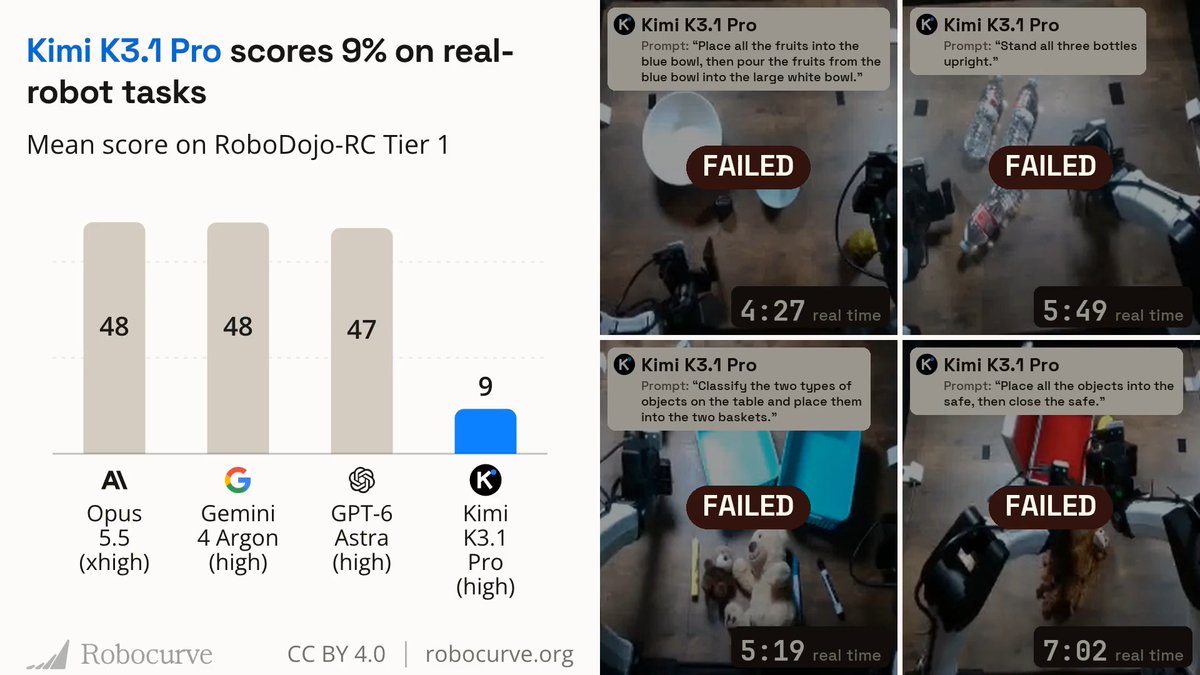
Tarefas com robôs reais da Robocurve (publicadas naquela noite, no horário do Pacífico): a Robocurve, organização que avalia IA física, diz que o Kimi K3.1 Pro marca 9% em suas tarefas com robôs reais, atrás de Claude Opus 5.5, Gemini 4 Argon e GPT-6 Astra.
Agent Arena (publicado em 24 de outubro pela Arena): o Kimi K3.1 Pro (Max) entra no Agent Arena em #11, com uma melhora líquida de 7,6% em mais de 4.000 sessões agênticas do mundo real realizadas por usuários da Arena. A Arena diz que isso o tornaria o principal modelo aberto no Agent Arena, à frente do DeepSeek V4.1 Flash.
VulnPR-100 (publicado em 24 de outubro por um usuário que executou o benchmark da BugBunny): ao receber 100 pull requests com vulnerabilidades conhecidas e uma hora por PR, o Kimi K3.1 Pro encontrou 47 por US$ 124,69, 10 a mais que o Kimi K3, por US$ 20,54 a menos. Uma publicação compartilhada acrescenta que o DeepSeek V4.1 Flash 1017 encontrou 54 por US$ 7,53.
Mazebench (publicado em 24 de outubro por seu autor): o Kimi K3.1 Pro marca 2%, resultado que a publicação descreve como a primeira pontuação não trivial de um modelo de pesos abertos; o DeepSeek V4.1 Flash marca 1%.
Design Creativity Bench (publicado em 24 de outubro por seu mantenedor): a pontuação geral de criatividade do Kimi K3.1 Pro sobe de 40,4 para 45,8 em comparação com o Kimi K3. A pontuação de adequação sobe de 96,8% para 98,5%, resultado que, segundo a publicação do benchmark, supera a de todos os outros modelos de pesos abertos avaliados e empata com Claude Fable 5.1. O modelo gera designs quase duas vezes mais rápido que o Kimi K3, e o custo mediano por design cai 18%, de US$ 0,570 para US$ 0,466.
Classificação do site DesignArena Website (publicada em 24 de outubro pela DesignArena): a projeção coloca o Kimi K3.1 Pro em #1 entre os modelos de pesos abertos e empatado em #3 no geral, atrás apenas de Muse Wonder (max) e Muse Spark 1.3 (xhigh), e empatado com Muse Spark 1.3 Max. A DesignArena diz que ele supera o Kimi K3 por 15 pontos Elo na classificação de modelos de pesos abertos.
LLM Creative Story-Writing Benchmark (publicado em 24 de outubro por Lech Mazur): o Kimi K3.1 Pro (high) marca 2,72, acima dos 2,35 do Kimi K3. Em 50 prompts equivalentes, registra 35 vitórias, 8 empates e 7 derrotas contra o Kimi K3. Mazur diz que o principal avanço está na construção do enredo: os elementos exigidos passam a influenciar de maneira mais consistente as decisões dos personagens e suas consequências. O modelo também usa 34% menos tokens de raciocínio.
Fontes
- Grande novidade: @Kimi_Moonshot voltou ao top 4 de laboratórios no Code Arena: WebDev com o lançamento do Kimi K3.1 Pro!X · 3 comentários
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 comentários
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 comentário
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 comentários
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 comentários
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 comentário
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 comentários
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 comentários
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 comentários
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 comentários
Discussões
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 comentários
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 comentários
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 comentários
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 comentários
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 comentários
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 comentários
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 comentários
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 comentários
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 comentários
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 comentários
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 comentários
Receba notícias como esta por push.
O AI Tracker avisa você quando algo muda nas ferramentas que você usa.