 AI Tracker
Artificial AnalysisとArenaのランキングでKimi K3.1 Proが4位、Code Arena WebDevで8位に
MoonshotのKimi K3.1 Proのローンチから1時間以内に、独立した2つの評価機関が結果を公開した。両者とも価格を入力トークン100万個あたり$2、出力トークン100万個あたり$10としている。Artificial Analysisによると、キャッシュ済み入力は$0.20で、Kimi K3より33%安い。
Artificial Analysisによると、同モデルのIntelligence Indexスコアは55で、Kimi K3(44)を11ポイント上回り、全体で4位。上位はClaude Opus 5.5(58)、Claude Sonnet 5.5(56)、Muse Wonder Full(56)。その他の数値は以下のとおり。
- GDPval-AAで3位。Eloは1,846で、Kimi K3から312上昇。
- 同社がテストしたモデルの中で、Terminal-Bench 4.0のスコアが最高の67%(Kimi K3:13%、Claude Sonnet 5.5:64%)。
- AutomationBench-AAは58%から73%に上昇。Humanity's Last Exam(47%から52%)、CritPt(23%から25%)、SciCode(59%から61%)の伸びは小幅。
- AA-Omniscienceでのハルシネーション率は53%から44%に低下。
- タスクあたりのコストは約$1.98で、Kimi K3とほぼ同水準。出力トークンを14%多く使うため。
- 重みが公開されれば、Artificial Analysisは最高スコアのオープンウェイトモデルになると述べている。プロプライエタリモデルとの差は12ポイントから3ポイントに縮まる。
Arenaによると、Code Arena: WebDevで1,692ポイントを獲得し、8位。Kimi K3から順位は9つ、スコアは37ポイント上昇し、同社が「コストが70%低い」とする条件でClaude Opus 5 (Max)と並んだ。タスクあたりのコスト中央値は$1.23で、Kimi K3より29%安い。ArenaはBrand & Marketingで7位、Simulationsで9位とも報告し、オープンウェイトであればWebDevのオープンモデル首位となり、DeepSeek V4.1 Flashを上回るとしている。
Artificial Analysis Cyber Index(同日後半に投稿):Kimi K3.1 Proのスコアは64%で、Kimi K3(41%)から23ポイント上昇。Artificial Analysisによると、これにより公開モデルの首位、全体では2位となり、OpenAIの信頼済みアクセス限定GPT-6 Sol(Daybreak Blue, max)の69%に次ぎ、DeepSeek V4.1 Flash 1017(57%)を上回る。同社がテストしたモデルの中でCyberGym-E2E-AAのスコアが最高(95%)。DeepsecBench-AAは37%、CWE-Bench-AAは61%(同項目ではDeepSeek V4.1 Flash 1017が69%で首位)で、安全性を理由とした拒否はなかった。タスクあたりのコストは$2.81で、Kimi K3より15%高い。入力トークンを約2倍使うため。
Extended NYT Connections(Lech Mazurによる独立ベンチマーク、同日後半に投稿):Kimi K3.1 Pro (high)のスコアは93.4で、Kimi K3の93.6をわずかに下回った一方、推論トークンは少なかった。MazurはGPT-6 Astra (max)とGPT-6.1 Sol (max)もテスト。Gemini 4 Argon (high)は引き続き首位。
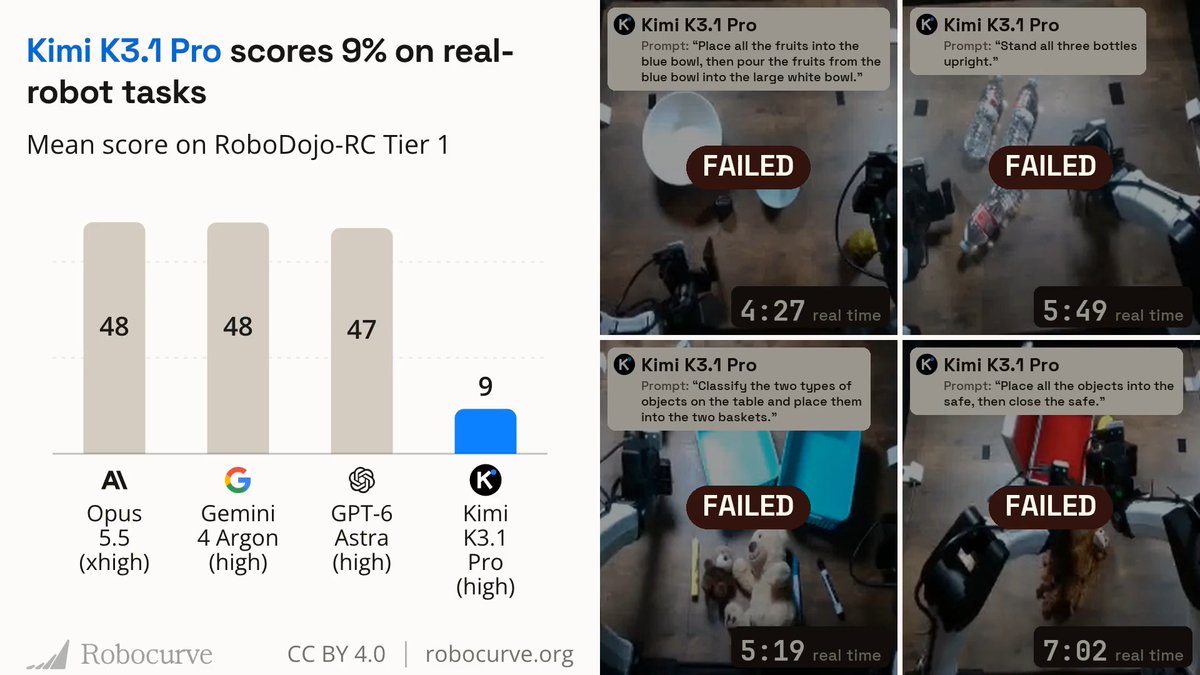
Robocurve real-robot tasks(太平洋時間の同日夜に投稿):物理AIのベンチマークを行うRobocurveによると、Kimi K3.1 Proの実ロボットタスクのスコアは9%で、Claude Opus 5.5、Gemini 4 Argon、GPT-6 Astraを下回った。
Agent Arena(10月24日にArenaが投稿):Kimi K3.1 Pro (Max)はAgent Arenaで11位に入り、Arenaユーザーによる4,000件超の実世界のエージェントセッションで、純改善率は7.6%だった。Arenaによると、これによりAgent Arenaのオープンモデル首位となり、DeepSeek V4.1 Flashを上回る。
VulnPR-100(10月24日、BugBunnyのベンチマークを実行したユーザーが投稿):既知の脆弱性があるプルリクエスト100件を与え、各PRにつき1時間を使ったところ、Kimi K3.1 Proは$124.69で47件を発見。Kimi K3より10件多く、費用は$20.54安かった。引用された投稿では、DeepSeek V4.1 Flash 1017は$7.53で54件を発見したと付け加えている。
Mazebench(10月24日に作成者が投稿):Kimi K3.1 Proのスコアは2%。投稿では、オープンウェイトモデルとして初の意味のあるスコアとしている。DeepSeek V4.1 Flashは1%。
Design Creativity Bench(10月24日に管理者が投稿):Kimi K3.1 Proの総合創造性スコアは、Kimi K3の40.4から45.8に上昇。適切性スコアは96.8%から98.5%に上昇し、ベンチマークの投稿によると、評価済みの他のすべてのオープンウェイトモデルを上回り、Claude Fable 5.1と同水準。デザイン生成はKimi K3のほぼ2倍の速さで、デザインあたりのコスト中央値は18%下がり、$0.570から$0.466となった。
DesignArena Website leaderboard(10月24日にDesignArenaが投稿):Kimi K3.1 Proはオープンウェイトモデルで1位、全体で同率3位となる見込み。上位はMuse Wonder (max)とMuse Spark 1.3 (xhigh)のみで、Muse Spark 1.3 Maxと同水準。DesignArenaによると、オープンウェイトのリーダーボードではKimi K3を15 Eloポイント上回る。
LLM Creative Story-Writing Benchmark(10月24日にLech Mazurが投稿):Kimi K3.1 Pro (high)のスコアは2.72で、Kimi K3の2.35から上昇。条件をそろえた50件のプロンプトでは、Kimi K3に対して35勝8分け7敗。Mazurによると、主な改善点は筋書きの構成で、必要な要素が登場人物の決断やその結果に、より一貫して反映されるようになった。また、推論トークンを34%少なく使うという。
ソース
- 大ニュース:@Kimi_MoonshotがKimi K3.1 Proのリリースにより、Code Arena: WebDevでトップ4ラボに返り咲き!X · 3 件のコメント
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 件のコメント
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 件のコメント
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 件のコメント
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 件のコメント
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 件のコメント
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 件のコメント
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 件のコメント
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 件のコメント
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 件のコメント
ディスカッション
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 件のコメント
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 件のコメント
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 件のコメント
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 件のコメント
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 件のコメント
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 件のコメント
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 件のコメント
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 件のコメント
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 件のコメント
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 件のコメント
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 件のコメント
こんなニュースをプッシュで。
使っているツールに変化があると、AI Tracker がお知らせします。