 AI Tracker
Artificial Analysis und Arena führen Kimi K3.1 Pro auf ihren Indizes auf Platz 4 und in Code Arena WebDev auf Platz 8
Zwei unabhängige Evaluatoren veröffentlichten innerhalb einer Stunde nach dem Start Ergebnisse zu Moonshots Kimi K3.1 Pro. Beide geben den Preis mit 2 $ pro Million Input-Tokens und 10 $ pro Million Output-Tokens an; Artificial Analysis setzt den Preis für gecachte Inputs auf 0,20 $, 33 % weniger als bei Kimi K3.
Artificial Analysis zufolge erzielt das Modell 55 Punkte im Intelligence Index, 11 Punkte mehr als Kimi K3 (44) und insgesamt Platz 4, hinter Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) und Muse Wonder Full (56). Weitere Werte:
- Auf GDPval-AA liegt es mit 1.846 Elo auf Platz 3, 312 Punkte mehr als Kimi K3.
- Es erzielt mit 67 % den höchsten Terminal-Bench-4.0-Wert aller von Artificial Analysis getesteten Modelle (Kimi K3: 13 %; Claude Sonnet 5.5: 64 %).
- AutomationBench-AA steigt von 58 % auf 73 %. Die Zuwächse bei Humanity's Last Exam (47 % auf 52 %), CritPt (23 % auf 25 %) und SciCode (59 % auf 61 %) sind geringer.
- Die Halluzinationsrate bei AA-Omniscience sinkt von 53 % auf 44 %.
- Die Kosten pro Aufgabe liegen bei etwa 1,98 $, ungefähr auf dem Niveau von Kimi K3, da das Modell 14 % mehr Output-Tokens verwendet.
- Sobald die Gewichte veröffentlicht sind, wäre es laut Artificial Analysis das Open-Weights-Modell mit der höchsten Punktzahl. Damit würde sich der Abstand zu proprietären Modellen von 12 auf 3 Punkte verringern.
Arena zufolge liegt das Modell in Code Arena: WebDev mit 1.692 Punkten auf Platz 8, neun Plätze und 37 Punkte vor Kimi K3. Damit ist es auf dem Niveau von Claude Opus 5 (Max) – zu laut Arena 70 % geringeren Kosten. Die medianen Kosten pro Aufgabe betragen 1,23 $, 29 % weniger als bei Kimi K3. Arena meldet außerdem Platz 7 in Brand & Marketing und Platz 9 in Simulations. Mit offenen Gewichten wäre es demnach in WebDev das führende offene Modell, vor DeepSeek V4.1 Flash.
Artificial Analysis Cyber Index (später am Tag veröffentlicht): Kimi K3.1 Pro erzielt 64 %, 23 Punkte mehr als Kimi K3 (41 %). Laut Artificial Analysis ist es damit das führende öffentlich verfügbare Modell und insgesamt auf Platz 2, hinter OpenAIs GPT-6 Sol (Daybreak Blue, max) mit vertrauenswürdigem Zugriff, das 69 % erreicht, und vor DeepSeek V4.1 Flash 1017 (57 %). Das Modell erzielt mit 95 % den höchsten CyberGym-E2E-AA-Wert aller von Artificial Analysis getesteten Modelle, erreicht 37 % bei DeepsecBench-AA und 61 % bei CWE-Bench-AA (dort liegt DeepSeek V4.1 Flash 1017 mit 69 % vorn) und verweigert aus Sicherheitsgründen keine Anfragen. Die Kosten pro Aufgabe betragen 2,81 $, 15 % mehr als bei Kimi K3, da es etwa doppelt so viele Input-Tokens verwendet.
Extended NYT Connections (Lech Mazurs unabhängiger Benchmark, später am Tag veröffentlicht): Kimi K3.1 Pro (high) erzielt 93,4 Punkte und liegt damit knapp unter Kimi K3 mit 93,6, verwendet jedoch weniger Reasoning-Tokens. Mazur testete auch GPT-6 Astra (max) und GPT-6.1 Sol (max); Gemini 4 Argon (high) bleibt auf Platz 1.
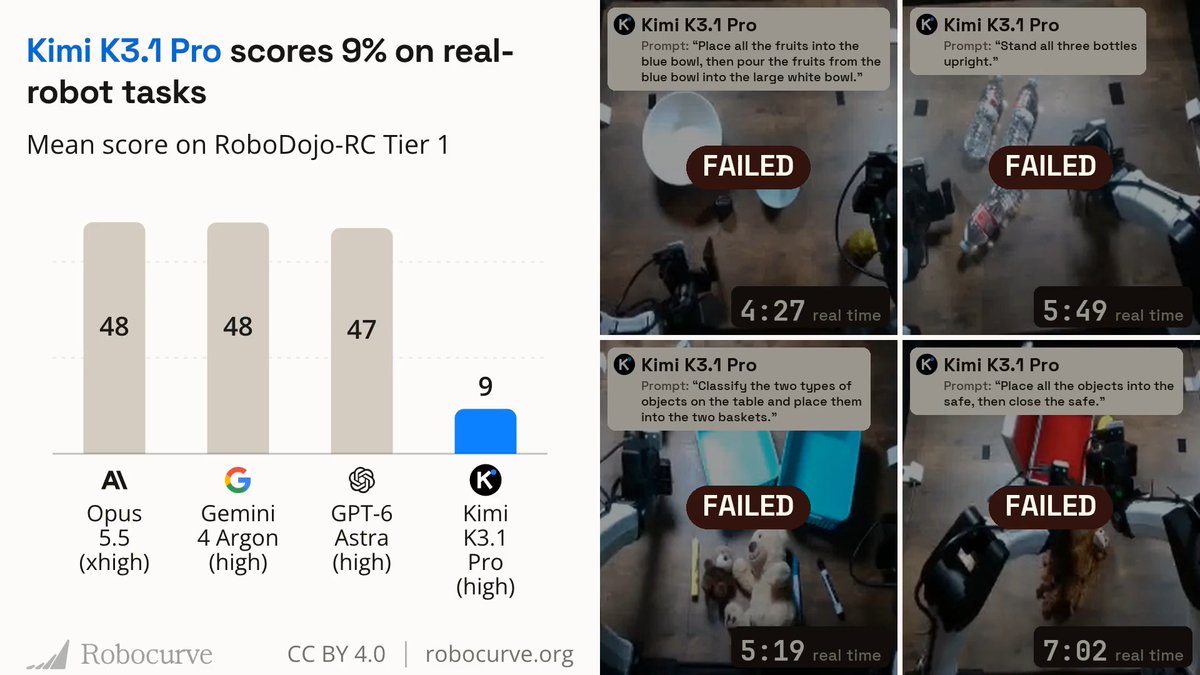
Robocurve-Aufgaben mit echten Robotern (am Abend pazifischer Zeit veröffentlicht): Robocurve, eine Organisation für Physical-AI-Benchmarking, zufolge erzielt Kimi K3.1 Pro bei ihren Aufgaben mit echten Robotern 9 % und liegt damit hinter Claude Opus 5.5, Gemini 4 Argon und GPT-6 Astra.
Agent Arena (am 24. Oktober von Arena veröffentlicht): Kimi K3.1 Pro (Max) steigt in der Agent Arena auf Platz 11 ein. Über mehr als 4.000 reale agentische Sitzungen von Arena-Nutzern hinweg verbessert sich das Ergebnis netto um 7,6 %. Arena zufolge wäre es damit das führende offene Modell in der Agent Arena, vor DeepSeek V4.1 Flash.
VulnPR-100 (am 24. Oktober von einem Nutzer veröffentlicht, der BugBunnys Benchmark ausführt): Bei 100 Pull Requests mit bekannten Sicherheitslücken und einer Stunde pro PR fand Kimi K3.1 Pro 47 Lücken für 124,69 $ – 10 mehr als Kimi K3, bei 20,54 $ geringeren Kosten. Ein weiterverbreiteter Beitrag ergänzt, dass DeepSeek V4.1 Flash 1017 für 7,53 $ 54 Lücken fand.
Mazebench (am 24. Oktober vom Autor veröffentlicht): Kimi K3.1 Pro erzielt 2 %. Der Beitrag bezeichnet dies als ersten nichttrivialen Wert für ein Open-Weights-Modell; DeepSeek V4.1 Flash erzielt 1 %.
Design Creativity Bench (am 24. Oktober vom Maintainer veröffentlicht): Kimi K3.1 Pros Gesamtwert für Kreativität steigt gegenüber Kimi K3 von 40,4 auf 45,8. Der Wert für Angemessenheit steigt von 96,8 % auf 98,5 %. Laut Benchmark-Beitrag liegt das Modell damit vor allen anderen getesteten Open-Weight-Modellen und gleichauf mit Claude Fable 5.1. Es erstellt Designs fast doppelt so schnell wie Kimi K3, und die medianen Kosten pro Design sinken um 18 %, von 0,570 $ auf 0,466 $.
DesignArena-Website-Rangliste (am 24. Oktober von DesignArena veröffentlicht): Kimi K3.1 Pro wird voraussichtlich Platz 1 unter den Open-Weights-Modellen belegen und insgesamt punktgleich auf Platz 3 liegen – hinter Muse Wonder (max) und Muse Spark 1.3 (xhigh) und gleichauf mit Muse Spark 1.3 Max. DesignArena zufolge liegt es in der Open-Weights-Rangliste 15 Elo-Punkte vor Kimi K3.
LLM Creative Story-Writing Benchmark (am 24. Oktober von Lech Mazur veröffentlicht): Kimi K3.1 Pro (high) erzielt 2,72 Punkte, gegenüber 2,35 bei Kimi K3. In 50 paarweise verglichenen Prompts verzeichnet es gegenüber Kimi K3 35 Siege, 8 Unentschieden und 7 Niederlagen. Mazur zufolge liegt der Hauptgewinn im stärkeren Plotting: Vorgegebene Elemente beeinflussen die Entscheidungen der Figuren und deren Folgen konsistenter. Außerdem verwendet das Modell 34 % weniger Reasoning-Tokens.
Quellen
- Große Neuigkeiten: @Kimi_Moonshot ist mit der Veröffentlichung von Kimi K3.1 Pro in Code Arena: WebDev zurück unter den Top 4 Labs!X · 3 Kommentare
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 Kommentare
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 Kommentare
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 Kommentare
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 Kommentare
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 Kommentare
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 Kommentare
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 Kommentare
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 Kommentare
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 Kommentare
Diskussionen
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 Kommentare
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 Kommentare
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 Kommentare
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 Kommentare
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 Kommentare
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 Kommentare
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 Kommentare
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 Kommentare
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 Kommentare
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 Kommentare
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 Kommentare
News wie diese als Push.
AI Tracker benachrichtigt dich, wenn sich bei deinen Tools etwas ändert.