 AI Tracker
Artificial Analysis ve Arena, Kimi K3.1 Pro'yu kendi endekslerinde 4., Code Arena WebDev'de ise 8. sıraya yerleştirdi
İki bağımsız değerlendirici, Moonshot'ın Kimi K3.1 Pro modeli için lansmanından sonraki bir saat içinde sonuçlarını yayımladı. İkisi de fiyatı milyon girdi tokenı başına 2 dolar, milyon çıktı tokenı başına 10 dolar olarak belirledi; Artificial Analysis, önbelleğe alınmış girdinin 0,20 dolar olduğunu ve bunun Kimi K3'ten %33 daha düşük olduğunu belirtiyor.
Artificial Analysis, modelin Intelligence Index'te 55 puan aldığını, bunun Kimi K3'ün 44 puanından 11 puan yüksek olduğunu ve modelin genel sıralamada 4. olduğunu söylüyor. Modelin önünde Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) ve Muse Wonder Full (56) yer alıyor. Diğer sonuçları:
- 1.846 Elo ile GDPval-AA'de 3. sırada; Kimi K3'e göre 312 puan artış.
- Test ettiği modeller arasında en yüksek Terminal-Bench 4.0 puanı onda: %67 (Kimi K3: %13; Claude Sonnet 5.5: %64).
- AutomationBench-AA %58'den %73'e yükseliyor. Humanity's Last Exam'deki (%47'den %52'ye), CritPt'deki (%23'ten %25'e) ve SciCode'daki (%59'dan %61'e) artışlar daha küçük.
- AA-Omniscience'daki halüsinasyon oranı %53'ten %44'e düşüyor.
- Görev başına maliyet yaklaşık 1,98 dolar; Kimi K3 ile hemen hemen aynı, çünkü %14 daha fazla çıktı tokenı kullanıyor.
- Ağırlıklar yayımlandığında Artificial Analysis'e göre en yüksek puanlı açık ağırlıklı model olacak ve tescilli modellerle arasındaki fark 12 puandan 3 puana inecek.
Arena, modelin Code Arena: WebDev'de 1.692 puanla 8. sırada olduğunu, Kimi K3'e göre 9 sıra ve 37 puan yükseldiğini ve Arena'nın ifadesiyle %70 daha düşük maliyetle Claude Opus 5 (Max) ile aynı seviyede olduğunu söylüyor. Görev başına medyan maliyet 1,23 dolar; Kimi K3'ten %29 daha düşük. Arena ayrıca Brand & Marketing'de 7., Simulations'ta 9. sırada olduğunu bildiriyor ve açık ağırlıklarla WebDev'de DeepSeek V4.1 Flash'ı geride bırakarak en iyi açık model olacağını söylüyor.
Artificial Analysis Cyber Index (günün ilerleyen saatlerinde yayımlandı): Kimi K3.1 Pro %64 puan alıyor; bu, Kimi K3'e (%41) göre 23 puanlık artış. Artificial Analysis, bunun onu erişime açık modeller arasında ilk, genel sıralamada ise yalnızca OpenAI'ın güvenilir erişimli GPT-6 Sol (Daybreak Blue, max) modelinin (%69) ardından ikinci sıraya taşıdığını ve DeepSeek V4.1 Flash 1017'yi (%57) geride bıraktığını söylüyor. Test ettiği modeller arasında en yüksek CyberGym-E2E-AA puanını (%95) aldığını, DeepsecBench-AA'de %37 ve CWE-Bench-AA'de %61 puan aldığını (burada DeepSeek V4.1 Flash 1017 %69 ile önde) ve güvenlik nedeniyle hiç yanıtı reddetmediğini bildiriyor. Görev başına maliyet 2,81 dolar; yaklaşık iki kat fazla girdi tokenı kullandığı için Kimi K3'ten %15 daha yüksek.
Extended NYT Connections (Lech Mazur'un bağımsız kıyaslaması, günün ilerleyen saatlerinde yayımlandı): Kimi K3.1 Pro (high) 93,4 puan alıyor; bu, daha az akıl yürütme tokenı kullanmasına karşın Kimi K3'ün 93,6 puanının biraz altında. Mazur ayrıca GPT-6 Astra'yı (max) ve GPT-6.1 Sol'u (max) test etti; Gemini 4 Argon (high) birinciliğini koruyor.
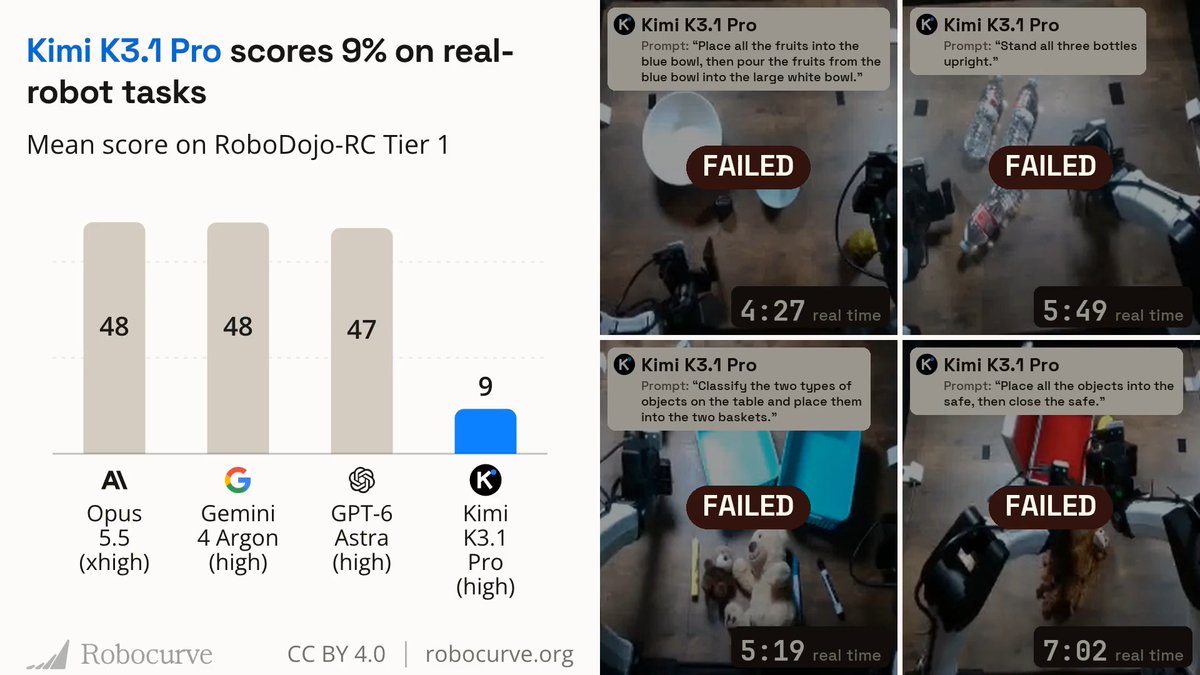
Robocurve gerçek robot görevleri (o akşam, Pasifik saatine göre yayımlandı): Fiziksel yapay zekâ kıyaslamaları yapan Robocurve, Kimi K3.1 Pro'nun gerçek robot görevlerinde %9 puan aldığını ve Claude Opus 5.5, Gemini 4 Argon ve GPT-6 Astra'nın gerisinde kaldığını söylüyor.
Agent Arena (24 Ekim'de Arena tarafından yayımlandı): Kimi K3.1 Pro (Max), Arena kullanıcılarının 4.000'den fazla gerçek dünya ajan oturumunda %7,6 net iyileşmeyle Agent Arena'ya 11. sıradan giriyor. Arena, bunun modeli DeepSeek V4.1 Flash'ın önünde, Agent Arena'daki en iyi açık model yapacağını söylüyor.
VulnPR-100 (24 Ekim'de BugBunny'nin kıyaslamasını çalıştıran bir kullanıcı tarafından yayımlandı): Bilinen güvenlik açıklarına sahip 100 pull request verildiğinde ve her PR için bir saat tanındığında Kimi K3.1 Pro, 124,69 dolar karşılığında 47 açık buldu; bu, Kimi K3'ten 10 fazla ve 20,54 dolar daha ucuz. Başka bir gönderide aktarılan bilgiye göre DeepSeek V4.1 Flash 1017, 7,53 dolara 54 açık buldu.
Mazebench (24 Ekim'de yazarı tarafından yayımlandı): Kimi K3.1 Pro %2 puan alıyor; gönderide bu, açık ağırlıklı bir model için kaydedilen ilk kayda değer puan olarak nitelendiriliyor. DeepSeek V4.1 Flash %1 puan alıyor.
Design Creativity Bench (24 Ekim'de yöneticisi tarafından yayımlandı): Kimi K3.1 Pro'nun genel yaratıcılık puanı, Kimi K3'e kıyasla 40,4'ten 45,8'e yükseliyor. Uygunluk puanı %96,8'den %98,5'e çıkıyor; kıyaslama gönderisine göre bu, değerlendirdiği diğer tüm açık ağırlıklı modellerin üzerinde ve Claude Fable 5.1 ile aynı seviyede. Neredeyse iki kat daha hızlı tasarım üretiyor ve tasarım başına medyan maliyet %18 düşerek 0,570 dolardan 0,466 dolara iniyor.
DesignArena Website liderlik tablosu (24 Ekim'de DesignArena tarafından yayımlandı): Kimi K3.1 Pro'nun açık ağırlıklı modeller arasında 1., genel sıralamada ise Muse Wonder (max) ve Muse Spark 1.3'ün (xhigh) ardından Muse Spark 1.3 Max ile birlikte 3. sırada yer alması bekleniyor. DesignArena, modelin açık ağırlıklı modeller liderlik tablosunda Kimi K3'ü 15 Elo puanla geçtiğini söylüyor.
LLM Creative Story-Writing Benchmark (24 Ekim'de Lech Mazur tarafından yayımlandı): Kimi K3.1 Pro (high) 2,72 puan alıyor; Kimi K3 ise 2,35 puandaydı. Eşleştirilmiş 50 istemde Kimi K3'e karşı 35 galibiyet, 8 beraberlik ve 7 mağlubiyet alıyor. Mazur, başlıca kazanımın daha güçlü olay örgüsü kurma olduğunu; gerekli unsurların karakterlerin kararlarını ve bu kararların sonuçlarını daha tutarlı biçimde şekillendirdiğini ve modelin %34 daha az akıl yürütme tokenı kullandığını söylüyor.
Kaynaklar
- Büyük haber: @Kimi_Moonshot, Kimi K3.1 Pro'nun piyasaya sürülmesiyle Code Arena: WebDev'de yeniden ilk 4 laboratuvar arasına girdi!X · 3 yorum
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 yorum
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 yorum
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 yorum
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 yorum
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 yorum
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 yorum
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 yorum
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 yorum
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 yorum
Tartışmalar
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 yorum
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 yorum
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 yorum
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 yorum
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 yorum
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 yorum
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 yorum
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 yorum
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 yorum
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 yorum
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 yorum
Bu tür haberleri bildirim olarak alın.
Kullandığınız araçlarda bir şey değiştiğinde AI Tracker sizi uyarır.