 AI Tracker
Artificial Analysis en Arena plaatsen Kimi K3.1 Pro op hun indexen op de 4e plaats en op #8 in Code Arena WebDev
Twee onafhankelijke evaluatoren publiceerden binnen een uur na de lancering resultaten voor Moonshots Kimi K3.1 Pro. Beide noemen een prijs van $2 per miljoen inputtokens en $10 per miljoen outputtokens; Artificial Analysis vermeldt $0.20 voor gecachete input, 33% minder dan bij Kimi K3.
Artificial Analysis zegt dat het model 55 punten scoort op de Intelligence Index, 11 punten meer dan Kimi K3 (44) en goed voor de 4e plaats overall, achter Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) en Muse Wonder Full (56). De overige cijfers:
- Het staat op de 3e plaats op GDPval-AA met 1,846 Elo, 312 hoger dan Kimi K3.
- Het behaalt de hoogste score op Terminal-Bench 4.0 van alle modellen die het heeft getest: 67% (Kimi K3: 13%; Claude Sonnet 5.5: 64%).
- AutomationBench-AA stijgt van 58% naar 73%. De verbeteringen op Humanity's Last Exam (47% naar 52%), CritPt (23% naar 25%) en SciCode (59% naar 61%) zijn kleiner.
- Het hallucinatiepercentage op AA-Omniscience daalt van 53% naar 44%.
- De kosten per taak bedragen ongeveer $1.98, ongeveer gelijk aan die van Kimi K3, omdat het 14% meer outputtokens gebruikt.
- Zodra de weights zijn gepubliceerd, zou het volgens Artificial Analysis het open-weightsmodel met de hoogste score zijn, waarmee de achterstand op propriëtaire modellen krimpt van 12 naar 3 punten.
Arena zegt dat het model op #8 staat in Code Arena: WebDev met 1692 punten, 9 plaatsen en 37 punten hoger dan Kimi K3. Daarmee evenaart het Claude Opus 5 (Max), tegen wat Arena 70% lagere kosten noemt. De mediane kosten per taak bedragen $1.23, 29% minder dan bij Kimi K3. Arena meldt ook #7 in Brand & Marketing en #9 in Simulations, en zegt dat het met open weights het beste open model in WebDev zou zijn, vóór DeepSeek V4.1 Flash.
Artificial Analysis Cyber Index (later die dag gepubliceerd): Kimi K3.1 Pro scoort 64%, 23 punten hoger dan Kimi K3 (41%). Volgens Artificial Analysis maakt dat het model het best scorende vrij beschikbare model en tweede overall, alleen achter OpenAI's GPT-6 Sol (Daybreak Blue, max) met vertrouwde toegang, op 69%, en vóór DeepSeek V4.1 Flash 1017 (57%). Het meldt de hoogste score op CyberGym-E2E-AA van alle geteste modellen (95%), 37% op DeepsecBench-AA en 61% op CWE-Bench-AA (waar DeepSeek V4.1 Flash 1017 vooroploopt met 69%), en geen veiligheidsweigeringen. De kosten per taak bedragen $2.81, 15% meer dan bij Kimi K3, omdat het ongeveer twee keer zoveel inputtokens gebruikt.
Extended NYT Connections (de onafhankelijke benchmark van Lech Mazur, later die dag gepubliceerd): Kimi K3.1 Pro (high) scoort 93.4, net onder Kimi K3 met 93.6, terwijl het minder redeneertokens gebruikt. Mazur testte ook GPT-6 Astra (max) en GPT-6.1 Sol (max); Gemini 4 Argon (high) blijft op de eerste plaats.
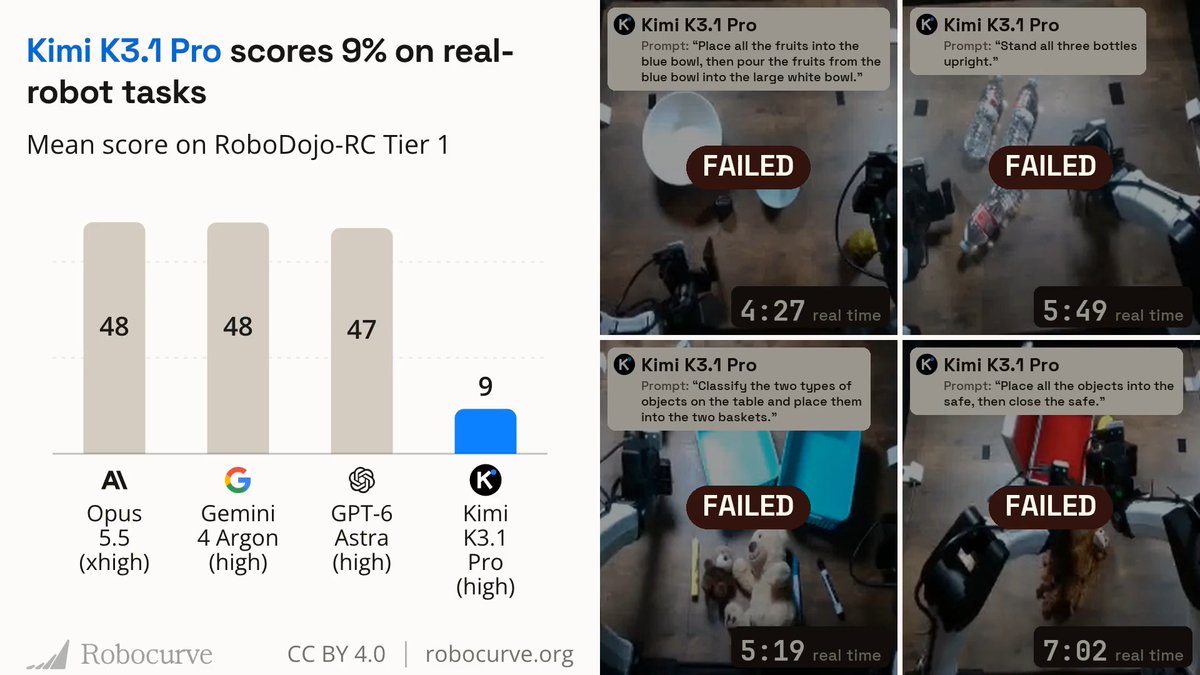
Robocurve-taken met echte robots (die avond gepubliceerd, Pacific Time): Robocurve, een organisatie die fysieke AI benchmarkt, zegt dat Kimi K3.1 Pro 9% scoort op zijn taken met echte robots, achter Claude Opus 5.5, Gemini 4 Argon en GPT-6 Astra.
Agent Arena (op 24 oktober gepubliceerd door Arena): Kimi K3.1 Pro (Max) komt binnen op #11 in Agent Arena, met een nettoverbetering van 7.6% over meer dan 4,000 praktijksessies met agents van Arena-gebruikers. Volgens Arena zou het daarmee het beste open model in Agent Arena zijn, vóór DeepSeek V4.1 Flash.
VulnPR-100 (op 24 oktober gepubliceerd door een gebruiker die BugBunny's benchmark uitvoerde): met 100 pull requests met bekende kwetsbaarheden en één uur per PR vond Kimi K3.1 Pro er 47 voor $124.69, 10 meer dan Kimi K3 en voor $20.54 minder. Een doorgegeven bericht voegt eraan toe dat DeepSeek V4.1 Flash 1017 er 54 vond voor $7.53.
Mazebench (op 24 oktober gepubliceerd door de maker): Kimi K3.1 Pro scoort 2%, wat het bericht de eerste niet-triviale score voor een open-weightsmodel noemt; DeepSeek V4.1 Flash scoort 1%.
Design Creativity Bench (op 24 oktober gepubliceerd door de beheerder): de totaalscore voor creativiteit van Kimi K3.1 Pro stijgt van 40.4 naar 45.8 ten opzichte van Kimi K3. De score voor gepastheid stijgt van 96.8% naar 98.5%; volgens het benchmarkbericht ligt die hoger dan die van elk ander geëvalueerd open-weightmodel en is die gelijk aan die van Claude Fable 5.1. Het genereert ontwerpen bijna twee keer zo snel als Kimi K3, en de mediane kosten per ontwerp dalen met 18%, van $0.570 naar $0.466.
DesignArena Website-leaderboard (op 24 oktober gepubliceerd door DesignArena): Kimi K3.1 Pro zal naar verwachting op #1 staan onder open-weightsmodellen en gedeeld op de 3e plaats overall, alleen achter Muse Wonder (max) en Muse Spark 1.3 (xhigh), en gelijk aan Muse Spark 1.3 Max. Volgens DesignArena staat het 15 Elo-punten voor op Kimi K3 op het leaderboard voor open-weightsmodellen.
LLM Creative Story-Writing Benchmark (op 24 oktober gepubliceerd door Lech Mazur): Kimi K3.1 Pro (high) scoort 2.72, tegenover 2.35 voor Kimi K3. Bij 50 vergelijkbare prompts behaalt het 35 overwinningen, 8 gelijke spelen en 7 nederlagen tegen Kimi K3. Mazur zegt dat de voornaamste verbetering zit in een sterkere plotopbouw: de verplichte elementen sturen de beslissingen van personages en de gevolgen daarvan consistenter, en het gebruikt 34% minder redeneertokens.
Bronnen
- Groot nieuws: @Kimi_Moonshot staat na de release van Kimi K3.1 Pro weer in de top 4 labs van Code Arena: WebDev!X · 3 reacties
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 reacties
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 reactie
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 reacties
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 reacties
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 reactie
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 reacties
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 reacties
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 reacties
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 reacties
Discussies
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 reacties
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 reacties
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 reacties
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 reacties
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 reacties
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 reacties
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 reacties
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 reacties
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 reacties
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 reacties
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 reacties
Krijg nieuws als dit als pushmelding.
AI Tracker waarschuwt je zodra er iets verandert aan de tools die je gebruikt.