 AI Tracker
Artificial Analysis और Arena की रैंकिंग में Kimi K3.1 Pro अपने इंडेक्स में चौथे और Code Arena WebDev में #8 पर
Moonshot के Kimi K3.1 Pro के लॉन्च के एक घंटे के भीतर दो स्वतंत्र मूल्यांकनकर्ताओं ने नतीजे प्रकाशित किए। दोनों ने इसकी कीमत 10 लाख इनपुट टोकन के लिए $2 और 10 लाख आउटपुट टोकन के लिए $10 बताई; Artificial Analysis के अनुसार कैश किए गए इनपुट की कीमत $0.20 है, जो Kimi K3 से 33% कम है।
Artificial Analysis के मुताबिक, मॉडल को अपने Intelligence Index पर 55 अंक मिले—Kimi K3 (44) से 11 अंक ज़्यादा और कुल मिलाकर चौथा स्थान। इससे आगे Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) और Muse Wonder Full (56) हैं। इसके अन्य आँकड़े:
- GDPval-AA में यह 1,846 Elo के साथ तीसरे स्थान पर है, जो Kimi K3 से 312 अधिक है।
- इसके Terminal-Bench 4.0 के अंक 67% हैं—जाँचे गए किसी भी मॉडल में सबसे ज़्यादा (Kimi K3: 13%; Claude Sonnet 5.5: 64%)।
- AutomationBench-AA का स्कोर 58% से बढ़कर 73% हो गया। Humanity's Last Exam (47% से 52%), CritPt (23% से 25%) और SciCode (59% से 61%) में बढ़त कम है।
- AA-Omniscience पर इसकी hallucination दर 53% से घटकर 44% हो गई।
- प्रति कार्य लागत लगभग $1.98 है, जो Kimi K3 के करीब है, क्योंकि यह 14% अधिक आउटपुट टोकन इस्तेमाल करता है।
- Artificial Analysis का कहना है कि वेट प्रकाशित होने पर यह सबसे अधिक स्कोर वाला open-weights मॉडल होगा और proprietary मॉडलों से इसका अंतर 12 से घटकर 3 अंक रह जाएगा।
Arena के मुताबिक, मॉडल Code Arena: WebDev में 1692 अंकों के साथ #8 पर है—Kimi K3 से 9 स्थान और 37 अंक ऊपर। Arena के अनुसार, यह Claude Opus 5 (Max) के बराबर प्रदर्शन करता है, जबकि इसकी लागत 70% कम है। प्रति कार्य इसकी औसत लागत $1.23 है, जो Kimi K3 से 29% कम है। Arena इसे Brand & Marketing में #7 और Simulations में #9 पर भी रखता है। उसका कहना है कि open weights के साथ यह WebDev में DeepSeek V4.1 Flash से आगे, शीर्ष open मॉडल होगा।
Artificial Analysis Cyber Index (दिन में बाद में पोस्ट किया गया): Kimi K3.1 Pro को 64% अंक मिले, जो Kimi K3 (41%) से 23 अंक अधिक हैं। Artificial Analysis का कहना है कि इससे यह खुले तौर पर उपलब्ध मॉडलों में शीर्ष पर और कुल मिलाकर दूसरे स्थान पर आता है। इससे आगे सिर्फ़ OpenAI का trusted-access GPT-6 Sol (Daybreak Blue, max) है, जिसे 69% मिले; यह DeepSeek V4.1 Flash 1017 (57%) से आगे है। रिपोर्ट में मॉडल को जाँचे गए सभी मॉडलों में सबसे ज़्यादा CyberGym-E2E-AA स्कोर (95%) मिला। DeepsecBench-AA पर इसके 37% और CWE-Bench-AA पर 61% हैं (इसमें DeepSeek V4.1 Flash 1017, 69% के साथ आगे है)। इसमें कोई safety refusals नहीं आए। प्रति कार्य लागत $2.81 है—Kimi K3 से 15% ज़्यादा—क्योंकि यह लगभग दोगुने इनपुट टोकन इस्तेमाल करता है।
Extended NYT Connections (Lech Mazur का स्वतंत्र benchmark, दिन में बाद में पोस्ट किया गया): Kimi K3.1 Pro (high) को 93.4 अंक मिले, जो Kimi K3 के 93.6 से थोड़ा कम हैं, जबकि इसने कम reasoning tokens इस्तेमाल किए। Mazur ने GPT-6 Astra (max) और GPT-6.1 Sol (max) का भी परीक्षण किया; Gemini 4 Argon (high) अब भी पहले स्थान पर है।
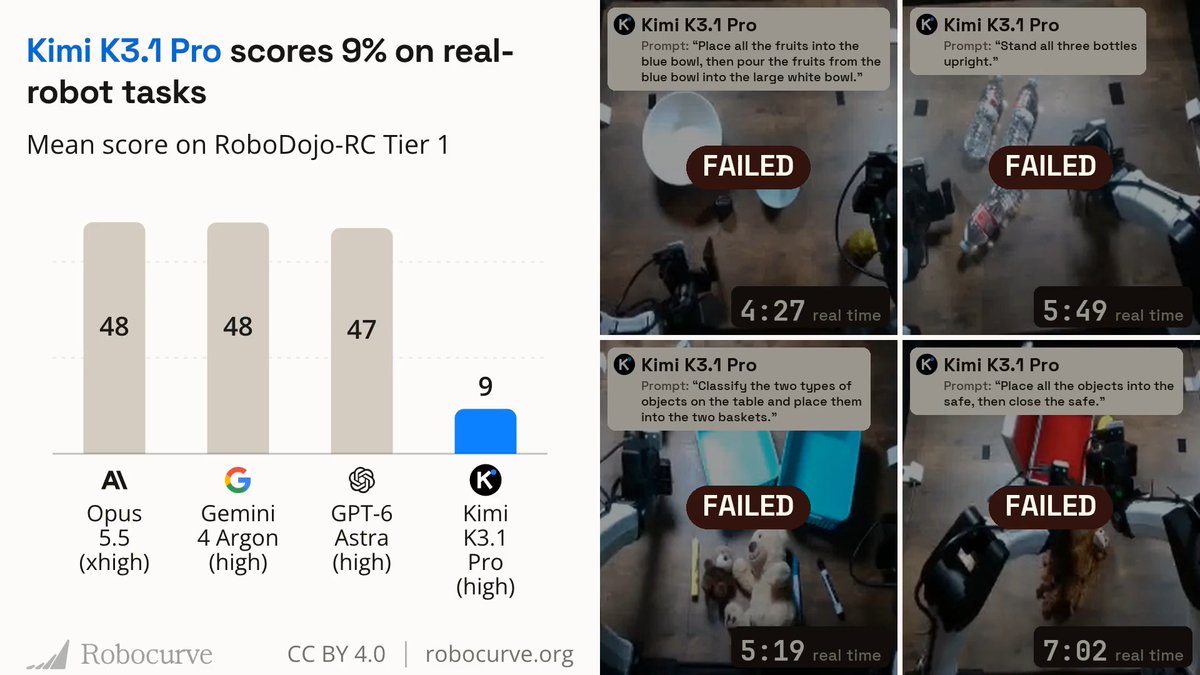
Robocurve के असली रोबोट वाले कार्य (उस शाम, Pacific समय के अनुसार, पोस्ट किए गए): भौतिक AI के मूल्यांकन के लिए काम करने वाले संगठन Robocurve का कहना है कि अपने वास्तविक रोबोट वाले कार्यों में Kimi K3.1 Pro को 9% अंक मिले, जो Claude Opus 5.5, Gemini 4 Argon और GPT-6 Astra से पीछे है।
Agent Arena (Arena द्वारा 24 अक्टूबर को पोस्ट किया गया): Kimi K3.1 Pro (Max) Agent Arena में #11 पर आया। Arena के उपयोगकर्ताओं के 4,000 से अधिक वास्तविक agentic सत्रों में इसके प्रदर्शन में कुल 7.6% सुधार हुआ। Arena का कहना है कि इससे यह DeepSeek V4.1 Flash से आगे, Agent Arena का शीर्ष open मॉडल बन जाएगा।
VulnPR-100 (BugBunny के benchmark को चलाने वाले एक उपयोगकर्ता ने 24 अक्टूबर को पोस्ट किया): ज्ञात कमजोरियों वाले 100 pull requests दिए जाने और हर PR के लिए एक घंटा मिलने पर, Kimi K3.1 Pro ने $124.69 की लागत में 47 कमजोरियाँ ढूँढीं—Kimi K3 से 10 ज़्यादा, और लागत $20.54 अधिक। साझा की गई एक पोस्ट में कहा गया कि DeepSeek V4.1 Flash 1017 ने $7.53 में 54 ढूँढीं।
Mazebench (इसके लेखक ने 24 अक्टूबर को पोस्ट किया): Kimi K3.1 Pro को 2% अंक मिले। पोस्ट ने इसे open-weights मॉडल का पहला उल्लेखनीय स्कोर बताया; DeepSeek V4.1 Flash को 1% मिला।
Design Creativity Bench (इसके मेंटेनर ने 24 अक्टूबर को पोस्ट किया): Kimi K3.1 की तुलना में Kimi K3.1 Pro का कुल creativity स्कोर 40.4 से बढ़कर 45.8 हुआ। इसका appropriateness स्कोर 96.8% से बढ़कर 98.5% हो गया। benchmark की पोस्ट के अनुसार, यह उसके द्वारा जाँचे गए अन्य सभी open-weight मॉडलों से आगे और Claude Fable 5.1 के बराबर है। यह Kimi K3 से लगभग दोगुनी तेज़ी से डिज़ाइन बनाता है और प्रति डिज़ाइन औसत लागत 18% घटकर $0.570 से $0.466 हो जाती है।
DesignArena Website leaderboard (DesignArena ने 24 अक्टूबर को पोस्ट किया): अनुमान है कि Kimi K3.1 Pro open-weights मॉडलों में #1 और कुल मिलाकर संयुक्त रूप से #3 पर रहेगा। इससे आगे सिर्फ़ Muse Wonder (max) और Muse Spark 1.3 (xhigh) हैं; इसका स्कोर Muse Spark 1.3 Max के बराबर है। DesignArena का कहना है कि open-weights leaderboard पर यह Kimi K3 से 15 Elo अंक आगे है।
LLM Creative Story-Writing Benchmark (Lech Mazur ने 24 अक्टूबर को पोस्ट किया): Kimi K3.1 Pro (high) को 2.72 अंक मिले, जो Kimi K3 के 2.35 से अधिक हैं। समान 50 prompts पर Kimi K3 के मुकाबले इसके 35 जीत, 8 बराबरी और 7 हार दर्ज हुईं। Mazur का कहना है कि मुख्य सुधार कथानक रचने में है: ज़रूरी तत्व पात्रों के फैसलों और उनके परिणामों को पहले से अधिक लगातार ढंग से आकार देते हैं। यह 34% कम reasoning tokens भी इस्तेमाल करता है।
स्रोत
- बड़ी ख़बर: @Kimi_Moonshot, Kimi K3.1 Pro के लॉन्च के साथ Code Arena: WebDev में फिर शीर्ष 4 labs में शामिल हो गया है!X · 3 टिप्पणियाँ
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 टिप्पणियाँ
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 टिप्पणी
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 टिप्पणियाँ
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 टिप्पणियाँ
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 टिप्पणी
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 टिप्पणियाँ
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 टिप्पणियाँ
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 टिप्पणियाँ
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 टिप्पणियाँ
चर्चाएँ
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 टिप्पणियाँ
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 टिप्पणियाँ
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 टिप्पणियाँ
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 टिप्पणियाँ
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 टिप्पणियाँ
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 टिप्पणियाँ
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 टिप्पणियाँ
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 टिप्पणियाँ
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 टिप्पणियाँ
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 टिप्पणियाँ
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 टिप्पणियाँ
ऐसी ख़बरें push में पाएँ।
आपके टूल्स में कुछ बदलते ही AI Tracker आपको अलर्ट करता है।