 AI Tracker
Artificial Analysis e Arena collocano Kimi K3.1 Pro al 4° posto nei rispettivi indici e all’8° in Code Arena WebDev
Due valutatori indipendenti hanno pubblicato i risultati di Kimi K3.1 Pro di Moonshot entro un’ora dal lancio. Entrambi indicano un prezzo di $2 per milione di token in input e $10 per milione di token in output; Artificial Analysis riporta $0.20 per l’input memorizzato nella cache, il 33% in meno rispetto a Kimi K3.
Artificial Analysis afferma che il modello ottiene 55 nel suo Intelligence Index, 11 punti in più di Kimi K3 (44) e 4° posto assoluto, dietro a Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) e Muse Wonder Full (56). Gli altri dati:
- È 3° in GDPval-AA con 1.846 Elo, 312 in più rispetto a Kimi K3.
- Ha il punteggio più alto mai registrato in Terminal-Bench 4.0 tra i modelli testati, 67% (Kimi K3: 13%; Claude Sonnet 5.5: 64%).
- AutomationBench-AA sale dal 58% al 73%. I progressi in Humanity's Last Exam (dal 47% al 52%), CritPt (dal 23% al 25%) e SciCode (dal 59% al 61%) sono più contenuti.
- Il tasso di allucinazioni su AA-Omniscience scende dal 53% al 44%.
- Il costo per attività è di circa $1.98, sostanzialmente in linea con Kimi K3, perché usa il 14% di token in output in più.
- Una volta pubblicati i pesi, Artificial Analysis afferma che sarebbe il modello open-weight con il punteggio più alto, riducendo il divario rispetto ai modelli proprietari da 12 a 3 punti.
Arena afferma che il modello è all’8° posto in Code Arena: WebDev con 1692 punti, 9 posizioni e 37 punti sopra Kimi K3, alla pari con Claude Opus 5 (Max) a un costo che, secondo Arena, è inferiore del 70%. Il costo mediano per attività è di $1.23, il 29% in meno rispetto a Kimi K3. Arena riporta anche il 7° posto in Brand & Marketing e il 9° in Simulations, e afferma che con pesi aperti sarebbe il miglior modello open in WebDev, davanti a DeepSeek V4.1 Flash.
Artificial Analysis Cyber Index (pubblicato più tardi nella giornata): Kimi K3.1 Pro ottiene il 64%, 23 punti in più rispetto a Kimi K3 (41%). Artificial Analysis afferma che questo lo rende il miglior modello disponibile apertamente e il secondo in assoluto, dietro solo a GPT-6 Sol (Daybreak Blue, max) di OpenAI, disponibile con accesso approvato, al 69%, e davanti a DeepSeek V4.1 Flash 1017 (57%). Riporta il punteggio più alto mai registrato in CyberGym-E2E-AA tra i modelli testati (95%), il 37% in DeepsecBench-AA e il 61% in CWE-Bench-AA (dove DeepSeek V4.1 Flash 1017 è in testa con il 69%), oltre all’assenza di rifiuti per motivi di sicurezza. Il costo per attività è di $2.81, il 15% in più rispetto a Kimi K3, perché usa circa il doppio dei token in input.
Extended NYT Connections (benchmark indipendente di Lech Mazur, pubblicato più tardi nella giornata): Kimi K3.1 Pro (high) ottiene 93.4, leggermente sotto Kimi K3 con 93.6, usando però meno token di ragionamento. Mazur ha testato anche GPT-6 Astra (max) e GPT-6.1 Sol (max); Gemini 4 Argon (high) resta al primo posto.
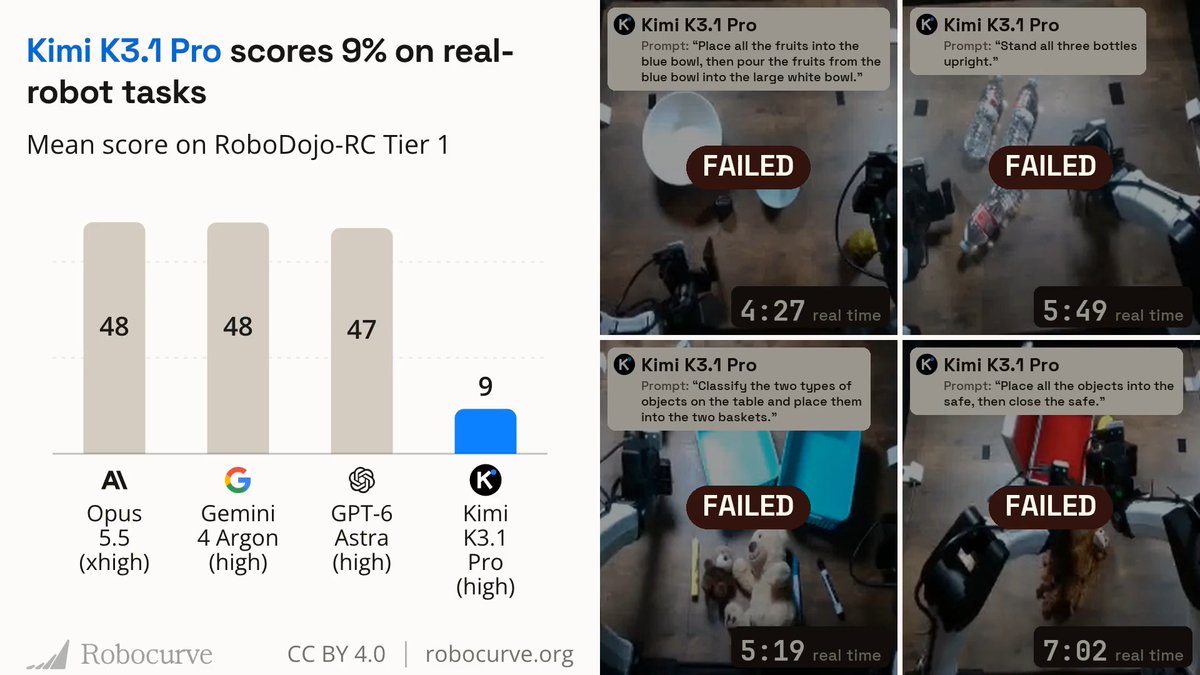
Robocurve real-robot tasks (pubblicato quella sera, ora del Pacifico): Robocurve, un’organizzazione che si occupa di benchmarking per l’IA fisica, afferma che Kimi K3.1 Pro ottiene il 9% nei suoi test su robot reali, dietro a Claude Opus 5.5, Gemini 4 Argon e GPT-6 Astra.
Agent Arena (pubblicato il 24 ottobre da Arena): Kimi K3.1 Pro (Max) entra in Agent Arena all’11° posto, con un miglioramento netto del 7.6% su oltre 4.000 sessioni agentiche nel mondo reale degli utenti di Arena. Arena afferma che questo lo renderebbe il miglior modello open in Agent Arena, davanti a DeepSeek V4.1 Flash.
VulnPR-100 (pubblicato il 24 ottobre da un utente che ha eseguito il benchmark di BugBunny): sottoposto a 100 pull request con vulnerabilità note e un’ora per ciascuna PR, Kimi K3.1 Pro ne ha individuate 47 per $124.69, 10 in più di Kimi K3 e spendendo $20.54 in meno. Un post rilanciato aggiunge che DeepSeek V4.1 Flash 1017 ne ha individuate 54 per $7.53.
Mazebench (pubblicato il 24 ottobre dal suo autore): Kimi K3.1 Pro ottiene il 2%, un risultato che il post definisce il primo punteggio non trascurabile per un modello open-weight; DeepSeek V4.1 Flash ottiene l’1%.
Design Creativity Bench (pubblicato il 24 ottobre dal suo responsabile): il punteggio complessivo di creatività di Kimi K3.1 Pro sale da 40.4 a 45.8 rispetto a Kimi K3. Il punteggio di appropriatezza sale dal 96.8% al 98.5%, risultato che, secondo il post sul benchmark, supera quello di tutti gli altri modelli open-weight valutati ed è alla pari con Claude Fable 5.1. Genera design quasi due volte più velocemente di Kimi K3 e il costo mediano per design scende del 18%, da $0.570 a $0.466.
DesignArena Website leaderboard (pubblicata il 24 ottobre da DesignArena): secondo le proiezioni, Kimi K3.1 Pro si piazzerebbe al 1° posto tra i modelli open-weight e a pari merito al 3° posto assoluto, dietro solo a Muse Wonder (max) e Muse Spark 1.3 (xhigh) e alla pari con Muse Spark 1.3 Max. DesignArena afferma che supera Kimi K3 di 15 punti Elo nella classifica open-weight.
LLM Creative Story-Writing Benchmark (pubblicato il 24 ottobre da Lech Mazur): Kimi K3.1 Pro (high) ottiene 2.72, rispetto a 2.35 per Kimi K3. Su 50 prompt abbinati registra 35 vittorie, 8 pareggi e 7 sconfitte contro Kimi K3. Mazur afferma che il principale miglioramento riguarda la trama: gli elementi richiesti influenzano con maggiore coerenza le decisioni dei personaggi e le relative conseguenze. Inoltre, usa il 34% in meno di token di ragionamento.
Fonti
- Grande notizia: con il lancio di Kimi K3.1 Pro, @Kimi_Moonshot è tornata tra i primi 4 laboratori in Code Arena: WebDev!X · 3 commenti
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 commenti
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 commento
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 commenti
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 commenti
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 commento
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 commenti
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 commenti
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 commenti
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 commenti
Discussioni
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 commenti
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 commenti
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 commenti
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 commenti
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 commenti
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 commenti
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 commenti
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 commenti
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 commenti
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 commenti
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 commenti
Ricevi notizie come questa via push.
AI Tracker ti avvisa quando cambia qualcosa negli strumenti che usi.