 AI Tracker
Artificial Analysis và Arena xếp Kimi K3.1 Pro ở vị trí thứ 4 trên các bảng xếp hạng của họ và hạng 8 trong Code Arena WebDev
Hai đơn vị đánh giá độc lập công bố kết quả về Kimi K3.1 Pro của Moonshot trong vòng một giờ sau khi model ra mắt. Cả hai đều ghi nhận giá $2 cho mỗi triệu token đầu vào và $10 cho mỗi triệu token đầu ra; Artificial Analysis niêm yết giá đầu vào được lưu trong bộ nhớ đệm là $0.20, thấp hơn 33% so với Kimi K3.
Artificial Analysis cho biết model đạt 55 điểm trong Intelligence Index, cao hơn Kimi K3 (44) 11 điểm và đứng thứ 4 toàn bảng, sau Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) và Muse Wonder Full (56). Các số liệu khác:
- Model đứng thứ 3 trên GDPval-AA với 1,846 Elo, tăng 312 điểm so với Kimi K3.
- Model đạt điểm Terminal-Bench 4.0 cao nhất trong số các model mà đơn vị này từng thử nghiệm: 67% (Kimi K3: 13%; Claude Sonnet 5.5: 64%).
- AutomationBench-AA tăng từ 58% lên 73%. Mức tăng trên Humanity's Last Exam (47% lên 52%), CritPt (23% lên 25%) và SciCode (59% lên 61%) khiêm tốn hơn.
- Tỷ lệ ảo giác trên AA-Omniscience giảm từ 53% xuống 44%.
- Chi phí mỗi tác vụ vào khoảng $1.98, gần ngang với Kimi K3, do model sử dụng nhiều hơn 14% token đầu ra.
- Artificial Analysis cho biết sau khi trọng số được công bố, đây sẽ là model trọng số mở đạt điểm cao nhất, thu hẹp khoảng cách với các model độc quyền từ 12 điểm xuống còn 3.
Arena cho biết model xếp hạng #8 trong Code Arena: WebDev với 1692 điểm, tăng 9 bậc và 37 điểm so với Kimi K3, ngang với Claude Opus 5 (Max) ở mức chi phí mà họ cho là thấp hơn 70%. Chi phí trung vị mỗi tác vụ là $1.23, thấp hơn Kimi K3 29%. Arena cũng báo cáo model xếp hạng #7 trong Brand & Marketing và #9 trong Simulations, đồng thời cho biết với trọng số mở, đây sẽ là model mở hàng đầu trong WebDev, vượt DeepSeek V4.1 Flash.
Artificial Analysis Cyber Index (đăng muộn hơn trong ngày): Kimi K3.1 Pro đạt 64%, tăng 23 điểm so với Kimi K3 (41%). Artificial Analysis cho biết kết quả này đưa model lên vị trí hàng đầu trong số các model có thể tiếp cận công khai và hạng nhì toàn bảng, chỉ sau GPT-6 Sol (Daybreak Blue, max) của OpenAI, model được cấp quyền truy cập đáng tin cậy, với 69%; đồng thời vượt DeepSeek V4.1 Flash 1017 (57%). Model đạt điểm CyberGym-E2E-AA cao nhất trong số các model mà đơn vị này từng thử nghiệm (95%), đạt 37% trên DeepsecBench-AA và 61% trên CWE-Bench-AA (DeepSeek V4.1 Flash 1017 dẫn đầu ở bài này với 69%), và không có lần từ chối nào vì lý do an toàn. Chi phí mỗi tác vụ là $2.81, cao hơn Kimi K3 15%, do model dùng lượng token đầu vào gấp khoảng hai lần.
Extended NYT Connections (benchmark độc lập của Lech Mazur, đăng muộn hơn trong ngày): Kimi K3.1 Pro (high) đạt 93.4, thấp hơn đôi chút so với Kimi K3 ở mức 93.6, trong khi sử dụng ít token suy luận hơn. Mazur cũng thử nghiệm GPT-6 Astra (max) và GPT-6.1 Sol (max); Gemini 4 Argon (high) vẫn đứng đầu.
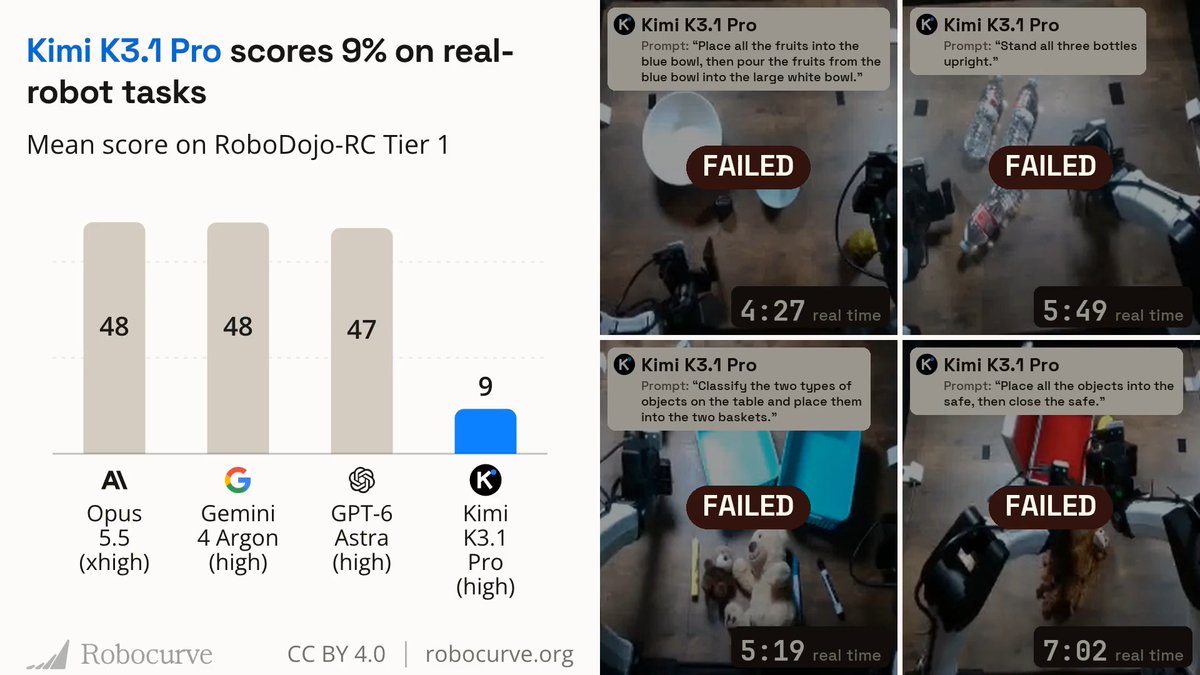
Tác vụ robot thực tế của Robocurve (đăng tối hôm đó theo giờ Thái Bình Dương): Robocurve, một tổ chức đánh giá AI vật lý, cho biết Kimi K3.1 Pro đạt 9% trong các tác vụ robot thực tế của họ, đứng sau Claude Opus 5.5, Gemini 4 Argon và GPT-6 Astra.
Agent Arena (Arena đăng ngày 24 tháng 10): Kimi K3.1 Pro (Max) vào Agent Arena ở vị trí #11, với mức cải thiện ròng 7.6% qua hơn 4,000 phiên tác vụ agentic thực tế của người dùng Arena. Arena cho biết kết quả này sẽ đưa model lên vị trí model mở hàng đầu trong Agent Arena, vượt DeepSeek V4.1 Flash.
VulnPR-100 (do một người dùng chạy benchmark của BugBunny đăng ngày 24 tháng 10): Khi được giao 100 pull request có lỗ hổng đã biết và một giờ cho mỗi PR, Kimi K3.1 Pro tìm ra 47 lỗi với chi phí $124.69, nhiều hơn Kimi K3 10 lỗi nhưng tốn ít hơn $20.54. Một bài đăng được chia sẻ lại cho biết DeepSeek V4.1 Flash 1017 tìm ra 54 lỗi với giá $7.53.
Mazebench (do tác giả đăng ngày 24 tháng 10): Kimi K3.1 Pro đạt 2%, mức điểm mà bài đăng gọi là kết quả đầu tiên không tầm thường của một model trọng số mở; DeepSeek V4.1 Flash đạt 1%.
Design Creativity Bench (do người duy trì đăng ngày 24 tháng 10): Điểm sáng tạo tổng thể của Kimi K3.1 Pro tăng từ 40.4 lên 45.8 so với Kimi K3. Điểm phù hợp tăng từ 96.8% lên 98.5%; bài đăng của benchmark cho biết mức này vượt mọi model trọng số mở khác mà họ từng đánh giá và ngang với Claude Fable 5.1. Model tạo thiết kế nhanh gần gấp đôi Kimi K3, còn chi phí trung vị mỗi thiết kế giảm 18%, từ $0.570 xuống $0.466.
Bảng xếp hạng Website của DesignArena (DesignArena đăng ngày 24 tháng 10): Kimi K3.1 Pro được dự đoán sẽ đứng #1 trong số các model trọng số mở và đồng hạng #3 toàn bảng, chỉ sau Muse Wonder (max) và Muse Spark 1.3 (xhigh), ngang với Muse Spark 1.3 Max. DesignArena cho biết model hơn Kimi K3 15 điểm Elo trên bảng xếp hạng trọng số mở.
LLM Creative Story-Writing Benchmark (Lech Mazur đăng ngày 24 tháng 10): Kimi K3.1 Pro (high) đạt 2.72, tăng từ mức 2.35 của Kimi K3. Trong 50 prompt ghép cặp, model thắng 35, hòa 8 và thua 7 khi so với Kimi K3. Mazur cho biết cải thiện chính nằm ở khả năng xây dựng cốt truyện tốt hơn: các yếu tố bắt buộc tác động nhất quán hơn đến quyết định của nhân vật và hệ quả của những quyết định đó; model cũng dùng ít hơn 34% token suy luận.
Nguồn
- Tin lớn: @Kimi_Moonshot đã trở lại nhóm 4 phòng thí nghiệm hàng đầu trong Code Arena: WebDev với màn ra mắt Kimi K3.1 Pro!X · 3 bình luận
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 bình luận
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 bình luận
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 bình luận
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 bình luận
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 bình luận
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 bình luận
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 bình luận
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 bình luận
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 bình luận
Thảo luận
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 bình luận
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 bình luận
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 bình luận
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 bình luận
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 bình luận
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 bình luận
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 bình luận
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 bình luận
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 bình luận
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 bình luận
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 bình luận
Nhận tin như thế này qua thông báo đẩy.
AI Tracker báo cho bạn khi công cụ bạn dùng có thay đổi.