 AI Tracker
Artificial Analysis 與 Arena 在各自排行榜將 Kimi K3.1 Pro 排名第 4,在 Code Arena WebDev 排名第 8
兩家獨立評測機構在 Moonshot 發布 Kimi K3.1 Pro 後不到一小時內公布了評測結果。兩者列出的價格皆為每百萬輸入 tokens 2 美元、每百萬輸出 tokens 10 美元;Artificial Analysis 列出的快取輸入價格為 0.20 美元,比 Kimi K3 低 33%。
Artificial Analysis 表示,該模型在 Intelligence Index 得分為 55,比 Kimi K3(44)高 11 分,總排名第 4,僅次於 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。其他數據如下:
- 它在 GDPval-AA 排名第 3,Elo 為 1,846,比 Kimi K3 高 312 分。
- 在 Artificial Analysis 測試過的所有模型中,它的 Terminal-Bench 4.0 得分最高,為 67%(Kimi K3:13%;Claude Sonnet 5.5:64%)。
- AutomationBench-AA 從 58% 升至 73%。在 Humanity's Last Exam(47% 升至 52%)、CritPt(23% 升至 25%)和 SciCode(59% 升至 61%)上的進步較小。
- 它在 AA-Omniscience 上的幻覺率從 53% 降至 44%。
- 每項任務成本約為 1.98 美元,與 Kimi K3 大致相當,因為它使用的輸出 tokens 多 14%。
- Artificial Analysis 表示,權重發布後,它將成為得分最高的開放權重模型,與專有模型的差距將從 12 分縮小至 3 分。
Arena 表示,該模型在 Code Arena: WebDev 排名第 8,得分 1692,比 Kimi K3 上升 9 個名次、增加 37 分;與 Claude Opus 5 (Max) 表現相當,成本則據稱低 70%。每項任務的成本中位數為 1.23 美元,比 Kimi K3 低 29%。Arena 也指出,它在 Brand & Marketing 排名第 7、在 Simulations 排名第 9,並表示若採用開放權重,它將成為 WebDev 排名最高的開放模型,領先 DeepSeek V4.1 Flash。
Artificial Analysis Cyber Index(當日晚些時候發布):Kimi K3.1 Pro 得分 64%,比 Kimi K3(41%)高 23 分。Artificial Analysis 表示,這使它成為排名最高的公開可用模型,總排名第二,僅次於具可信存取權的 OpenAI GPT-6 Sol(Daybreak Blue, max),後者得分 69%;並領先 DeepSeek V4.1 Flash 1017(57%)。該機構表示,這是它測試過的所有模型中 CyberGym-E2E-AA 得分最高的模型(95%);它在 DeepsecBench-AA 得分 37%,在 CWE-Bench-AA 得分 61%(DeepSeek V4.1 Flash 1017 以 69% 領先),且沒有安全拒答。每項任務成本為 2.81 美元,比 Kimi K3 高 15%,因為它使用的輸入 tokens 約為兩倍。
Extended NYT Connections(Lech Mazur 的獨立基準測試,當日晚些時候發布):Kimi K3.1 Pro (high) 得分 93.4,略低於 Kimi K3 的 93.6,但使用的推理 tokens 較少。Mazur 也測試了 GPT-6 Astra (max) 和 GPT-6.1 Sol (max);Gemini 4 Argon (high) 仍居首位。
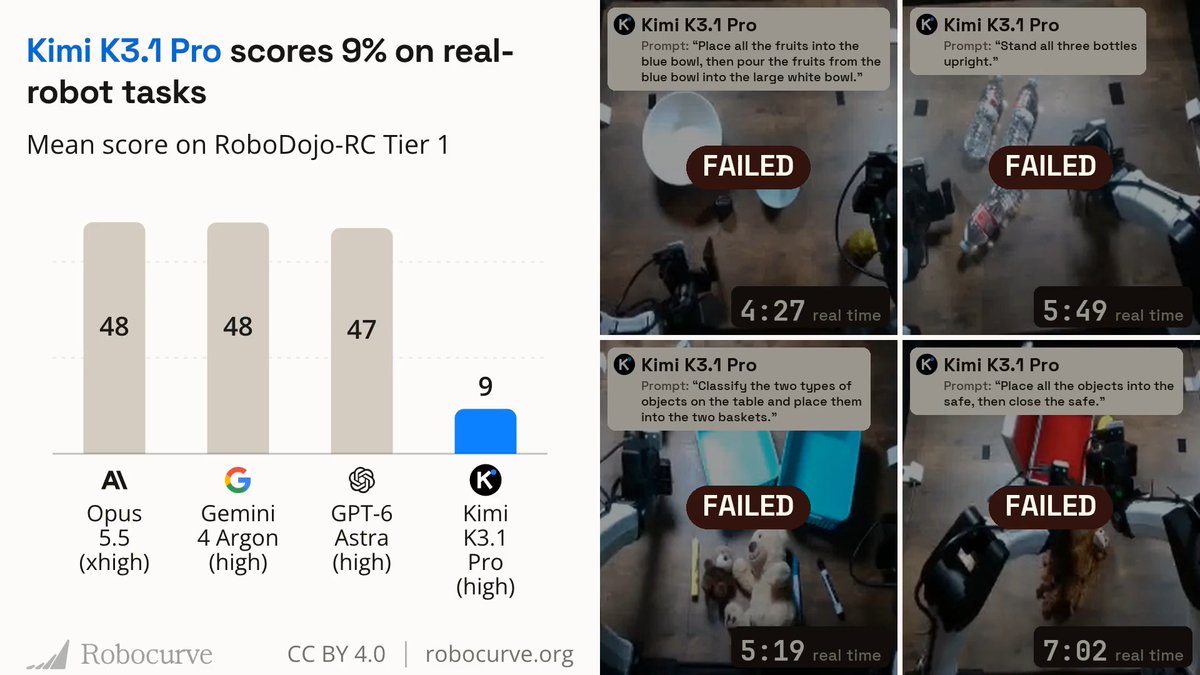
Robocurve 真實機器人任務(當晚太平洋時間發布):實體 AI 基準測試組織 Robocurve 表示,Kimi K3.1 Pro 在其真實機器人任務上的得分為 9%,落後於 Claude Opus 5.5、Gemini 4 Argon 和 GPT-6 Astra。
Agent Arena(Arena 於 10 月 24 日發布):Kimi K3.1 Pro (Max) 在 Agent Arena 排名第 11;根據 Arena 使用者超過 4,000 場真實世界代理工作階段的結果,其整體表現提升 7.6%。Arena 表示,這將使它成為 Agent Arena 排名最高的開放模型,領先 DeepSeek V4.1 Flash。
VulnPR-100(一位使用者於 10 月 24 日發布,使用 BugBunny 的基準測試):給定 100 個含有已知漏洞的 pull requests,且每個 PR 有一小時,Kimi K3.1 Pro 找出 47 個漏洞,成本為 124.69 美元;比 Kimi K3 多找出 10 個,成本則少 20.54 美元。一則轉載貼文補充,DeepSeek V4.1 Flash 1017 找出 54 個,成本為 7.53 美元。
Mazebench(作者於 10 月 24 日發布):Kimi K3.1 Pro 得分 2%;貼文稱這是開放權重模型首次取得非微不足道的分數。DeepSeek V4.1 Flash 得分 1%。
Design Creativity Bench(維護者於 10 月 24 日發布):相較於 Kimi K3,Kimi K3.1 Pro 的整體創意得分從 40.4 升至 45.8。適切性得分從 96.8% 升至 98.5%;該基準測試的貼文稱,這高於其評測過的所有其他開放權重模型,並與 Claude Fable 5.1 相當。它生成設計的速度幾乎是 Kimi K3 的兩倍,每個設計的成本中位數則降低 18%,從 0.570 美元降至 0.466 美元。
DesignArena Website leaderboard(DesignArena 於 10 月 24 日發布):預測 Kimi K3.1 Pro 將在開放權重模型中排名第 1,總排名並列第 3,僅次於 Muse Wonder (max) 和 Muse Spark 1.3 (xhigh),並與 Muse Spark 1.3 Max 並列。DesignArena 表示,它在開放權重排行榜上比 Kimi K3 高 15 Elo 分。
LLM Creative Story-Writing Benchmark(Lech Mazur 於 10 月 24 日發布):Kimi K3.1 Pro (high) 得分 2.72,高於 Kimi K3 的 2.35。在 50 個配對提示中,對 Kimi K3 的結果為 35 勝、8 平、7 負。Mazur 表示,主要進步在於情節安排更出色:必須納入的元素更穩定地影響角色的決定及其後果;此外,它使用的推理 tokens 減少 34%。
來源
- 重大消息:@Kimi_Moonshot 發布 Kimi K3.1 Pro,重返 Code Arena: WebDev 前四大實驗室之列!X · 3 則留言
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 則留言
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 則留言
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 則留言
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 則留言
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 則留言
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 則留言
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 則留言
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 則留言
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 則留言
討論
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 則留言
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 則留言
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 則留言
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 則留言
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 則留言
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 則留言
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 則留言
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 則留言
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 則留言
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 則留言
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 則留言
這樣的新聞,第一時間推播給你。
你使用的 AI 工具一有變化,AI Tracker 就會通知你。