 AI Tracker
Artificial Analysis et Arena classent Kimi K3.1 Pro au 4e rang de leurs indices et au no 8 de Code Arena WebDev
Deux évaluateurs indépendants ont publié des résultats pour Kimi K3.1 Pro de Moonshot dans l’heure suivant son lancement. Tous deux fixent son prix à 2 $ par million de tokens d’entrée et à 10 $ par million de tokens de sortie ; Artificial Analysis indique que les tokens d’entrée mis en cache coûtent 0,20 $, soit 33 % de moins que pour Kimi K3.
Artificial Analysis indique que le modèle obtient 55 à son Intelligence Index, soit 11 points de plus que Kimi K3 (44), et se classe 4e au total, derrière Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) et Muse Wonder Full (56). Voici ses autres résultats :
- Il se classe 3e sur GDPval-AA avec 1 846 points Elo, soit 312 de plus que Kimi K3.
- Il obtient le meilleur score à Terminal-Bench 4.0 parmi tous les modèles testés par l’organisme : 67 % (Kimi K3 : 13 % ; Claude Sonnet 5.5 : 64 %).
- AutomationBench-AA passe de 58 % à 73 %. Les progrès sur Humanity's Last Exam (de 47 % à 52 %), CritPt (de 23 % à 25 %) et SciCode (de 59 % à 61 %) sont plus modestes.
- Son taux d’hallucination sur AA-Omniscience passe de 53 % à 44 %.
- Le coût par tâche est d’environ 1,98 $, à peu près au même niveau que Kimi K3, car le modèle utilise 14 % de tokens de sortie en plus.
- Une fois les poids publiés, Artificial Analysis estime qu’il deviendrait le modèle à poids ouverts le mieux noté, réduisant l’écart avec les modèles propriétaires de 12 à 3 points.
Arena indique que le modèle se classe no 8 dans Code Arena: WebDev avec 1 692 points, soit 9 places et 37 points de mieux que Kimi K3, à un coût inférieur de 70 % à celui de Claude Opus 5 (Max), selon l’organisme. Son coût médian par tâche est de 1,23 $, soit 29 % de moins que pour Kimi K3. Arena le classe aussi no 7 en Brand & Marketing et no 9 en Simulations, et affirme qu’avec ses poids ouverts, il serait le meilleur modèle à poids ouverts en WebDev, devant DeepSeek V4.1 Flash.
Artificial Analysis Cyber Index (publication plus tard dans la journée) : Kimi K3.1 Pro obtient 64 %, soit 23 points de plus que Kimi K3 (41 %). Artificial Analysis affirme qu’il s’agit ainsi du meilleur modèle disponible en accès ouvert et du deuxième au classement général, derrière le GPT-6 Sol (Daybreak Blue, max) à accès de confiance d’OpenAI, à 69 %, et devant DeepSeek V4.1 Flash 1017 (57 %). Le modèle obtient le meilleur score à CyberGym-E2E-AA parmi tous les modèles testés par l’organisme (95 %), 37 % à DeepsecBench-AA et 61 % à CWE-Bench-AA (où DeepSeek V4.1 Flash 1017 mène avec 69 %), et ne refuse aucune requête pour des raisons de sécurité. Le coût par tâche est de 2,81 $, soit 15 % de plus que pour Kimi K3, car le modèle utilise environ deux fois plus de tokens d’entrée.
Extended NYT Connections (benchmark indépendant de Lech Mazur, publié plus tard dans la journée) : Kimi K3.1 Pro (high) obtient 93,4, légèrement en dessous de Kimi K3 à 93,6, tout en utilisant moins de tokens de raisonnement. Mazur a également testé GPT-6 Astra (max) et GPT-6.1 Sol (max) ; Gemini 4 Argon (high) reste en tête.
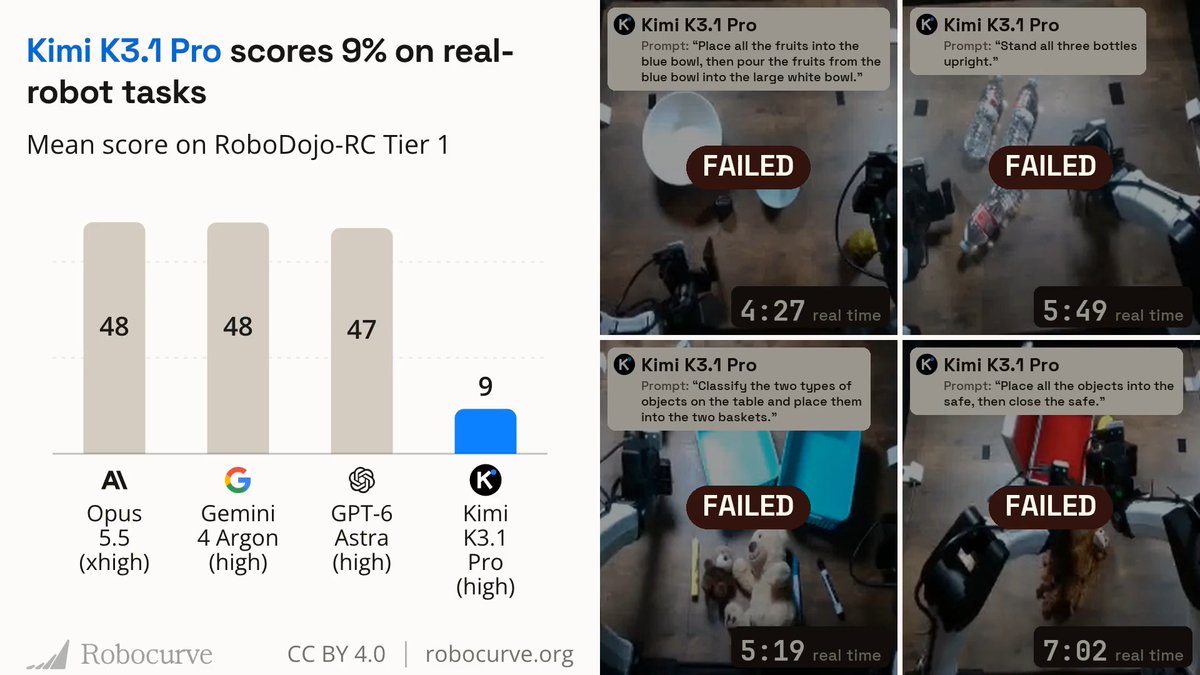
Tâches sur robots réels de Robocurve (publication dans la soirée, heure du Pacifique) : Robocurve, un organisme d’évaluation de l’IA physique, indique que Kimi K3.1 Pro obtient 9 % à ses tâches sur robots réels, derrière Claude Opus 5.5, Gemini 4 Argon et GPT-6 Astra.
Agent Arena (publication du 24 octobre par Arena) : Kimi K3.1 Pro (Max) entre dans Agent Arena au no 11, avec une amélioration nette de 7,6 % sur plus de 4 000 sessions agentiques en conditions réelles menées par les utilisateurs d’Arena. Arena affirme que le modèle deviendrait ainsi le meilleur modèle à poids ouverts d’Agent Arena, devant DeepSeek V4.1 Flash.
VulnPR-100 (publication du 24 octobre par un utilisateur ayant exécuté le benchmark de BugBunny) : avec 100 pull requests comportant des vulnérabilités connues et une heure par PR, Kimi K3.1 Pro en a trouvé 47 pour 124,69 $, soit 10 de plus que Kimi K3 pour 20,54 $ de plus. Une publication relayée ajoute que DeepSeek V4.1 Flash 1017 en a trouvé 54 pour 7,53 $.
Mazebench (publication du 24 octobre par son auteur) : Kimi K3.1 Pro obtient 2 %, un résultat qualifié dans la publication de premier score non négligeable pour un modèle à poids ouverts ; DeepSeek V4.1 Flash obtient 1 %.
Design Creativity Bench (publication du 24 octobre par son responsable) : le score global de créativité de Kimi K3.1 Pro passe de 40,4 à 45,8 par rapport à Kimi K3. Son score de pertinence passe de 96,8 % à 98,5 %, ce qui, selon la publication du benchmark, le place devant tous les autres modèles à poids ouverts évalués et au même niveau que Claude Fable 5.1. Il génère des designs presque deux fois plus vite que Kimi K3, et le coût médian par design baisse de 18 %, passant de 0,570 $ à 0,466 $.
Classement Website de DesignArena (publication du 24 octobre par DesignArena) : Kimi K3.1 Pro devrait se classer no 1 parmi les modèles à poids ouverts et ex æquo au 3e rang au classement général, derrière seulement Muse Wonder (max) et Muse Spark 1.3 (xhigh), et au même niveau que Muse Spark 1.3 Max. DesignArena affirme qu’il devance Kimi K3 de 15 points Elo au classement des modèles à poids ouverts.
LLM Creative Story-Writing Benchmark (publication du 24 octobre par Lech Mazur) : Kimi K3.1 Pro (high) obtient 2,72, contre 2,35 pour Kimi K3. Sur 50 prompts identiques, il enregistre 35 victoires, 8 égalités et 7 défaites contre Kimi K3. Mazur indique que le principal progrès concerne la construction de l’intrigue : les éléments imposés influencent plus systématiquement les décisions des personnages et leurs conséquences. Il ajoute que le modèle utilise 34 % de tokens de raisonnement en moins.
Sources
- Grande nouvelle : @Kimi_Moonshot revient parmi les 4 meilleurs labos du classement Code Arena: WebDev avec le lancement de Kimi K3.1 Pro !X · 3 commentaires
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 commentaires
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 commentaire
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 commentaires
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 commentaires
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 commentaire
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 commentaires
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 commentaires
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 commentaires
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 commentaires
Discussions
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 commentaires
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 commentaires
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 commentaires
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 commentaires
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 commentaires
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 commentaires
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 commentaires
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 commentaires
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 commentaires
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 commentaires
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 commentaires
Recevez ce genre d'actus en notification.
AI Tracker vous prévient dès que quelque chose change pour les outils que vous utilisez.