 AI Tracker
Artificial Analysis y Arena sitúan a Kimi K3.1 Pro en el 4.º puesto de sus índices y en el n.º 8 de Code Arena WebDev
Dos evaluadores independientes publicaron resultados de Kimi K3.1 Pro de Moonshot menos de una hora después de su lanzamiento. Ambos sitúan su precio en $2 por millón de tokens de entrada y $10 por millón de tokens de salida; Artificial Analysis indica que la entrada en caché cuesta $0.20, un 33% menos que Kimi K3.
Artificial Analysis afirma que el modelo obtiene 55 en su Intelligence Index, 11 puntos más que Kimi K3 (44) y el 4.º puesto general, por detrás de Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) y Muse Wonder Full (56). Estas son otras cifras:
- Ocupa el 3.º puesto en GDPval-AA con 1,846 Elo, 312 más que Kimi K3.
- Tiene la puntuación más alta de Terminal-Bench 4.0 de todos los modelos que ha probado: 67% (Kimi K3: 13%; Claude Sonnet 5.5: 64%).
- AutomationBench-AA pasa del 58% al 73%. Las mejoras en Humanity's Last Exam (del 47% al 52%), CritPt (del 23% al 25%) y SciCode (del 59% al 61%) son menores.
- Su tasa de alucinación en AA-Omniscience baja del 53% al 44%.
- El costo por tarea es de aproximadamente $1.98, prácticamente igual al de Kimi K3, porque usa un 14% más de tokens de salida.
- Una vez publicados los pesos, Artificial Analysis afirma que sería el modelo de pesos abiertos con la puntuación más alta, y reduciría la brecha con los modelos propietarios de 12 a 3 puntos.
Arena afirma que el modelo ocupa el puesto n.º 8 en Code Arena: WebDev con 1692 puntos, 9 puestos y 37 puntos por encima de Kimi K3, a la par de Claude Opus 5 (Max) con un costo, según Arena, un 70% menor. Su costo mediano por tarea es de $1.23, un 29% menos que el de Kimi K3. Arena también informa que ocupa el puesto n.º 7 en Brand & Marketing y el n.º 9 en Simulations, y afirma que, con pesos abiertos, sería el mejor modelo abierto en WebDev, por delante de DeepSeek V4.1 Flash.
Artificial Analysis Cyber Index (publicado más tarde ese día): Kimi K3.1 Pro obtiene un 64%, 23 puntos más que Kimi K3 (41%). Artificial Analysis afirma que esto lo convierte en el mejor modelo disponible abiertamente y en el segundo a nivel general, solo por detrás de GPT-6 Sol (Daybreak Blue, max) de acceso confiable de OpenAI, con un 69%, y por delante de DeepSeek V4.1 Flash 1017 (57%). Informa que tiene la puntuación más alta de CyberGym-E2E-AA de todos los modelos que ha probado (95%), un 37% en DeepsecBench-AA y un 61% en CWE-Bench-AA (DeepSeek V4.1 Flash 1017 lidera esta última con un 69%), y que no rechaza solicitudes por motivos de seguridad. El costo por tarea es de $2.81, un 15% más que el de Kimi K3, porque usa aproximadamente el doble de tokens de entrada.
Extended NYT Connections (benchmark independiente de Lech Mazur, publicado más tarde ese día): Kimi K3.1 Pro (high) obtiene 93.4, ligeramente por debajo de Kimi K3, con 93.6, aunque usa menos tokens de razonamiento. Mazur también probó GPT-6 Astra (max) y GPT-6.1 Sol (max); Gemini 4 Argon (high) sigue en primer lugar.
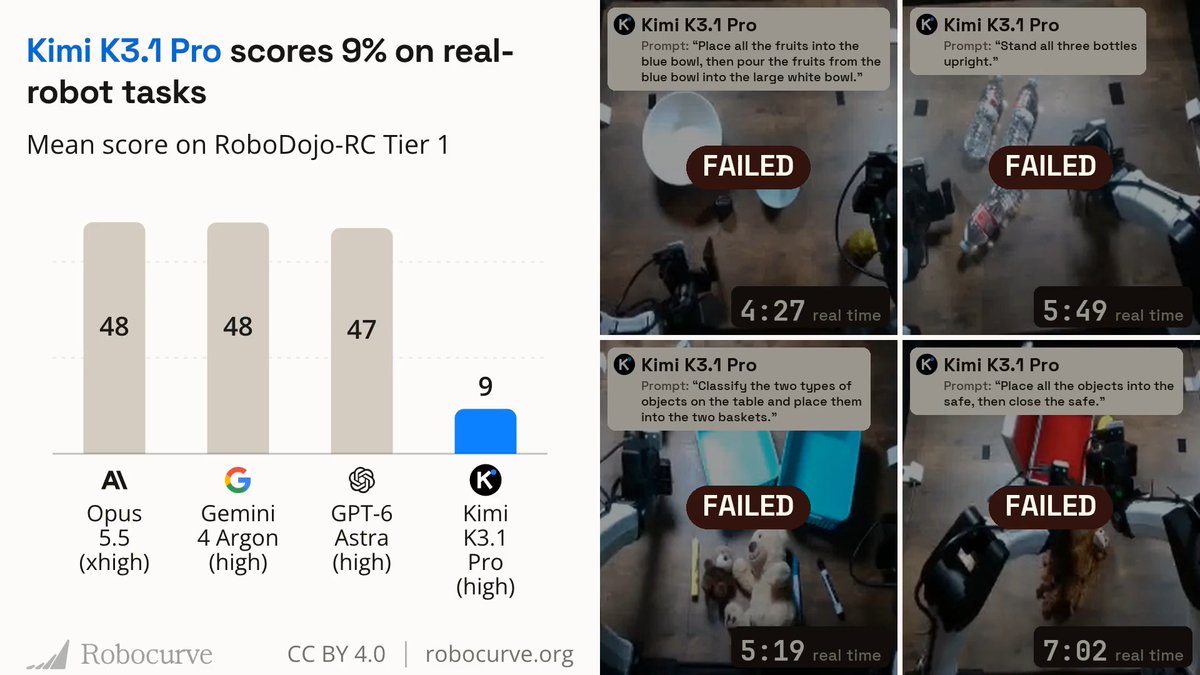
Tareas de robots reales de Robocurve (publicado esa tarde, hora del Pacífico): Robocurve, una organización de evaluación comparativa de IA física, afirma que Kimi K3.1 Pro obtiene un 9% en sus tareas con robots reales, por detrás de Claude Opus 5.5, Gemini 4 Argon y GPT-6 Astra.
Agent Arena (publicado el 24 de octubre por Arena): Kimi K3.1 Pro (Max) entra en Agent Arena en el puesto n.º 11, con una mejora neta del 7.6% en más de 4,000 sesiones agénticas del mundo real de usuarios de Arena. Arena afirma que eso lo convertiría en el mejor modelo abierto de Agent Arena, por delante de DeepSeek V4.1 Flash.
VulnPR-100 (publicado el 24 de octubre por un usuario que ejecutó el benchmark de BugBunny): al recibir 100 solicitudes de extracción con vulnerabilidades conocidas y una hora por solicitud, Kimi K3.1 Pro encontró 47 por $124.69, 10 más que Kimi K3 por $20.54 menos. Una publicación compartida añade que DeepSeek V4.1 Flash 1017 encontró 54 por $7.53.
Mazebench (publicado el 24 de octubre por su autor): Kimi K3.1 Pro obtiene un 2%, lo que la publicación califica como la primera puntuación no trivial de un modelo de pesos abiertos; DeepSeek V4.1 Flash obtiene un 1%.
Design Creativity Bench (publicado el 24 de octubre por su responsable): la puntuación general de creatividad de Kimi K3.1 Pro sube de 40.4 a 45.8 frente a Kimi K3. Su puntuación de idoneidad sube del 96.8% al 98.5%, por lo que, según la publicación del benchmark, supera a todos los demás modelos de pesos abiertos que ha evaluado y queda a la par de Claude Fable 5.1. Genera diseños casi el doble de rápido que Kimi K3, y el costo mediano por diseño baja un 18%, de $0.570 a $0.466.
Clasificación de sitios web de DesignArena (publicada el 24 de octubre por DesignArena): se proyecta que Kimi K3.1 Pro ocupe el puesto n.º 1 entre los modelos de pesos abiertos y empate en el n.º 3 general, por detrás únicamente de Muse Wonder (max) y Muse Spark 1.3 (xhigh), y a la par de Muse Spark 1.3 Max. DesignArena afirma que supera a Kimi K3 por 15 puntos Elo en la clasificación de modelos de pesos abiertos.
LLM Creative Story-Writing Benchmark (publicado el 24 de octubre por Lech Mazur): Kimi K3.1 Pro (high) obtiene 2.72, frente a 2.35 de Kimi K3. En 50 prompts emparejados, registra 35 victorias, 8 empates y 7 derrotas frente a Kimi K3. Mazur afirma que la principal mejora está en una trama más sólida: los elementos requeridos influyen de forma más consistente en las decisiones de los personajes y sus consecuencias. También señala que usa un 34% menos de tokens de razonamiento.
Fuentes
- Grandes noticias: @Kimi_Moonshot vuelve a estar entre los 4 mejores laboratorios de Code Arena: WebDev con el lanzamiento de Kimi K3.1 Pro!X · 3 comentarios
- Kimi K3.1 Pro launches at 4th on the Artificial Analysis Intelligence Index scoring 55, making large gains in agentic performance; it will…X · 13 comentarios
- Kimi K3.1 Pro (high) scores slightly lower than Kimi K3 on the Extended NYT Connections Benchmark: 93.6 → 93.4. But it uses fewer…X · 1 comentarios
- Kimi K3.1 Pro scores 9% on real-robot tasks, behind Opus 5.5, Gemini 4 Argon and GPT-6 Astra.…X · 15 comentarios
- Kimi K3.1 Pro is now live on Design Creativity Bench!X · 2 comentarios
- Kimi K3.1 Pro (Max) by @Kimi_Moonshot just landed in the Agent Arena at #11 with +7.6% net improvement across +4K real-world agentic…X · 1 comentarios
- We gave Moonshot’s new Kimi K3.1 Pro 100 pull requests with known vulnerabilities and one hour per PR to find them in the @BugBunny_ai…X · 10 comentarios
- Mazebench vs Kimi K3.1 vs DeepSeek v4.1X · 9 comentarios
- Kimi K3.1 Pro (high) improves over Kimi K3 on the LLM Creative Story-Writing Benchmark: 2.35 → 2.72.X · 3 comentarios
- BREAKING: Kimi K3.1 Pro by @Kimi_Moonshot is projected to rank #1 among open-weights models on DesignArena's Website leaderboard, and is…X · 19 comentarios
Debates
- Kimi K3.1 Pro vs. Claude Opus 5.5 ⚔️X · 4 comentarios
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 20 comentarios
- Kimi K3.1 scores 55 on Artificial Analysis, placed on the Pareto lineHacker News · 38 comentarios
- So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results:X · 11 comentarios
- Kimi K3.1 Pro is the new #1 openly-available model for agentic cyber defense, behind only trusted-access model GPT-6 Sol (Daybreak Blue)…X · 11 comentarios
- Kimi K3.1 Pro 这个Terminal-Bench 4.0——average cost per task 的图相当鸡贼。。。X · 3 comentarios
- Kimi K3.1 Pro 猫榜AGENT测试出分了。。。。。。X · 3 comentarios
- Kimi K3.1 Pro vs. Opus 5.5 vs. GPT-6 AstraX · 4 comentarios
- Kimi K3.1 is basically the open-weight version of Opus 5.5 / GPT-6 Astra, but way cheaperX · 79 comentarios
- Wow.. 😲 Here's definitive results of Kimi-K3.1-Pro's offensive cybersecurity capabilities. These are black-box engagements, run on…X · 10 comentarios
- Kimi K3.1 Pro vs. DeepSeek V4.1 Flash vs. MiniMax M3.1 Flash ⚔️X · 5 comentarios
Recibe noticias como esta por push.
AI Tracker te avisa cuando algo cambia en las herramientas que usas.